| 赞 | 95 |
| VIP | |
| 好人卡 | |
| 积分 | 69 |
| 经验 | |
| 最后登录 | 2025-2-12 |
| 在线时间 | 7027 小时 |
- 梦石
- 0
- 星屑
- 6891
- 在线时间
- 7027 小时
- 注册时间
- 2013-11-2
- 回帖
- 1263
 
|
楼主 |
发表于 2016-12-31 22:53:56
|
显示全部楼层
本帖最后由 RaidenInfinity 于 2018-4-21 18:15 编辑
注意:相关知识已充足的读者们可以直接跳过第一和/或第二章。这楼的内容主要是给没接触过编程(也懒得看/看不懂预习部分提供的教程资源)的读者拓荒用。
1.1 变量赋值
展开折叠
相信大家在鼓捣RMVA的事件的时候,有见过“变量操作”这个指令。变量(variable),可以视为装数据的一个容器。
Ruby编程语言的其中一个优势,就是变量没有固定的类型。也就是说,我们在写Ruby脚本的时候,不需要特别指定这个容器要装的是数字,文字,还是其他类型的数据。
这是否常方便的,但是也代表着出现错误时,较难找出问题所在。不过,基础打稳之后,我们能尽量避免出错也能自行排除错误。
创建一个变量的时候,我们要给它取一个名字,并使用 = (赋值号)给它赋值。
[pre lang="ruby"]
a = 5
b = 6.5
c = "一二三"
p a
p b
p c
[/pre]
在运行上列代码后,在控制台内会得到下列结果:
[pre lang="ruby"]
5
6.5
"一二三"
[/pre]
变量有很多种(比如前缀@或$的),但是因为牵扯到比较深入的内容,所以第二章才会提到这个部分。
在为变量取名的时候,必须由字母或下划线(_)开头,而且里面不可以含有字母,数字和下划线以外,包括空格的符号。
[pre lang="ruby"]
a3 # -> 可以
ab123cd # -> 可以
abc_123_Def # -> 可以
1abc # -> 出错
ab%^23 # -> 出错
[/pre]
大写字母开头的变量在首次赋值之后无法再次改动(不允许用 = 来赋值),所以叫做“常量”(constant)。更进一步的说明会在第二章内提到。
1.2 基本数据类型
展开折叠
Ruby的变量主要可以用于存放几种基本数据:
1. 整数 (Fixnum)
2. 浮点数/小数 (Float)
3. 字符串 (String)
4. 符号 (Symbol)
5. 范围 (Range)
6. 布尔逻辑值 (true/false) (注:不知道布尔逻辑的话,可以去百度搜索一下)
7. 空值 (nil)
在Ruby语言,创建整数的方式有四种:十进制,二进制,十六进制,八进制。不知道什么是进制?百度搜索去呗。
一般我们写的数字都是十进制。前缀0b,0x和0分别是二进制,十六进制和八进制。某些特殊情况之下,用十六进制的方式来写数字会较容易阅读。
[pre lang="ruby"]
a = 12345 #十进制
a = 0b11000000111001 #二进制
a = 0x3039 #十六进制
a = 030071 #八进制
#以上四句的效果都是一样的
[/pre]
浮点数(小数)和整数的分别就是有无小数点。例如 a = 1 和 a = 1.0 是不一样的。这个会在基本运算的部分说到。
[pre lang="ruby"]
a = 1.0
a = 45.678
#只要有小数点,就算后面是0也都算是创建浮点数类型
[/pre]
字符串(文字)的创建方式有两种:双引号或者单引号,如"ABC"和'DEF'。两者有何不同呢?
如果使用双引号,Ruby会对字符串中的内嵌表达式(#{变量})和转义字符(如换行符\n)进行替换操作,而使用单引号的话则不会这么做。
至于用哪种比较好,是得看情况的。我个人因为其他语言的影响所以偏向双引号,但推荐的做法是除了特殊状况外尽量用单引号。
[pre lang="ruby"]
a = 66
b = "#{a}RPG"
c = '#{a}RPG'
p b #输出 -> "66RPG"
p c # 输出 -> "\#{a}RPG"
[/pre]
符号(Symbol),是Ruby的一个比较独特的数据类型。它的创建方式,就是冒号+文字(如:abc)。在RMVA脚本编辑窗里面,它会显示为橘黄色。
符号这种东西,我将它描述为“可以作为方法名字的字符串”。因为它创建的规则,和方法的名字相同(必须以字母或下划线开始等等)。
方法是啥?我们之后会提到的。方法名和变量名的区别是,问号(?)和感叹号(!)是可以使用的,但只能放在最后面。
[pre lang="ruby"]
a = :abc123 # -> 可以
a = :abc123? # -> 可以
a = :abc!123 # -> 出错,因为?或者!必须在最后面
b = :123abc # -> 出错,因为不可以用数字开头
[/pre]
范围(Range),就如其名。提供一个开始值和一个结束值(以..或者...相隔),就是它的创建方法。
[pre lang="ruby"]
a = (1..9) #1到9,包括9(1,2,3,4,5,6,7,8,9)
a = (1...9) #1到9之间,不包括9(1,2,3,4,5,6,7,8)
[/pre]
布尔逻辑值(可以理解为开关,然后布尔是人名)实际上由两种数据组成:真值(true)和假值(false)。
我知道很多“大神”又会来说什么真值假值是不同的啦什么的。但实际上,我们不需要知道这么多。
我们只需要知道true是真(理解为开启),false是假(理解为关闭)。它的用途在于条件分歧和循环的逻辑判断,我们接下来会提到。
[pre lang="ruby"]
a = true #真值 / 开启
b = false #假值 / 关闭
[/pre]
最后是空值(nil)。可以说数值不存在,也可以说没有数值。如果你时常遇到脚本出错,报错讯息里面有Nil这个字,那就是读取变量时因为某种缘故,遇到了空值。
[pre lang="ruby"]
a = nil #空值
[/pre]
1.3 基本运算法
展开折叠
在熟悉变量的赋值和数据类型后,我们来看看Ruby中的运算法,也就是加减乘除这一类的。
Ruby的运算符有很多,可以到本教程末尾的“附录”查看。在这里只会提到最基本的括号和加(+),减(-),乘(*),除(/),取余(%),乘方(**)。
我相信各位都有学过数学,知道运算的优先率(括号提升优先度,先乘方,后乘除取余,最后加减,左到右运算)。在这儿就不再提及了。
变量在赋值的时候,赋值的内容实际上是一条表达式(一组运算符,变量,或常量,最后会被运算而得到一个值),如:5, 1 + 2, a + b * 5
在第一次对一个变量赋值时是“定义”,接下来的就是“操作”了。
[pre lang="ruby"]
a = 1
b = 3 + 4
c = a + b
p a #输出:1
p b #输出:7
p c #输出:8(因为a是1,b是7,所以a + b = 1 + 7 = 8)
[/pre]
当然,有时我们会遇到需要为单个变量更改数值的情况。这时,我们可以用“自运算符”来简化。比如+=,-=,*=,/=等等。
[pre lang="ruby"]
a = a + 2
a += 2 #这是上面那句的简化版
[/pre]
上面提到的都是整数的运算法。浮点数的运算法和整数一样,但是要注意的是,整数在和浮点数一起运算时,会被转变为浮点数。
这是什么意思呢?举个例子:3 + 5.5。3是整数,5.5是浮点数。得到的答案是8.5,是浮点数。
你会提问,这有什么重要的吗?浮点数就浮点数呗。但是当你遇到除法(/)操作的时候…问题就来了。
[pre lang="ruby"]
p 5 / 2 #输出:2
p 5 / 2.0 #输出:2.5
[/pre]
从上述的例子可以看到,5除于2,两个都是整数,所以得到的答案是整数。小数的部分被省略了。
5除于2.0的情况下,因为其中一个是浮点数,所以得到的答案是浮点数,保留了小数点。
那如果你其中一个是浮点数,但是你想要整数答案怎么办?当然是把浮点数转换为整数。转换的方法我们之后会提到。
在Ruby里面,字符串能用加法以添加文本。例子:"ABC" + "DEF" = "ABCDEF"。
[pre lang="ruby"]
a = "ABC"
b = "DEF"
b += a
p a #输出:"ABC"
p b #输出:"DEFABC"
[/pre]
如果想要把整数,浮点数之类的数据作为文本加入字符串里面,怎么办?都说“作为文本“了嘛,当然有转换的方法啊。(转换法之后会提到)
1.4 方法定义与调用
展开折叠
我们知道,在控制台上显示变量存着的数据,使用的是…
[pre lang="ruby"]
p 变量名字
[/pre]
(小知识:中文字也可以当变量的名字,为啥之前不提及是因为我不推荐)
在上面列出的这行代码内,我们调用(也可以说是呼叫/使用) p 这个系统方法,而要显示的变量要作为它的参数。
方法,可以理解为一个“功能”。方法可以由系统提供,或者自己定义。我们调用方法的时候,有时候需要附上参数,也可以获得方法返回的数据。
啥?参数?返回数据?不懂啊!啊…这么说好了。假设有一个炼金术师,你给他一红一蓝两瓶药水,他帮你把这两瓶药水合起来,然后给你一瓶紫色药水…
红蓝药水是递给炼金术师(方法)的材料(参数),紫色药水就是获得的成品(返回数据)。那么,我们就直接看范例代码吧。
[pre lang="ruby"]
#方法定义
def add(a, b)
return a + b
end
#方法调用
c = add(8, 7)
p c #输出:15
[/pre]
从上面的范例代码我们可以看到,定义一个方法的格式是:
[pre lang="ruby"]
def 名字(参数)
内容
end
[/pre]
def 是 define(定义)的缩写。它是一个关键词(keyword),在RMVA脚本编辑器内会显示为蓝色。
end 也是一个关键词,带结束的意思。一个def要配一个end,不然运行游戏时会报错(语法错误SyntaxError)。
那么 def 的后面,就是方法的名字了。方法的命名规则与变量相似,然后建议用有意义的名字,最好不要用乱七八糟的东西来取名(变量也是啊!),以免阅读困难。
问号(?)和叹号(!)可以用在方法名字的最后面(比如abc?和cde!)。这两个符号一般用来描述某种性质的方法(比较容易认得)。
一般问号(?)用于描述判断方法(返回true/false),而叹号(!)用于描述毁灭性方法。
什么是毁灭性方法?电脑爆炸?不。我们会在之后的“系统方法”部分认识到一些后缀叹号(!)的方法,了解它与没有后缀的版本的分别。
在名字后面,括号里面的就是参数了。在Ruby语言内,参数是选择性的。就连包着它的括号也是选择性的!例如:
[pre lang="ruby"]
#没有括号包着参数的方法定义
def add a, b
return a + b
end
#没有括号包住参数的方法调用
c = add 8, 7
p c #输出:15
[/pre]
不过为了美观和可读性…还是加吧。由此可见,p c 和 p(c)是一样的。但是因为我个人的习惯,我选择不用括号包着p的参数。
这个要看个人品味和习惯。当然,如果这是要写给别人看的…我感觉还是正式一点比较好,尽量写得易懂,一目了然。
参数代入方法内,就成了局部变量(local variable,可以理解为暂时的变量)。
所以范例里面,定义了参数a和b(注:多个参数请用逗号(,)隔开)后,在方法里面可以自由使用a和b来做一系列的运算。
return 这个关键词的意思是返回。不管放在哪儿,只要运行到这一行,就会强制结束方法的运行,并把return后面的表达式所计算出来的值递回去。
如果return的后面没有表达式(单独的一个字),那么系统会默认返回空值(nil)。一些系统提供的方法在操作失败时也会返回空值,是要注意的地方。
RMVA默认脚本的一些方法没有return。这是为什么呢?那是因为,在Ruby语言,方法会自动将end前面所执行的那一句表达式得出来的值作为返回数据。
意思就是说,我们这么写是可以的:
[pre lang="ruby"]
#没有return的方法定义
def add (a, b)
a + b
end
[/pre]
不过这也要看个人风格。为啥RMVA默认脚本有些方法最后面有return,有些则没有,明明都是差不多的东西呢…这你得自己去问开发人员,他想的是什么。
另外这里也要提到的就是分号(;)在Ruby语言里面的作用。有用过C/C++/C#/Java的就会知道,分号否常重要,是语句的终止符。(语句的意思:交给程序运行的一行指令)
在Ruby里面,仅是换行就能结束语句了。分号在Ruby语言的用途是作为分隔符,用它可以将数行代码浓缩成一行。
例如我们可以基于上面的例子改一改:
[pre lang="ruby"]
#没有return的方法定义,用分号浓缩成一行
def add (a, b); a + b end
[/pre]
一些地方不需要分号(比如end前面)就能并入上一行了。这个就留给各位自己摸索吧。
一般是不建议用分号来减少行数的。不过如果真的有需要的话(RMVA默认脚本中,可以在Game_BattlerBase里见到这种情况),那就用吧。
说完方法的定义,现在就要来说方法的调用了。
方法的调用格式是:名字(参数) (括号可以省略掉,多个参数要用逗号(,)分隔)如果该方法不需要参数,直接写名字就行了。
递入的参数数量必须和方法所需要的参数数量相符,否则会报错(参数错误ArgumentError)。
递入参数的时候,是写一个表达式,然后传给方法的是表达式所计算出来的值。
如果你已经忘掉了什么是表达式…再复习一下吧。表达式是一组运算符,变量,或常量,最后会被运算而得到一个值。
表达式里面可是包括调用的方法所返回的值的哟!下面是各种调用方法的例子(方法还是之前那个):
[pre lang="ruby"]
#定义变量
x = 5
y = 6
z = 7
#定义方法
def add (a, b); a + b end
#方法调用
p add(1,2) #输出:3
p add(1 + 2,3) #输出:6
p add(x,y) #输出:11,因为x = 5,y = 6,所以x + y = 11
p add(add(x,y + 4) + 2,z) #输出:24,因为add(x,y + 4)得出15,然后add(15 + 2,z)得出24
[/pre]
不过,RMVA默认脚本里面的一些方法(尤其是Window_Base的)调用的时候可以递入不同数量的参数。有时3个,有时4个,如此的。
在Ruby里面,我们可以在方法内定义默认参数。来个例子:
[pre lang="ruby"]
#可以接受2到4个参数的加法运算方法
def add(a, b, c = 0, d = 0)
a + b + c + d
end
[/pre]
从上面的例子我们可以看到,c和d这两个参数,默认数值为0。如果调用这个方法时没有附上第三或第四个参数,那么默认值就会生效。
[pre lang="ruby"]
#方法定义
def add(a, b, c = 0, d = 0); a + b + c + d end
#方法调用
p add(1,2) #输出:3
p add(1,2,3) #输出:6
p add(1,2,3,4) #输出:10
[/pre]
如果递入的参数少于2或大于4的话,就会报错。还有就是,默认参数只能放在参数列表的后面,不管有几个。
人呢,总会有天马行空的各种想法。如果我不知道我最多会放入多少个参数,怎么办?可能是5个,可能是10个,也可能无上限…
这是有办法的。但是因为牵扯到“数组”这玩意儿,所以这个我们之后有机会提到。
那么我们已经知道了如何自定义一个方法,也知道了如何去调用它。但是这只是冰山一角。
Ruby的系统提供了很多核心方法。每种基本数据有它自己的一套默认方法。详细理论本教程第二章才会深入,所以此时此刻,当做一个现象就好。
比如之前所提到的数据类型转换,是数据类型本身附带的方法。除此之外,整数有绝对值,浮点数有取整,字符串有文本替换…
调用这种方法的方式,是在数据(不管是变量,常量还是直接创建)的后面加上句号(.),然后写上方法的名字和代入参数。
[pre lang="ruby"]
a = 5
b = 2.0
c = "ABC"
p "123".to_i #输出:123(没有引号),因为使用to_i转换为整数
p 5.to_s #输出:"5"(有引号),因为使用to_s转换为字符串
p (-6).abs #输出:6 ,因为使用abs取绝对值
p (45.789).ceil #输出:46 ,因为使用ceil向上取整
p a / b.to_i #输出:2 ,不是2.5,因为使用to_i将浮点数转换成整数类型了
p c + a.to_s #输出:"ABC5" ,如果没有用to_s会因为运算时数据类型不相配而报错
[/pre]
某些系统方法可以直接调用,比如p是在控制台显示数据,rand是获取随机数。
但是一些方法则是被包在“模块”里面的(模块在第二章会解说),比如系统提供的三角函数方法,被包在命名为Math(意思是数学)的模块里面了。
[pre lang="ruby"]
#注:下列的三角函数方法参数单位是弧度而不是角度
p Math.sin(0.5) #输出:0.479425538604203
p Math.cos(1.55) #输出: 0.020794827803092428
p Math.tan(0.87) #输出:1.1853248603008053
[/pre]
Ruby所提供的核心方法为我们带来了很多便利。这些方法将在本章的末尾简略地介绍。
1.5 流程控制
展开折叠
我们使用RMVA的事件系统时,有时会用到“条件分歧”和“循环”这两个指令。
“条件分歧”就是判断一个情况是否成立,是的话做些什么,否的话做些什么。
“循环”则是重复地运行特定的一些指令,直到使用“跳出循环”
这些控制指令运行的方式,叫做“流程控制”。
不过上述的这些只是皮毛。如果只用事件指令,遇到一些比较复杂的流程时,会导致事件页略显紊乱而且也难以追溯。
Ruby脚本的流程控制语法可说是比较“人性化”的,也较接近人类的语言(主要是英文,不过也没差)。
本教程会将流程控制分成逻辑判断,条件分歧,抓错机制,循环,迭代这五个主要部分来讲解。
A - 逻辑判断
在制作游戏流程的时候,我们常常会需要用到比较运算。判断金钱是否超过5000啊,背包有没有带着通行证啊,密码锁输入的数字是否等于8010啊,之类的情况。
我们用六种主要的比较运算符:等于(==),不等于(!=),小于(<),大于(>),小于或等于(<=),大于或等于(>=)来判断左右两个值之间的关系是否成立。
(注意:值指的是表达式运算完毕后得到的值,也就是 a + b == c + d 这样的语句是可以用的)
这种运算最后会得出一个值,也就是真值(true)或者假值(false)。这两个值统称布尔逻辑值(boolean value),是一种基本数据类型。
假设我们有一个变量a,这个变量里面存着整数4。(a = 4)
[pre lang="ruby"]
#变量赋值
a = 4
#比较运算(注意:true是真值/是,false是假值/否)
p (a == 4) #输出: true #判断a存着的值是否等于4
p (a != 4) #输出:false #判断a存着的值是否不等于4
p (a < 4) #输出:false #判断a存着的值是否小于4
p (a > 4) #输出:false #判断a存着的值是否大于4
p (a <= 4) #输出:true #判断a存着的值是否等于或小于4
p (a >= 4) #输出:true #判断a存着的值是否等于或大于4
[/pre]
当然因为最后计算处理的是一个值,我们可以把它存在一个变量里面待用。
上述的例子是关于整数和浮点数的比较运算。不同类型的基本数据的默认比较运算法可能会不同。
不过,大部分基本数据(如字符串,符号)的等于(==)和不等于(!=)操作的用途就如其名,没有其他特定条件。
很多时候,我们不只是需要一个比较运算。我们可能需要判断角色A在队伍内的同时,金钱超过一定的数量。我们也可能要判定玩家是否拥有两种物品之中的其中一种。
在这种情况下,我们有逻辑运算符(也称逻辑联结符),就像加法或者乘法那样把数个布尔逻辑值通过运算整合成一个值。
我们有三种逻辑运算符:否(!),或(||),和(&&)。!等于反转,||等于加法,&&等于乘法。
否(!),简单来说就是反转逻辑值。true变成false,false变成true。很简单,对吧?就像不等于的符号是!=那样。
[pre lang="ruby"]
a = true
b = false
p !a #输出:false(因为 !true = false)
p !b #输出:true (因为 !false = true)
[/pre]
或(||)是逻辑运算的加法。如果把true(真值)比喻作1,而false(假值)比喻作0,那么:
[pre lang="ruby"]
#注:这不是可运行的代码
0 + 0 = 0 (所以false || false 将得到 false)
0 + 1 = 1 (所以false || true 将得到 true)
1 + 0 = 1 (所以true || false 将得到 true)
1 + 1 = 1 (所以true || true 将得到 true)
[/pre]
注意:1 + 1 = 1 是因为布尔逻辑值只有1(true)和0(false),所以只要不是0(false)的都是1(true)。
因此,只要其中一个布尔逻辑值为真值(true),那么得到的结果必定是真值(true)。毕竟是“或者”嘛。
在Ruby语言里面,||的运算进行的时候,只要左边的值为真,那么右边的表达式就不会再执行了。这个现象被称为“短路”。
和(&&)是逻辑运算的乘法。只有两边都是真值(true)时,结果才能是真值(true)。
[pre lang="ruby"]
#注:这不是可运行的代码
0 * 0 = 0 (所以false && false 将得到 false)
0 * 1 = 0 (所以false && true 将得到 false)
1 * 0 = 0 (所以true && false 将得到 false)
1 * 1 = 1 (所以true && true 将得到 true)
[/pre]
&&的运算进行的时候,只要左边的值为假,那么右边的表达式就不会再执行了,毕竟已经没必要了。
以上提到的三种逻辑运算符就和基本运算法那样,可以混合成表达式。
不过要注意的一件事就是,和(&&)算是乘法,所以执行的优先度会凌驾于算加法的或(||)。否(!)当然是排最前面了。
在写逻辑运算的表达式时,请务必善用括号,以免出现优先度的问题,而且要顾虑到可读性。
[pre lang="ruby"]
#变量赋值
a = 5
b = 6
c = 7
d = 8
#逻辑表达式
p (a + 2 < 6 || c == 7) #输出:true ,因为左边运算后得出false,右边运算后得出true(false || true = true)
p (c != 8 && !(a == 6)) #输出:true ,因为左边运算后得出true,右边运算后得出false但是被反转成true (true && true = true)
p (a > 7 || c < d && d == b - 2) #输出:false ,原因是表达式计算完毕后是false || true && false
#而因为&&凌驾于||所以: false || (true && false) = false || false = false
[/pre]
嘛,为了自己和他人的眼睛,能加括号的地方尽量加括号吧。实际上最外层那层括号是不需要加的,但是为了美观所以我加上去了。
(注意:运算符||和&&在对非布尔逻辑值使用的时候有别的效果,这个在第二章才会提及)
Ruby是很人性化的语言。实际上,它准备了三个关键词:not, or 和 and,与!,||和&&符号相对应。
不过,我否常不建议使用关键词来代替符号,因为它们的执行优先度会比符号版本的还低很多。
最后一个要介绍的符号,“联合比较运算符”(<=>),英文叫spaceship operator,直译是宇宙飞船运算符(可能是因为样子…很像?)。
你看到这符号的第一个反应会是:这啥啊?小于等于大于?你没猜错,它是三合一的,非常特别的运算符。请直接看例子吧。
[pre lang="ruby"]
#变量赋值
a = 6
b = 6
c = 5
d = 7
#联合比较运算
p a <=> b #输出:0 ,因为左边和右边一样
p a <=> c #输出:1 ,因为左边大于右边
p a <=> d #输出:-1 ,因为左边小于右边
[/pre]
如上面的例子所示,<=> 这个符号会根据左右两边的值之间的关系,得出1,0或者-1这三种结果。(0 等于,1 大于,-1 小于)
不过,如果两边的值无法被比较(比如你拿字符串来和整数比),就会得到nil(空值),表示运算失败。
B - 条件分歧
假设我们需要执行如此情况的流程:如果玩家的平均队伍等级是10以上,就允许通过,否则就不允许通过。
以上的例子要用脚本实现的话,我们会用到[b]if(如果),else(不然/否则)和end(结束)这三个关键词。
[pre lang="ruby"]
if 玩家的平均队伍等级是10以上
允许通过
else
不允许通过
end
[/pre]
玩过RMVA事件的各位应该挺熟悉这个架构。不过,脚本多了数个条件分歧的功能,是事件所缺少的。
在Ruby语言里,if的判断通过条件是:不是false(假值)或者nil(空值)。
也就是说,不管是什么数据作为if的判断条件,只要不是false或者nil,就会通过。
因此,if除了拿来检测真假(true/false)之外,还用来检测是否空值(nil)。
这个特性会在第二章内,提到空值时再进一步说明用法。
现在我们来说说elsif(不然如果)这个关键词。elsif,很明显是else(不然)和if(如果)的混合体。
(小知识:在C++和Java等编程语言里面,else if这两个字是分开写的。)
假设我们有如此的代码:
[pre lang="ruby"]
if a == 5
p "五"
else
if a == 6
p "六"
else
if a == 7
p "七"
else
p "???"
end
end
end
[/pre]
这是什么鬼?为啥那么乱?很好,这不就是用事件条件分歧指令时常见的事吗?
那么我们把上面的这段代码,善用用elsif来整理一下。
[pre lang="ruby"]
if a == 5
p "五"
elsif a == 6
p "六"
elsif a == 7
p "七"
else
p "???"
end
[/pre]
嘿,是不是整洁多了呢?效果当然还是一样的啊。除此之外也要记得一件事情。
在一个if到end的代码段里面(不管里面有没有elsif或者/和else),只要有其中一个判断通过了,就会在执行结果之后跳到end处,结束流程。
Ruby语言提供了另一个关键词,叫做unless(除非)。它是if的相反,也就是说:
[pre lang="ruby"]
if !(a == 1)
p "测试文字"
end
#和
unless a == 1
p "测试文字"
end
#的效果是一样的。
[/pre]
unless不能配上elsif用,虽然可以配着else。可读性…则是一个巨大的问题。
因此,我个人不推荐使用这个关键词,因为if已经非常非常足够了。加个!来执行判定反转也不是什么难事。
当然你坚持一定要用的话,我是建议别配着else。
Ruby异于其他编程语言的一个特征,就是提供了条件分歧的倒装句。什么意思呢?
我们可以把上面的例子再简化成:
[pre lang="ruby"]
p "测试文字" if !(a == 1)
p "测试文字" unless a == 1
[/pre]
执行内容在左边,条件在右边。这叫做“倒装”。我个人认为这是一种救赎啊…会上瘾的!
这种形式的条件分歧的只能容纳一句执行内容,所以如果需要超过一句的,还是用正规的吧。
实际上倒装句与英文文法比较相似,而我们博大精深的中文的话,是与正规的条件分歧相似也比较易于理解。
代码嘛,当然是越简单越好。但是呢,Ruby毕竟是人性化的语言,所以它准备了很多特殊的关键词来表现这一点。
then(那就)是其中一个“比较多余”的关键词,因为有没有都没差。
如果我们不要用倒装句的话,要怎么把一个简短的条件分歧缩成一行啊?来看例子。
[pre lang="ruby"]
#用分号的版本
if !(a == 1); p "测试文字" end
unless a == 1; p "测试文字" end
#用then的版本
if !(a == 1) then p "测试文字" end
unless a == 1 then p "测试文字" end
[/pre]
好,then(那就)的用处非常明显了吧?如果a不等于1,那就显示“测试文字”这个字符串。真是直白啊。
要不要用then,要不要用倒装句,那全是个人的习惯和风格。这个,谁也管不着(拿着带刺铁棍的制作组员那是另一回事)。
我们介绍过许多种比较运算符。连奇怪的<=>(联合比较运算)都跑出来了。
现在我们要介绍一个也是挺奇葩(和很少用到),但是不得不知道的是“特殊等于测试符”(===,下称三等号)。
我去,=是赋值,==是等于,===是什么鬼玩意儿?在Ruby里面,在不同的情况下它有不同的用处。
为什么要提这个?这是因为Ruby有一个条件分歧操作是基于这个符号的。
三等号(===)一般来说和等于符(==)一样。不过,它的实际功能随着数据类型而改变。
在这章里我们会提到三等号判断范围是否包含整数的功能。(如果左边的类型是范围,判断左边是否包含右边)
假设我们有一个范围,1..15(1到15之间,包含15):
[pre lang="ruby"]
#使用等于符
p (1..15) == 7 #输出: false,因为范围和整数无法对等
p 13 == (1..15) #输出:false,因为整数和范围无法对等
#使用三等号
p (1..15) === 7 #输出:true,因为1到15之间包含7
p 13 === (1..15) #输出:false,因为范围必须在左边才行
[/pre]
那么基于这个功能,我们来写一段代码,判定下面的这个情况。
我们要判定a(里面存着的值)是否在(1..15)里,等于17,等于20,或是在(22...33)之间,和除此之外的时候,然后显示一段文字。
[pre lang="ruby"]
#变量赋值
a = 24
#条件分歧
if (1..15) === a
p "a在1..15的范围里"
elsif 17 === a
p "a等于17"
elsif 20 === a
p "a等于20"
elsif (22...33) === a
p "a在22和33之间"
else
p "a不符合以上的所有条件"
end
#运行后输出:"a在22和33之间"
[/pre]
上面的这个例子,在Ruby语言里可以再简化,用case(事例)和when(等于时)关键词。
[pre lang="ruby"]
#变量赋值
a = 24
#条件分歧
case a
when (1..15)
p "a在1..15的范围里"
when 17
p "a等于17"
when 20
p "a等于20"
when (22...33)
p "a在22和33之间"
else
p "a不符合以上的所有条件"
end
#运行后输出:"a在22和33之间"
[/pre]
注意:Ruby的case在条件判定成功后会自动退出(break),不像C/C++那样如果不加break就会继续运行来判定下一个条件。
当然,在遇到下一个when或者else或者end之前,是可以放复数的执行内容的。
如果执行内容只有一行的话,也可以用then或者分号来缩短成每个when为一行。
这是非常方便的。再给个常见的例子吧。
[pre lang="ruby"]
#使用if的写法
if 1 === a #注意:在这里和if a == 1是一样的
p "a 等于 1"
elsif 2 === a
p "a 等于 2"
elsif 3 === a
p "a 等于 3"
end
#使用case的写法,以分号来缩短
case a
when 1; p "a 等于 1"
when 2; p "a 等于 2"
when 3; p "a 等于 3"
end
[/pre]
非常整洁,对吧?这就是Ruby语言的魅力所在啊!
在阅读RMVA默认脚本的时候,我们可能会看到一种非常奇怪的运算符:问号(?),后面还会跟着一个冒号(:)。
这个运作符叫“条件表达符”,由问号(?)和冒号(:)组成,是一个非常精简的运作符,就像一个小型的if...else...end组合。
[pre lang="ruby"]
#变量赋值
a = true
c = 5
#使用if-else-end组合
if a
b = c + 1
else
b = 10
end
#使用条件表达符
b = (a ? c + 1 : 10)
[/pre]
?左边的表达式是条件。如果条件判断通过,那么:的左边所计算出来的值将被取用,否则取用:的右边。
因此格式是:条件 ? 成功 : 失败。使用条件表达符时,建议使用扩号包起来,以增添可读性。
C - 抓错机制
我们运行脚本时,常常遇到很多错误。什么除于零啦,读取存档时找不到文件啦,之类的。
虽然完善的条件分歧判断机制可以避免出现错误,但是总会有漏网之鱼。
而且,每次报了一个错,整个程序就会关闭,又要重开又要重玩重测啊…真是麻烦又扰民啊对吧。
因此,Ruby语言准备了一套抓错机制,由begin(开始), rescue(拯救), ensure(确保)和喜闻乐见的end组成。
(注意:begin在循环的部分有别的用途,所以这里只说它与rescue或/和ensure配合时的功能。
假设我们有两个变量,a和b,而我们要将它们相除。
[pre lang="ruby"]
a = 5
b = 0
p (a / b) #报错: (整数)除于零
[/pre]
当然,我们的确已经预料到了,b = 0会导致a / b的操作报错。因此我们可以用if条件分歧来处理这种问题:
[pre lang="ruby"]
a = 5
b = 0
if b == 0
p "运算错误!"
else
p (a / b)
end
#输出:"运算错误!"
[/pre]
然而这些需要预判。如果预料到这段代码发生的错误实在是太随机太蛋疼了,那就需要用到抓错机制了。
抓错机制的格式主要是:begin 执行代码 rescue 补救代码 end
改写上面的例子的话:
[pre lang="ruby"]
a = 5
b = 0
begin
p (a / b)
rescue
p "运算错误!"
end
#输出:"运算错误!"
[/pre]
rescue实际上还可以截取错误数据(就是原本报错弹窗的时候显示出来的),但是在这儿就不多做介绍了,可以自己科普学习。
在rescue的后面加上 => 就可以指定一个获取错误数据的变量。在rescue和=>之间可以指定截取错误数据的类型。
在这个情况之下,执行代码如果出现错误,不会弹窗报错然后游戏关闭,而是执行补救代码。
在RMVA默认脚本内,抓错机制实际运用的地方是DataManager模块里的,关于存档和读档的方法。
如果存档或读档失败,你会听到“哔哔”的提示音效。这就是抓错机制在奏效了。
当然,玩Ruby呢,肯定要知道的是…有好多好多的方法可以浓缩代码啊啊啊!什么都缩成一行啊!
于是如果执行代码和补救代码都只有一行,上面的例子又可以写成:
[pre lang="ruby"]
a = 5
b = 0
p (a / b) rescue p "运算错误!"
#输出:"运算错误!"
[/pre]
格式是: 执行代码 rescue 补救代码
说完rescue,现在来说说ensure。这个关键词在RMVA默认脚本中没有用到,但还是介绍一下好了。
ensure的意思是“确保”,也就是说,不管天灾人祸地震核爆也好,这段代码都要执行啊。
因为RMVA默认脚本里面没有用到的关系,所以我只用它一般使用的地方来说。
假设我们要打开一个文件,处理一些数据,然后关闭文件。但是处理数据的时候可能会出事报错!
报错之后,文件开了没关,会发生什么事情我是不知道啦(因为我没干过这种事),也许你可以去研究一下。
因此,我们需要一个就算报错(没有用rescue的情况)也会执行的代码段来运行关闭文件的语句。
在这里因为文件操作是挺复杂的(本教程会在偏后期的地方说到),所以目前只以文字来代替。
[pre lang="ruby"]
#没有rescue的情况
begin
打开文件
处理数据
ensure
关闭文件 if 文件已打开
end
#有rescue的情况
begin
打开文件
处理数据
rescue
补救代码(比如显示错误讯息)
ensure
关闭文件 if 文件已打开
end
[/pre]
不过实际上,大部分情况之下,是不需要ensure的。在这里介绍它只是为了…完整性。
我们现在知道了,如果执行代码失败了,会触发rescue后边的补救代码。如果成功而不是失败呢?那就用else。
[pre lang="ruby"]
begin
执行代码
rescue
补救代码(失败后执行)
else
成功后执行的代码
ensure
必须执行的代码
end
[/pre]
如果有重试的需求的话,Ruby语言准备了一个关键词:retry (重试),来重新运行执行代码。
一般它是在补救代码里面,在做调整之后重新运行执行代码。
[pre lang="ruby"]
begin
执行代码
rescue
补救/调整
retry #重新运行一直到没出错为止
end
[/pre]
当然你需要用条件分歧来操纵重试的次数,不然上面这个例子如果一直出错的话可是会无限循环卡死的啊…
retry在接下来的“迭代”部分里面也起着作用。
D - 循环
循环,就是在某个条件成立的前提之下,重复相同的代码。如果没有条件,那就是无限循环(如RMVA事件系统的循环指令)。
Ruby语言提供了两个主要的循环语句,也就是while(正在)和until(直到)。
while和until的分别和if(如果)与unless(除非)一样。后者是前者条件的相反(until a 和 while !a 一样)。
它们的条件判定法也和if/unless的一样,都是见到false(假值)或者nil(真值)则不通过检测,不然就通过。
假设我们要定义一个循环,运行时将变量a的值增加1(a += 1)并显示此时a的值,而循环条件是a小过10。(a初始时是7)
[pre lang="ruby"]
a = 7
while a < 10
a += 1
p a
end
#输出:
8
9
10
[/pre]
我们可以看到的是,循环刚开始的时候,会先判断条件(a < 10)是否通过。当时a的值是7,所以通过了。
那么这个循环在完成一次的运行之后,a的值是8。这时,条件判断将再次进行。通过了吗?通过了。
所以就这样一直循环,直到a的值成了10。条件判断失败了,因为要求是a小于10,而a已经是10了。
条件判断不通过的话,循环将会中断,不会再继续了。
在上一个部分有提到过,begin(开始)这个关键词在循环中也有用到,就是创建条件后置的循环。
让我们比较一下条件前置循环和条件后置循环的格式:
[pre lang="ruby"]
#条件前置
while 条件 #或者 until 条件
执行代码
end
#条件后置
begin
执行代码
end while 条件 #或者end until 条件
[/pre]
条件判断放在前面和后面有什么差别呢?条件放在后面的话,就算打从一开始条件就不符合,代码还是会执行至少一次。
条件放在前面的话,当然如果条件一开始就不符合了,这循环就根本不运行。
还记得then(那就)这个关键词,还有 if/unless ... then ... end 这个格式吗?
喜闻乐见的是,while/until则有do(做)这个关键词作为修饰。while/until ... do ... end 是它的格式。
[pre lang="ruby"]
#普通的循环
while a < 10
a += 1
end
until a >= 10 #注意:< 和 >= 是相反的,就如 > 和 <=
a += 1
end
#用do修饰,然后缩成一行
while a < 10 do a += 1 end
until a >= 10 do a += 1 end
[/pre]
还记得倒装if/unless吗?等等…为啥总提if/unless?那当然是while/until有相似的写法啦!喜闻乐见的倒装!
[pre lang="ruby"]
#普通的循环
while a < 10
a += 1
end
until a >= 10
a += 1
end
#倒装的循环
a += 1 while a < 10
a += 1 until a >= 10
[/pre]
嗯,你问我如何写无限循环?说真的,只要让循环的条件永远通过就行了啊!我的习惯则是用while true
[pre lang="ruby"]
while true
无限循环的内容
end
[/pre]
啥,你又问,无限循环的话游戏不就卡死了吗?要来做啥啊?非常好,还记得RMVA里面的“跳出循环”事件指令吗?
Ruby语言提供了两个在循环内部进行流程操纵的关键词,break(跳出),next(下一个)和redo(重来)。
作为范例,我把之前那个例子改写成使用break来跳出的无限循环:
[pre lang="ruby"]
#条件前置
while true
break if a >= 10 #或者break unless a < 10
a += 1
end
#条件后置
while true
a += 1
break if a >= 10 #或者break unless a < 10
end
[/pre]
除了用这种方式结束循环之外,(在方法内)使用return(返回)操作也会直接结束循环然后返回数据。
next(下一个)和redo(重来)的用途是跳过此次未执行的代码,然后重头开始循环。
next和redo的分别是,next需要再次通过条件判断,而redo不需要。
假设我们有如此的代码:(redo使用的情况非常稀有,而且RMVA默认脚本也没有用到,因此不提供使用范例)
[pre lang="ruby"]
a = 0
while a < 10
a += 1
next if a % 2 == 0 #判断是否偶数
p a
end
#输出:
1
3
5
7
9
[/pre]
很明显,如果a是偶数,就会直接跳过未执行的代码(显示数据),然后重新回到上边,执行条件判断。
E - 迭代
在写脚本的时候,我们常需要固定次数的循环,并按照循环的次数来执行特定的操作。
[pre lang="ruby"]
i = 0 #初始值
while i < 5 #脱出循环的条件
p i #执行操作:显示变量
i += 1 #增加次数
end
#输出:
0
1
2
3
4
[/pre]
当然,聪明的你已经猜到为什么在这儿又列出一次while循环了。当然是有更短更简便的方法啊!
迭代,是程序中对一组指令(或一定步骤)的重复,也可以用来描述一种特定形式的具有可变状态的重复。
在上面的例子中,你可以看到,变量i的值每次重复运行时都会改变(因为i += 1)。这就成了一种迭代。
(注意:我的习惯是用于迭代的变量以i,j,k为主)
Ruby提供了很多种类型的“迭代器”,也就是用于进行迭代的方法。
如果你们曾经学过C,C++,Java等语言,应该会对for这个关键词不陌生。不过在Ruby,这可是禁止事项。
不是Ruby没有for关键词,而是有太多太多种方法可以取代它的存在了。
嗯,你还是新手,不知道什么是for?那不需要管这个,我们继续说“迭代器”。
在Ruby语言中,有非常多种方法可以进行迭代。就像上面那个例子,我们可以这么写:
[pre lang="ruby"]
5.times do |i|
p i
end
[/pre]
当然也可以这么写:
[pre lang="ruby"]
0.upto(4) do |i| #注:5 - 1 = 4
p i
end
[/pre]
还有这么写:
[pre lang="ruby"]
(0...5).each do |i|
p i
end
[/pre]
更可以这么写:
[pre lang="ruby"]
(0...5).step(1) do |i|
p i
end
[/pre]
如果我们要倒数进行迭代的话,用while来达成的话是:
[pre lang="ruby"]
i = 4 #初始值,注意 5 - 1 = 4
while i >= 0 #脱出循环的条件
p i #执行操作:显示变量
i -= 1 #增加次数
end
#输出:
4
3
2
1
0
[/pre]
而使用迭代器的方式是:
[pre lang="ruby"]
4.downto(0) do |i|
p i
end
[/pre]
上面列出了五种我们在这部分会介绍的迭代器,也就是数字的times, upto, downto方法,和范围的each, step方法。
每种迭代器都有它自己的用途和适合应用的情况。不过,我们先来说说代码块(code block)这件事。
代码块,是上面的例子中,do到end之间的部分。这是Ruby强大的特性之一,能把代码作为参数传递给方法。
代码块中也可以附上参数(被两个"|"符号夹着,如果需要超过一个就用逗号(,)分隔),储存迭代的状态数据。
在这儿,我们不需要知道代码块和迭代器背后的原理,只需要知道怎么去运用它就行。
当然,Ruby代码有很多很多种写法,这个我们在之前的部分已经体验过了。什么倒装句之类的。
那么在Ruby里面,我们可以而已用{和}符号来代替do和end。
[pre lang="ruby"]
#使用do和end
5.times do |i| p i end
#使用{和}
5.times {|i| p i }
[/pre]
当然我自己的习惯是用后者({}),毕竟我有被其他编程语言影响到。
不过为了可读性,我建议在要缩成一行的时候使用后者(范例中的状况),否者使用前者。
接下来进入正题。首先要介绍的是数字的times迭代器。它的用途是从0开始,迭代到该数字减1的次数。
这等于状态的初始值是0,而循环结束的条件是:状态 < 数字。
[pre lang="ruby"]
3.times do |i|
p i
end
#输出:
0
1
2
[/pre]
不过要注意的是,如果是基于浮点数(如3.5)来调用times,和下面会介绍到的upto和downto的话,会先向下取整成整数。
接下来介绍upto和downto这两个迭代器。upto有“上升直到”而downto有“下降直到”的意思。
upto和downto是从指定的初始值(数字),向上(upto)或向下(downto)迭代到递入的参数为止(包括该参数)。
[pre lang="ruby"]
#使用upto,迭代范围:2到5(包括5)
2.upto(5) do |i|
p i
end
#输出:
2
3
4
5
#使用downto,迭代范围:从4到1(包括1)
4.downto(1) do |i|
p i
end
#输出:
4
3
2
1
[/pre]
有些人会问,哎呀,我需要比较直观一点的,可以直接看出迭代范围的方法,怎么办?答案就是基于范围的迭代器。
首先,我们有each(每个)方法。比如我们有一个范围是… 1..4(1到4,包括4):
[pre lang="ruby"]
(1..4).each do |i|
p i
end
#输出:
1
2
3
4
[/pre]
于是我们可以看到,(1..4).each 和 1.upto(4) 的效果是一样的。注意:含有浮点数的范围不能使用迭代器。
范围数据类型的两个点(..)和三个点(...),还记得分别是什么吗?
复习一下吧。它们的分别是,两个点是包括后面的数,三个点是不包括。
那么也就是说,(1...4).each 和 1.upto(4-1)是同样的效果,而(0...5).each 和 5.times 是同样的效果。
以上提到的四种迭代法,都是一步一步迭代的。有些是往上(数字的times和upto, 范围的each),有些是往下(数字的downto)。
如果每次要增加两步或者更多,要怎么办?范围提供了一个迭代器,叫做step(步行),也就是指定迭代时增加的“步数”(默认参数是1)。
假设我们有一个范围是1..10,而我们要迭代…每次3步。
[pre lang="ruby"]
(1..10).step(3) do |i|
p i
end
#输出:
1
4
7
10
[/pre]
注意:最低步数是1,递入负数会报错
知道了这些写迭代的方法后,你应该知道为啥for关键词在Ruby里面的使用是被评击的吧。
啥,你是新手,没用过其他程序语言,还不知道什么是for?非常好,让我们来看看这是什么玩意儿。
for(迭代/对于)在这里是配着in(里面)用的。在Ruby里,for循环的格式是:
[pre lang="ruby"]
for 状态变量 in 范围 do #注意:do 是选择性的,就会while循环差不多
执行代码
end
[/pre]
给个例子:
[pre lang="ruby"]
for i in (1..4)
p i
end
#输出:
1
2
3
4
[/pre]
嗯,你应该是发现到了。这代码怎么和之前我们提到的,范围的each那么相似?答对了,它们是相等的!
因此,我不建议使用for这个关键词,而是调用迭代方法,递入代码块来进行迭代(就像上面的各种例子)。
比较一下RMXP和RMVA的默认脚本的话,RMVA的默认脚本已经没有使用for了,可以看得出成长。
还记得之前在“循环”的部分学到的,break(跳出), next(下一个) 和 redo(重来) 这三个关键词吗?
它们在迭代里面起到一样的作用,所以就不再多做说明了。
那么之前在“除错机制”部分有提到过,retry(重试)这个关键词在迭代中有起到作用。
retry的用途就是从头开始执行迭代,也就是重置初始值。
[pre lang="ruby"]
3.times do |i|
p i
retry if i == 2
end
#输出:
0
1
2
0
1
2
…(然后就无限循环了)
[/pre]
当然有没有机会在迭代里用到retry也是一个问题,就看看就好吧。
1.6 数组与哈希表
展开折叠
在编写游戏脚本的时候,我们常需要非常多的变量。一个角色,就有体力啊魔力啊攻击啊什么的。
那么要如何更有效地管理这些数据,是一种学问。对此,Ruby提供了两种“数据容器”,也就是数组(Array)和哈希表(Hash)。
A - 数组
数组(Array),可以理解为“数据的组合”。百度百科:数组是相同数据类型的元素按一定顺序排列的集合。
不过在Ruby语言里面,数组内的元素可以是任何类型,不管是整数,字符串,符号,甚至是数组本身。
RMVA默认脚本中使用数组的幅度非常大。队伍内的角色,角色的装备,窗口上显示的指令列表等等。
创建数组的方式有数种。第一种就是直接赋值。格式是:[数组内容] (如果有多于一个元素,就用逗号(,)来分隔)
[pre lang="ruby"]
#创建一个含有整数1,2,3,4,5的数组
arr = [1,2,3,4,5]
#创建一个含有字符串"abc","cde","efg"的数组
arr2 = ["abc","cde","efg"]
#创建一个整数和字符串都有的数组
arr3 = [1,"abc",2,"cde",3,4,5,"efg"]
#创建什么都没有的空数组
arr4 = []
#显示数据
p arr #输出:[1,2,3,4,5]
p arr2 #输出:["abc","cde","efg"]
p arr3 #输出:[1,"abc",2,"cde",3,4,5,"efg"]
p arr4 #输出:[]
[/pre]
注:我的习惯是以arr(Array的缩写)来作为数组的暂时变量名
放入数组的内容实际上是表达式。也就说我们可以当场运算了数值后放进数组中。
[pre lang="ruby"]
#加法的方法
def add(a,b)
return a + b
end
#变量定义
c = 5
d = 7
#创建数组
arr = [1, 3, c, d, d + 2, c + 6, add(c,d) + 1]
#显示数据
p arr #输出:[1,3,5,7,9,11,13]
[/pre]
以上的例子创建的数组的长度(元素的数量)会自动调整。给5个元素,长度就是5咯。
如何知道数组的长度?我们可以用以下几个方法:size(大小), length(长度), count(数量)。
count可以接受参数来返回更进一步的信息,这个我们之后会提到。
[pre lang="ruby"]
#创建数组
arr = [1,2,3]
arr2 = []
arr3 = ["abc",1,2,5,7,"cde"]
#显示数据
p arr.size #输出:3
p arr2.length #输出:0
p arr3.count #输出:6
[/pre]
在这之后的范例,有需要知道数组内元素的数量的时候,会用size来获取。
有些时候我们需要创建只有空壳的数组,也就是光有长度但没有实际数据的数组。
看到这里,大家可能就懵了。别担心,来回想一下nil(空值)这个特殊的数据类型。
有些时候,我们需要创建一个数组,指定它的长度,但是暂时还不把数据放进去。
为什么呢?这可能是要先弄一个包含着500个元素的大空壳数组,然后再用迭代的方式把内容塞进去。
不然啊,在代码里直接写上500个数字什么的实在是太蛋疼了啊。
好,那么我们要知道的是,创建数组的另一个方法,就是用Array.new(Array是数组,new是新的意思)。
它又分成很多种用法,让我们直接来范例吧。
[pre lang="ruby"]
#创建空的数组
arr = Array.new #同 arr = []
#创建长度为4的空壳数组
arr1 = Array.new(4) #同 arr = [nil, nil, nil, nil]
#使用代码块来执行填入内容的迭代计算
arr2 = Array.new(5) {|i| i = i + 1} #0 + 1 = 1, 1 + 1 = 2, 2 + 1 = 3...
#使用代码块填入重复的内容
arr3 = Array.new(4){"a"} #同arr = ["a", "a", "a", "a"]
#显示内容
p arr #输出:[]
p arr1 # 输出:[nil,nil,nil,nil]
p arr2 # 输出:[1,2,3,4,5]
p arr3 # 输出:["a","a","a","a"]
[/pre]
创建了数组之后,我们要知道怎么进行元素的存取。我们会用到的符号,是元素引用符([ ])。
数组的每个元素,都配着一个索引(index)。这个索引是从0开始算起的。也就是说,数组内的第一个元素,索引是0。
数组内的第三个元素,索引是2。第十一个元素,索引是10,以此类推。
[pre lang="ruby"]
arr = [1,2,3,4]
p arr[0] #输出: 1
p arr[1] #输出: 2
p arr[2] #输出: 3
p arr[3] #输出: 4
p arr[4] #输出:nil
p arr[105] #输出:nil
[/pre]
如果[]内填入的索引值超出了许可的范围,那么就会得到nil(空值),也代表着获取失败。
那么如果填入的索引值是负数呢?那就是从后面开始获取。
[pre lang="ruby"]
arr = [1,2,3,4]
p arr[-1] #输出: 4
p arr[-2] #输出: 3
p arr[-3] #输出: 2
p arr[-4] #输出: 1
p arr[-5] #输出:nil
p arr[-100] #输出:nil
[/pre]
除了单独获取元素之外,我们还可以从一个数组中获取一组数据,返回的是新的数组。
[pre lang="ruby"]
arr = [1,2,3,4,5,6,7,8]
p arr[2,3] #输出:[3,4,5] ,意思是从2号索引开始,取3个元素
p arr[1..4] #输出:[2,3,4,5] ,基本上就是递入一个范围作为索引,获取1到4号索引之间的元素
p arr[2..-3] #输出:[3,4,5,6] ,意思就是从2号索引开始,获取元素直到(包括)倒数第三个索引为止
[/pre]
那么知道怎么获取数组内的元素之后,让我们来看看如何赋值吧。赋值呢,就…加个=符号啊。
[pre lang="ruby"]
arr = [1,2,3,4,5,6,7,8]
arr[4] = 9 #此时arr的值:[1,2,3,4,5,9,7,8]
arr[-2] = 10 #此时arr的值:[1,2,3,4,5,9,10,8]
arr[3,2] = [11,12] #此时arr的值:[1,2,3,11,12,9,10,8]
arr[0..2] = [13,14,15] #此时arr的值:[13,14,15,11,12,9,10,8]
arr[1..3] = 16 #此时arr的值:[13,16,12,9,10,8]
[/pre]
好复杂啊,对吧?你只要记得,获取的码后面加个=就是赋值了。arr[4]是获取, arr[4] = 就是赋值嘛。
数组也有加减等基本运算。主要是这六个符号:+(加), -(减), *(乘), |(位或), &(位和),<<(左位移)。
[pre lang="ruby"]
arr = [1,1,2,2,3,3,4,4,5,6]
p arr << 7 #输出:[1,1,2,2,3,3,4,4,5,6,7] ,注意 << 7 与 += [7] 相似
p arr += [8,9] #输出:[1,1,2,2,3,3,4,4,5,6,7,8,9]
p arr -= [2,3,4,7,8,9] #输出:[1,1,5,6]
p arr *= 3 #输出:[1,1,5,6,1,1,5,6,1,1,5,6]
p arr |= [1,2,3,4] #输出:[1,5,6,2,3,4]
p arr &= [0,1,5,4,7,8,9] #输出:[1,5,4]
[/pre]
首先是<<符号。你看到两个向左的箭头嘛,你想象成是“注入”就好。把单个元素注入数组里面。
数组的加法(+),就是把两个数组直接尾对头粘连起来。[a,b,c] + [c,d,e] = [a,b,c,c,d,e] 这样的。
那么减法(-)呢,就是从前面的数组里面把后边数组有的元素都去除掉。要注意的是,重复的元素全部都会被去除。
乘法(*),乘法基本上就是相同的数组连续相加几次(后面整数)。还有一种是字符串的,你自己尝试就知道了呗。(被打)
位或(|),和加法差不多,但是重复的元素会被去除,每个元素都只剩下一个了。
位和(&),就是将两边的数组里面共同拥有的元素留下(重复的会去除),其他的全部去除。
当然除了<<会影响本来的变量以外,其他的运算都是返回新数组的。要用=来赋值才会影响本来的变量。
数组到底是了什么而存在的啊?就只是为了少用一点变量吗?当然不只是这样。
Ruby的数组内建的方法可是多得咋舌呢。最直接体现数组用途的,就是迭代了吧。
数组有三个主要迭代方法:each(每个元素), each_index(每个索引), each_with_index(每个元素和索引)。
[pre lang="ruby"]
#使用each迭代数组里的每个元素
[1,3,"abc",7,9].each do |i|
p i
end
#输出:
1
3
"abc"
7
9
#使用each_index迭代数组的索引,与元素无关
["abc","x","y","z","cde"].each_index do |i|
p i
end
#输出:
0
1
2
3
4
#使用each_with_index迭代数组的元素和索引,注意有两个代入变量
#注:value是"值"的英文,index是"索引"的英文
#为了区分才用了这些变量名字,平时大可用什么i啊v的来代替,看个人喜好而定
["a","b","c","d","e"].each_with_index do |value, index|
p value + " " + index.to_s
end
#输出:*注:to_s是转换成字符串,整数要先转换了才能与字符串相加。
"a 0"
"b 1"
"c 2"
"d 3"
"e 4"
[/pre]
Ruby的数组可以装各种类型的数据,就连数组本身也可以。这是之前提到的。
于是在这里就延伸出了一种用法:多维数组。数组套着数组就是多维数组了呀。
[pre lang="ruby"]
#创建一个二维数组
arr = [[1,2,3],[4,5,6],[7,8,9]]
#获取二维数组的元素
p arr[0][2] #输出:3 (第一行,第三列)
#给二维数组的元素赋值
arr[1][1] = 0 #此时arr的值:[[1,2,3],[4,0,6],[7,8,9]]
#使用双重迭代来将二维数组表示成矩阵
arr.each do |a| #注意:这里的a是数组
s = ""
a.each do |i|
s += i.to_s
end
p s
end
#输出:
"123"
"406"
"789"
[/pre]
数组想要套多少层都没问题,甚至也不一定每个元素都要是数组。(比如[1,2,[3,4,5],6,[7,8]]是可以的)
那么在这里要仔细说明一下,多维数组的获取到底是什么样的原理。
[pre lang="ruby"]
#创建二维数组
arr = [[1,2,3],[4,5,6],[7,8,9]]
#获取二维数组的元素
p arr[0][2] #输出:3
#使用暂存的方式获取二维数组的元素
p a = arr[0] #输出:[1,2,3]
p a[2] #输出:3
[/pre]
于是你可以看到,arr[0][2] 就是先获取了arr[0]这个数组,然后再用[2]来获取指定的元素。
我们也可以这么形容:arr[0][2] = [1,2,3][2] = 3(因为arr[0] = [1,2,3])。
在“方法定义与调用”的部分里,我们曾经提到有一种方法的定义是可以接受无限量的参数的。
这是因为多余的参数会被存放在一个数组里面待取用。就让我们直接看范例吧。
[pre lang="ruby"]
#方法定义
def abc(*args) #注意那个*符号!
a = 0
p args
args.each do |i|
a += i
end
return a
end
#方法调用
p abc #输出(分两行):[] 和 0
p abc(1) #输出(分两行):[1] 和 1
p abc(1,2) #输出(分两行):[1,2] 和 3
p abc(1,2,3,4) #输出(分两行):[1,2,3,4] 和 10
[/pre]
额外参数(*args)必须放在最后面,如:def abc(a,b,*args),而且不能和默认参数混用。
Ruby的数组还有非常非常多的内置方法。我们将在本章最后面的“系统方法”部分一一认识。
B - 哈希表
数组是以整数为索引,有顺序的一种数据集合。但是,如果没有排序的需求呢?如果索引不是数字,而是字符串或者其他的数据类型呢?
就算索引是使用的数字,但是如果差距实在是太大太大了呢?(比如一个值的索引要设置5,另一个560,再一个1900,难道要弄长度1900的数组吗?)
这时,我们可以用哈希表(Hash,哈希是音译)。
哈希表是一种键值对集合。一个键(key,钥匙的意思)对应一个值(value)。
这么形容好了。假设哈希表是一排锁着的柜子,里面收藏着数据。那么每一层都有对应的钥匙,能打开然后取出/置入数据。
哈希表的键和值可以是任何类型的数据。与数组不一样的是,使用哈希表的时候,我们不注重元素储存的顺序。
RMVA里面使用哈希表的地方有:队伍拥有的物品/装备,地图的事件,素材导入的暂存(Cache模块)等等。
创建Hash的方法也有几种。最简单的就是直接赋值。与数组的[]不同,创建哈希表的符号是{}。
哈希表内容的格式是: 键(key) => 值(value) ,如果有超过一个的话,用逗号(,)来分隔。
[pre lang="ruby"]
#创建空的哈希表
hash = {}
#创建单个内容的哈希表
hash1 = {"a" => 1}
#创建多个内容的哈希表
hash2 = {"a" => 1, "b" => "abc", 3 => "c"}
#显示内容
p hash #输出:{}
p hash1 #输出:{"a" => 1"}
p hash2 #输出:{"a" => 1, "b" => "abc", 3 => "c"}
[/pre]
在介绍其他创造哈希表的方法之前,我们需要知道如何存取哈希表的数据。这和数组是一样的,只是[]里面要填入的是键(key)。
[pre lang="ruby"]
#创建哈希表
hash = {"a" => 1, "b" => "abc", 3 => "c"}
#读取数据
p hash["a"] #输出:1
p hash["b"] #输出:"abc"
p hash[3] #输出:"c"
p hash[666] #输出:nil
#储存数据
hash["a"] = 5 #此时hash是{"a" => 5, "b" => "abc", 3 => "c"}
hash[3] = :abc #此时hash是{"a" => 5, "b" => "abc", 3 => :abc}
hash[666] = [1,2,3] #此时hash是{"a" => 5, "b" => "abc", 3 => :abc, 666 => [1,2,3]}
[/pre]
从上面的例子我们可以看到,尝试引用哈希表内不存在的键时,会返回一个可以设置的默认值。如果没有默认值,则返回nil(空值)。
如果引用哈希表内不存在的键来赋值的话,这个键值配对就会加入哈希表里面,作为储存的数据。
好,那么就让我们来看看,还有那些创建哈希表的方法吧。
[pre lang="ruby"]
#创建哈希表
hash = Hash.new #创建一个空的哈希表,同 hash = {}
hash1 = Hash.new(666) #创建一个空的哈希表,并设置默认值
#尝试读取不存在哈希表内的键
p hash[233] #输出:nil
p hash1[233] #输出:666
[/pre]
默认值在一些时候很有用,比如背包内物品的数量,没有的话就返回0,这样的用法。
与数组相似,哈希表也有三种迭代方法,分别是each(每个),each_key(每个键)和each_value(每个值)。
[pre lang="ruby"]
hash = {"a" => "x", "b" => "y", "c" => "z"}
#使用each遍历哈希表的键值配对
hash.each do |key,value| #注意:格式是 |键,值| ,与数组的each_with_index(|值,索引|)相反
p key + " " + value
end
#输出:
a x
b y
c z
#使用each_key遍历哈希表的键
hash.each_key do |key|
p key
end
#输出:
a
b
c
#使用each_key遍历哈希表的值
hash.each_value do |value|
p value
end
#输出:
x
y
z
[/pre]
哈希表的各种内置方法,也会在“系统方法”的部分一一介绍。
1.7 系统方法
展开折叠
本章的最后一个部分将介绍Ruby所提供的系统方法。
能善用这些方法对游戏制作来说能起到很大的帮助。
A - 核心全局方法
Ruby的核心(Kernel)提供了最主要的几个系统方法。这些方法可以在脚本的哪儿都可以使用,所以叫全局方法。
1. p, print, puts (这三种都是在控制台内显示数据的方法)
p这个方法,本教程里面大肆使用。这方法,应该不会感到陌生了吧。
实际上,Ruby还有两个可以在控制台里显示数据的方法,就是print和puts。
很多人问我,你怎么就是喜欢用p,而不是用puts呢?来来来,让我慢慢解释。
print和puts在控制台显示数据的时候,会调用数据的to_s内置方法,将它转换成字符串。
p则是调用了inspect(检视)内置方法。虽然一般上to_s和inspect生成的内容都差不多的,但!是!
字符串本身在调用inspect方法来转换成字符串的时候,会有双引号包着。
这样会更容易检查该变量是否字符串,而不容易与其他数据类型混淆。
那么print和puts的差别,就是print不会自动换行,而puts会自动换行。
[pre lang="ruby"]
str = "abc"
p str
p str
puts str
puts str
print str
print str
#输出:
"abc"
"abc"
abc
abc
abcabc
[/pre]
2. rand(随机数生成,random的缩写,意思是随机)
rand的用途是生成一个0.0到1.0之间的浮点数(如0.56789)。
如果递入整数作为参数,那么就会生成0到该整数之间的一个随机整数。
[pre lang="ruby"]
p rand #输出:0.3355309950867542(0.0到1.0之间的随机浮点数)
p rand #输出:0.7407691203989254(0.0到1.0之间的随机浮点数)
p rand(1000) #输出:819(0到1000之间的随机整数,范围是0...1000,不包括1000)
p rand(10) #输出:7(0到10之间的随机整数,范围是0...10,不包括10)
[/pre]
3. srand (随机数设定,seed rand的缩写,意思是随机的“种子”)
srand的用途是设定随机生成器的“种子”(seed),以得到固定的随机数。
格式是srand(整数)。如果没有递入参数,那么srand将随机生成一个数字来作为“种子”。
srand调用时将返回之前所使用的“种子”
[pre lang="ruby"]
srand 1234
p rand(100) #输出:47
p rand(100) #输出:98
p srand 3456 #输出:1234 (之前的“种子”)
p rand(100) #输出:27
p rand(100) #输出:98
p srand 1234 #输出:3456
p rand(100) #输出:47
p rand(100) #输出:98
[/pre]
你会发现,设置1234作为srand的种子之后,首两次使用rand(100)必定分别获得47和98。
4. sprintf (文本格式化,string print format的缩写,三个英文字分别是:字符串,打印,格式)
sprintf的使用法可以在F1汉化版帮助文档的附录里面读到。
在这里就不多加解释了,只提供几个范例。
[pre lang="ruby"]
#将数字直接“打印”到字符串里面
p sprintf("%d", 12345) #输出:"12345"
#将浮点数“打印”进字符串,要求字符串长度是20,并显示到小数点后8位
p sprintf("%20.8f", 1234.56789) #输出:" 1234.56789000"
[/pre]
5. loop (无限循环)
还记得while(true)这个无限循环法吗?其实这可以用loop来代替。
[pre lang="ruby"]
loop do
p "无限循环哦哦哦哦哦~"
end
#输出:
"无限循环哦哦哦哦哦~"
"无限循环哦哦哦哦哦~"
"无限循环哦哦哦哦哦~"
...(然后就停不下来了)
[/pre]
就像while(true)那样,无限循环需要用break,next,redo等关键词来操纵流程。
6. raise (手动报错,raise的意思是提起)
raise这个方法是用于手动报错的。使用的情况呢,比如你是程序员嘛,你写了个脚本给别人用。
那么你知道如果设置错误的话迟早会出错,你就加个检查然后手动报错,告诉使用者是他的问题而不是你的。
raise的第一个参数可以设置错误讯息或者弹窗时的错误类型。关于错误类型,可以翻F1汉化版帮助文档来看看。
如果raise的第一个参数是字符串(错误讯息),那么错误类型会是RuntimeError(执行时出错)。否则,raise的第二个参数是错误讯息。
raise的第三个参数是关于出错的脚本和行数。获取出错脚本/行数的方法是caller。
[pre lang="ruby"]
raise "我去,出错了!" #执行这一句后会弹报错窗,错误类型是 RuntimeError(执行时出错),讯息是:我去,出错了!
raise ArgumentError, "参数设置不对啊亲。" #执行这一句后会弹出ArgumentError(参数错误),然后显示讯息:参数设置不对啊亲。
raise StandardError, "出错", caller #执行后弹窗,显示StandardError错误类型和讯息,也显示出错的脚本和行数。
[/pre]
7. eval (运行代码,evaluate的缩写,意思是执行运算)
它用于执行存在字符串里面的代码后将运行的最后一个语句的值返回,是个很恐怖的存在。
事件脚本指令的实现原理是用了eval这个方法。
[pre lang="ruby"]
#例子1
str = "i = 5; i+= 1; p \"a\" + i.to_s"
eval str #输出:"a6" ,基本上字符串里面的代码全都运行了
#例子2
a = 6
p eval "a *= 2; a + 3" #输出:15 ,因为运行的最后一个语句会作为返回值
[/pre]
B - 数学运算方法
就如“方法调用”部分里提到的,Ruby内置三角函数等高级数学运算的方法。在这儿就不一一列出例子了,毕竟用的幅度不高。
使用下列的方法时必须用 Math.方法名 的格式。(方法调用部分里有代码范例)
1. 三角函数(注意:单位是弧度而不是角度)
sin (正弦函数), cos (余弦函数) tan (正切函数)
asin (反正弦函数), acos (反余弦函数) atan (反正切函数)
sinh (双曲正弦函数), cosh (双曲余弦函数), tanh (双曲正切函数)
asin (反双曲正弦函数), acosh (反双曲余弦函数), atanh (反双曲正切函数)
atan2 (反正切函数2)注:此函数接受X和Y两个参数,格式为:atan2(x,y)
2. 对数函数
log (对数函数)注:格式为:log(真数,底数) ,如果不递入底数,那么就使用常量e为底数。
log2 (底数为2的对数函数)
log10 (底数为10的对数函数)
3. 乘方,方根
exp (常量e的乘方)
sqrt (平方根)
cbrt (立方根)
4. 数学常量 注:这个部分列出的是常量而不是方法。使用格式为: Math::常量
PI (圆周率)
E (常量e)
C - 数据类型转换方法
Ruby提供了数种类型转换的方法,从一个数据类型转换到另一个数据类型。
1. to_i (转换到整数) 适用数据类型:字符串,浮点数
[pre lang="ruby"]
#将字符串转换成整数(注意:可以递入参数指定进制)
p "1234".to_i #输出:1234 (默认为十进制)
p "0b011101".to_i(2) #输出:29 (二进制)
p "011101".to_i(2) #输出:29 (二进制,前面不加0b也可以)
p "0x5F6C".to_i(16) #输出:24428 (十六进制)
p "5F6C".to_i(16) #输出:24428 (十六进制,前面不加0x也可以)
p "efgh".to_i #输出:0 (转换失败)
#将浮点数转换成整数
p (3.14).to_i #输出:3
p (-15.6).to_i #输出:-15
[/pre]
2. to_f (转换到浮点数) 适用数据类型:字符串,整数
[pre lang="ruby"]
#将字符串转换成浮点数
p "3.14".to_f #输出:3.14
p "abc".to_f #输出:0.0 ,注意:转换失败
p "1.602e-19".to_f #输出:1.602e-19 ,注意:这等于 1.602 * (10 ** -19)
#将整数转换成浮点数
p 2333.to_f #输出:2333.0
[/pre]
3. to_s (转换成字符串) 适用数据类型:几乎所有数据类型
[pre lang="ruby"]
#将整数转换成字符串(注意:可以递入参数指定进制)
p (10086).to_s #输出:"10086" (默认为十进制)
p (133).to_s(2) #输出:"10000101" (二进制)
p (240).to_s(16) #输出:"f0" (十六进制)
#将浮点数转换成字符串
p (4.5).to_s #输出:"4.5"
#将符号转换成字符串
p (:a_b_c).to_s #输出:"a_b_c"
#将范围转换成字符串
p (1..10).to_s #输出:"1..10"
#将真值转换成字符串
b = true
p b #输出:"true"
#将数组转换成字符串
arr = [1,2,3,[7,8],4]
p arr.to_s #输出:"[1, 2, 3, [7, 8], 4]"
#将哈希表转换成字符串
hash = {1 => "a", 2 => [5,6,7]}
p hash.to_s #输出:"{1=>\"a\", 2=>[5, 6, 7]}"
[/pre]
注:某些符号,比如单引号和双引号,会前缀\符号来“转义”(就如事件显示文字指令的控制符)。
4. to_sym (转换成符号) 适用数据类型:字符串
[pre lang="ruby"]
#将字符串转换成符号
p "abc123".to_sym #输出::abc123
p "@a_b_c".to_sym #输出::@a_b_c
p "123abc".to_sym #输出::"123abc"
[/pre]
此方法可以生成原本直接创建时会出错的符号。
5. to_a (转换成数组) 适用数据类型:范围,哈希表
[pre lang="ruby"]
#将范围转换成数组
p (1..10).to_a #输出:[1,2,3,4,5,6,7,8,9,10]
#将哈希表转换成数组
hash = {"a" => 2, "b" => 4, 5 => 6}
p hash.to_a #输出:[["a", 2], ["b", 4], [5, 6]]
[/pre]
D - 整数/浮点数内置方法
1. integer?(判定是否整数)
[pre lang="ruby"]
#判断是否整数 - 用于鉴别整数和浮点数
p (10086).integer? #输出:true
p (23.333).integer? #输出:false
[/pre]
2. odd?(判定是否奇数), even?(判定是否偶数) 注:只适用于整数
[pre lang="ruby"]
#判断整数是否奇数
p (8).odd? #输出:false
p (7).odd? #输出:true
#判断整数是否偶数
p (8).even? #输出:true
p (7).even? #输出:false
[/pre]
3. zero?(判定是否为零)
[pre lang="ruby"]
#判定是否为零
p (1024).zero? #输出:false
p (0).zero? #输出:true
p (3.142).zero? #输出:false
p (0.0).zero? #输出:true
[/pre]
4. pred(上一个数,,predecessor的缩写), next(下一个数) 注:只适用于整数
[pre lang="ruby"]
#变量赋值
a = 22
#获取上一个数
p a.pred #输出:21 ,注:与 p (a - 1) 相同
#获取下一个数
p a.next #输出:23 ,注:与 p (a + 1) 相同
[/pre]
5. abs(绝对值, absolute的缩写)
[pre lang="ruby"]
#获取绝对值
p (666).abs #输出:666
p (-666).abs #输出:666
p (3.142).abs #输出:3.142
p (-3.142).abs #输出:3.142
[/pre]
6. times(次数), upto(上至), downto(下至)
数字的times, upto和downto都有在“迭代”的部分说明过,可以回去翻阅。
浮点数调用这个方法时,会自动向下取整。
[pre lang="ruby"]
#times, upto 和 downto 迭代器
5.times {|i| print i} #输出: 01234
print "\n" #换行
1.upto(5){|i| print i} #输出:12345
print "\n" #换行
5.downto(1){|i| print i} #输出:54321
print "\n" #换行
[/pre]
7. numerator(分子), denominator(分母)
[pre lang="ruby"]
#整数调用这两个方法时,分子必定为自身,分母必定为1
p (25).numerator #输出:25
p (25).denominator #输出:1
#获取浮点数的分子和分母
p (0.75).numerator #输出:3
p (0.75).denominator #输出:4
#0.75用分数来表达是(3/4),这肯定是没错的
[/pre]
8. chr(转换为字符,character的缩写) 注:只适用于整数
[pre lang="ruby"]
#获取字符
p (100).chr #输出:"d" ,注:字母d的ASCII码是100
p (64).chr #输出:"@" ,注:符号@的ASCII码是64
p (256).chr #出错!chr方法只适用于范围(0..255)的整数
[/pre]
9. round(四舍五入取整), ceil(向上取整, ceiling的缩写), floor(向下取整)
round, ceil, floor这三种取整法都能接受一个递入参数,指定小数点前后的位数。正数是后,负数是前。
[pre lang="ruby"]
#round, ceil和floor对整数使用时的情况
p 123.round #输出:123 (没有变动,因为本来就是整数)
p 123.round(2) #输出:123.0 (变成浮点数类型了)
p 123.round(-1) #输出:120(四舍五入,十位)
p 165.round(-2) #输出:200(四舍五入,百位)
#四舍五入取整
p (3.142).round(2) #输出:3.14(四舍五入,小数点后2位)
p (13666.256).round(-4) #输出:10000(四舍五入,万位)
p (3.9).round #输出:4(四舍五入,转换成整数)
p (3.1).round #输出:3(四舍五入,转换成整数)
#向上取整
p (3.9).ceil #输出:4(向上取整,转换成整数)
p (3.1).ceil #输出:4(向上取整,转换成整数)
#向下取整
p (3.9).floor #输出:3(向下取整,转换成整数)
p (3.1).floor #输出:3(向下取整,转换成整数)
[/pre]
10. gcd(最大公因数,greatest common divisor的缩写),lcm(最小公倍数,lowest common multiple的缩写)
[pre lang="ruby"]
#获取最大公因数
p 36.gcd(45) #输出:9
p 12.gcd(9) #输出:3
#获取最小公倍数
p 36.lcm(45) #输出:180
p 12.lcm(9) #输出:36
[/pre]
11. gcdlcm(同时获取最大公因数和最小公倍数)
[pre lang="ruby"]
#同时获取最大公因数和最小公倍数,储存在数组里
p 36.gcdlcm(45) #输出:[9, 180]
p 12.gcdlcm(9) #输出:[3, 36]
[/pre]
E - 范围内置方法
1. begin(开头), first(第一个), end(尾端), last(最后一个)
[pre lang="ruby"]
#变量赋值
a = (2..10)
b = (4...15)
#begin和first都是获取范围的开头值
p a.begin #输出:2
p a.first #输出:2
p b.begin #输出:4
p b.first #输出:4
#end和last都是获取范围的结尾值
#不管范围的模式是..(包括尾端)还是...(不包括尾端)都一样
p a.end #输出:10
p a.last #输出:10
p b.end #输出:15
p b.last #输出:15
[/pre]
2. each(每个), step(步数)
范围的each和step都有在“迭代”的部分说明过,可以回去翻阅。
[pre lang="ruby"]
#each迭代
(1..4).each do |i|
p i
end
#输出:
1
2
3
4
#step迭代
(1..10).step(3) do |i|
p i
end
#输出:
1
4
7
10
[/pre]
3. include? (判断是否包含)
[pre lang="ruby"]
#判断范围是否包含递入的参数
p (1..10).include?(9) #输出:true
p (1..10).include?(10) #输出:true
p (1..10).include?(11) #输出:false
p (1...10).include?(9) #输出:true
p (1...10).include?(10) #输出:false (因为不包括尾端)
p (1...10).include?(11) #输出:false
[/pre]
4. exclude_end? (判断是否不包括尾端)
[pre lang="ruby"]
#判断是否不包括尾端
p (2..10).exclude_end? #输出:false
p (4...15).exclude_end? #输出:true
[/pre]
F - 符号内置方法
1. [] (元素索引符)
符号里的每一个字符都可以像数组那样透过[]符号取出
[pre lang="ruby"]
#变量赋值
a = :RPGMaker
#使用[]符号获取数组内的字符,输出为字符串
p a[0] #输出:"R"
p a[6] #输出:"e"
p a[-1] #输出:"r"
p a[-3] #输出:"k"
p a[1,3] #输出: "PGM"
p a[2...7] #输出:"GMake"
p a[3..-1] #输出:"Maker"
[/pre]
2. length(长度), size(大小)
[pre lang="ruby"]
#length和size都是获取符号的长度
a = :hello
b = :rpgmaker
p a.length #输出:5
p a.size #输出:5
p b.length #输出:8
p b.size #输出:8
[/pre]
3. capitalize(首字母大写,其余小写)
[pre lang="ruby"]
#获取一个新符号,首字母大写而其他的字母小写
p (:hello).capitalize #输出::Hello
p (:HeLlo).capitalize #输出::Hello
[/pre]
4. upcase(全部字母大写), downcase(全部字母小写), swapcase(字母大小写互换)
[pre lang="ruby"]
#获取一个新的符号,全部字母都大写
p (:RPGMaker).upcase #输出::RPGMAKER
#获取一个新的符号,全部字母都小写
p (:RPGMaker).downcase #输出::rpgmaker
#获取一个新的符号,字母大小写互换
p (:RPGMaker).swapcase #输出::rpgMAKER
[/pre]
5. casecmp(不计字母大小写的复合比较)
[pre lang="ruby"]
#复合比较两个符号,不计较字母的大小写
#等同 a.downcase <=> b.downcase (假设a和b都是符号)
p (:hello).casecmp(:HeLlo) #输出:0 (代表等于)
p (:hello5).casecmp(:HeLlo2) #输出:1 (代表大于)
p (:hello1).casecmp(:HeLlo2) #输出:-1 (代表小于)
[/pre]
G - 字符串内置方法
1. % (位和运算符)
[pre lang="ruby"]
#字符串的%运算符的功能与核心的sprintf方法相似
#请参考核心方法部分的sprintf以获得更多信息
#递入多个参数时需要用数组或哈希表来承载
str = "%05d" % 123
p str #输出:"00123"
#注:与 str = sprintf("%05d", 123) 相似
str = "%-5s: %08x" % [ "ID", 12345678 ]
p str #输出:"ID : 00bc614e"
#注:与 sprintf("%-5s: %08x","ID",12345678) 相似
str = "123 = %{abc}" % { :abc => "xyz" }
p str #输出:"123 = xyz"
#注:与 sprintf("abc = %{abc}",{ :abc => "xyz" }) 相似
[/pre]
2. * (乘法运算符), << (左位移运算符)
[pre lang="ruby"]
#字符串的*运算和和数组的*运算相似
str = "abc"
p str * 3 #输出:"abcabcabc"
#字符串的<<运算和和数组的<<运算相似
str = "abc"
str << "def" << "ghi"
str << "jkl"
p str #输出:"abcdefghijkl"
[/pre]
3. [] (元素索引符), []=(元素赋值符)
[pre lang="ruby"]
#字符串内的字符可以像数组那样使用[]取出或者用[]=赋值
#用法和数组的[]和[]=相似,只是取出或赋值的数据是字符串
#如果索引超出字符长度,[]引用会返回nil(空值)而[]=赋值会报错
str = "abcdefgh"
p str[3] #输出:"d"
p str[-2] #输出:"g"
p str[1,3] #输出:"bcd"
p str[2..5] #输出:"cdef"
p str[0...-2] #输出:"abcdef"
str = "abcdefghijkl"
str[3] = "z"; p str #输出:"abczefghijkl"
str[-2] = "y"; p str #输出:"abczefghijyl"
str[1,3] = ""; p str #输出:"aefghijyl" ("bcz"被""取代了)
str[2..5] = "123"; p str #输出:"ae123jyl" ("fghi"被"123"取代了)
str[4] = "456"; p str #输出:"ae12456jyl" ("3"被"456"取代了)
[/pre]
4. empty?(判断是否为空)
[pre lang="ruby"]
#变量赋值
a = ""
b = "rpgmaker"
#判断字符串是否是空着的
p a.empty? #输出:true
p b.empty? #输出:false
[/pre]
5. length(长度), size(大小)
length和size都是获取字符串的长度
[pre lang="ruby"]
str = ""
str1 = "66rpg"
str2 = "rpgmaker"
#获取字符串的长度
p str.length #输出:0
p str.size #输出:0
p str1.length #输出:5
p str2.size #输出:5
p str3.length #输出:8
p str4.size #输出:8
[/pre]
6. insert(注入), delete(删除), delete!(毁灭性删除),clear(清空)
[pre lang="ruby"]
#insert用于在字符串的指定位置注入另一个字符串
#格式:insert(位置, 字符串)
str = "abcdefgh"
str.insert(5,"XYZ")
p str #输出:"abcdeXYZfgh"
#delete用于删除字符串内所有匹配递入参数的部分, 作为新字符串返回
str = "66rpg66rpg66rpg"
p str.delete("rpg") #输出:"666666"
#后缀!的delete!是毁灭性操作,也就是会影响原本的字符串
str = "66rpg66rpg66rpg"
str.delete!("rpg")
p str #输出:"666666"
#clear用于清空字符串内的所有字符
str = "abcdefg"
str.clear
p str #输出:""
[/pre]
7. start_with?(判断开始), end_with?(判断结尾)
[pre lang="ruby"]
#start_with?用于判断字符串是否以某个字符序列开头
a = "abcdefgh"
p a.start_with?("fgh") #输出:false
p a.start_with?("abc") #输出:true
#end_with?用于判断字符串是否以某个字符序列结尾
a = "abcdefgh"
p a.end_with?("fgh") #输出:true
p a.end_with?("abc") #输出:false
[/pre]
8. include?(判断是否包含)
[pre lang="ruby"]
#include?用于判断字符串内是否包含作为递入参数的字符序列
a = "abcdefgh"
p a.include?("cde") #输出:true
p a.include?("xyz") #输出:false
[/pre]
9. casecmp(不计大小字母的的复合比较)
[pre lang="ruby"]
#复合比较两个字符串,不计较字母的大小写
#等同 a.downcase <=> b.downcase (假设a和b都是字符串)
p "rpgmaker".casecmp("RpGmAkER") #输出:0 (代表等于)
p "rpgmakerx".casecmp("RpGmAkERc") #输出:1 (代表大于)
p "rpgmakera".casecmp("RpGmAkERc") #输出:-1 (代表小于)
[/pre]
10. bytesize(获取总字节大小), ascii_only?(判断是否只含有ASCII字符)
[pre lang="ruby"]
#bytesize用于获取一个字符串的总字节大小。什么是字节大小?比如ASCII码占1个字节,UTF-8则占3个字节。
#你不知道ASCII和UTF-8的意思?百度搜索是你的好伙伴。
a = "abcdefgh"
b = "66RPG梦想世界"
p a.bytesize #输出:8
p b.bytesize #输出:17 (5个英文字母/数字,各1字节 + 4个中文字,各3字节)
#ascii_only?用于判断字符串内是否只有ASCII字符(英文字母,数字,一些半角符号等等)
a = "abcdefgh"
b = "66RPG梦想世界"
p a.ascii_only? #输出:true
p b.ascii_only? #输出:false
[/pre]
11. index(获取位置), rindex(反向获取位置)
[pre lang="ruby"]
#递入一个字符序列,尝试获取它在字符串内第一个匹配的位置,如果找不到则返回nil
#第二个参数指定搜索停止的位置。
#rindex则是返回最后一个匹配的位置
str = "1a2b3c4d3c2b1a"
p str.index("3c") #输出:4
p str.rindex("3c") #输出:8
p str.index("4d",-3) #输出:nil
#index和rindex也可以接受正则表达式作为参数来尝试匹配
#关于正则表达式,请参考F1汉化帮助文档的附录
[/pre]
12. each_byte(每个字节), each_char(每个字符), each_codepoint(每个码位), each_line(每行)
[pre lang="ruby"]
#each_byte, each_char, each_codepoint和each_line都是字符串自带的迭代方法
#each_byte迭代的内容是字节,这一点可以参考bytesize方法的解释
str = "abcd"
str.each_byte{|b| p b}
#输出:
97
98
99
100
#each_char字面上的意思,就是对每一个字符进行迭代
str = "abcd"
str.each_char{|c| p c}
#输出:
"a"
"b"
"c"
"d"
#each_codepoint是对非ASCII编码的字符用的(比如中文字),对每个字符的编码位置进行迭代
#不知道编码和码位而想要知道更多信息的话,建议去百度搜索科普一下
str = "6R梦想世界"
str.each_codepoint{|c| p c}
#输出:
54
82
26790
24819
19990
30028
#each_line是对行数进行迭代,可接受一个参数,定义分隔符
str = "第一行\n第二行\n第三行"
str.each_line("\n"){|s| p s}
输出:
"第一行\n"
"第二行\n"
"第三行"
#注意:使用p显示字符串时,转义符(比如\n)也会被显示出来。puts则不会。
#在这里是想要表示,分隔符会仍然存在迭代的变量里面,不会被移除。
[/pre]
13. center(置中), ljust(置左,left adjust的缩写), rjust(置右,right adjust的缩写)
[pre lang="ruby"]
#center, ljust和rjust三个方法都是用于增加字符串的长度,并返回新的字符串。
#如果字符串比指定的长度还长,那么将直接返回原本的字符串。否则,填入指定的填充字符来进行增长。
#格式:方法名(目标长度,填充字符序列)
str = "hello"
p str.center(20," ") #输出:" hello "
p str.ljust(20," ") #输出:"hello "
p str.rjust(20," ") #输出:" hello"
str = "999"
p str.center(10,"0") #输出:"0009990000"
p str.ljust(10,"0") #输出:"9990000000"
p str.rjust(10,"0") #输出:"0000000999"
[/pre]
14. strip(移除空白), lstrip(移除前面空白), rstrip(移除后面空白)
注:后缀!即成毁灭性操作
[pre lang="ruby"]
#strip, lstrip, rstrip都用于移除字符串内的空白,作为新的字符串返回
#空白指空格(" "),tab("\t"),换行符("\n")和返回符("\r")
str = " abcde fghij "
p str.strip #输出:"abcde fghij"
p str.lstrip #输出:"abcde fghij "
p str.rstrip #输出:" abcde fghij"
#以上三种方法后缀!则成为毁灭性操作,会更改原本的字符串
[/pre]
15. reverse(反转), reverse!(毁灭性反转)
[pre lang="ruby"]
#获取一个新字符串,字符的顺序被反转
str = "abcdefgh"
p str.reverse #输出:"hgfedcba"
#后缀!的方法是毁灭性操作,也就是会影响原本的字符串
str = "abcdefgh"
str.reverse!
p str #输出:"hgfedcba"
[/pre]
16. capitalize(首字母大写,其余小写), capitalize!(毁灭性操作)
[pre lang="ruby"]
#获取一个新字符串,首字母大写而其他的字母小写
str = "rpgmaker"
str1 = "rPgMAkER"
p str.capitalize #输出:"Rpgmaker"
p str1.capitalize #输出:"Rpgmaker"
#后缀!的方法是毁灭性操作,也就是会影响原本的字符串
str = "rpgmaker"
str.capitalize!
p str #输出:"Rpgmaker"
[/pre]
17. upcase(全部字母大写), downcase(全部字母小写), swapcase(字母大小写互换)注:后缀!即成毁灭性操作
[pre lang="ruby"]
#upcase用于获取一个新字符串,全部字母都大写。
str = "rpgmaker"
str1 = "rPgMAkER"
p str.upcase #输出:"RPGMAKER"
p str1.upcase #输出:"RPGMAKER"
#downcase用于获取一个新字符串,全部字母都小写。
str = "RPGMAKER"
str1 = "rPgMAkER"
p str.downcase #输出:"rpgmaker"
p str1.downcase #输出:"rpgmaker"
#swapcase用于获取一个新字符串,字母大小写都互换
str = "rPgMAkER"
p str.swapcase #输出:"RpGmaKer"
#以上三个方法后缀!后(upcase!, downcase!, swapcase!)都会影响原本的字符串
[/pre]
18. split(分隔)
[pre lang="ruby"]
#用于生成一个数组,内含经特定分隔符或正则表达式分隔而成的部分。
#第二个参数指定范围,也就是分隔的限制
#格式为:split(分割符或正则表达式, 范围)
str = "66rpg rpgmaker vx ace"
p str.split(" ") #输出:["66rpg", "rpgmaker", "vx", "ace"]
p str.split("r") #输出:["66", "pg ", "pgmake", " vx ace"]
str = "66rpg"
p str.split("") #输出:["6", "6", "r", "p", "g"]
p str.split("",2) #输出:["6", "6", "rpg"]
[/pre]
19. scan(扫描)
[pre lang="ruby"]
#使用正则表达式扫描字符串,并将所有匹配的字符作为数组而返回
#正则表达式的创建法和格式请参考F1汉化版帮助文档的附录
str = "66rpg rpgmaker vx ace"
p str.scan(/\w+/) #输出:["66rpg", "rpgmaker", "vx", "ace"]
p str.scan(/.../) #输出:["66r", "pg ", "rpg", "mak", "er ", "vx ", "ace"]
#scan的后面可以附上代码块,直接执行迭代(与str.scan.each相似)
str = "66rpg rpgmaker vx ace"
str.scan(/\w+/){|s| p s}
#输出:
"66rpg"
"rpgmaker"
"vx"
"ace"
[/pre]
20. slice(分割), slice!(毁灭性分割)
[pre lang="ruby"]
#slice和[]元素引用的功能相似
str = "abcdefgh"
p str.slice(5) #输出:"f"
p str.slice(-1) #输出:"h"
p str.slice(1,2) #输出:"bc"
p str.slice(0..3) #输出:"abcd"
#slice!是毁灭性的,也就是取出的字符序列会从字符串里删除
str = "rpgmaker"
p str.slice!(0,3) #输出:"rpg"
p str #输出:"maker"
p str.slice!(-1) #输出:"r"
p str #输出:"make"
#slice和slice!都能递入正则表达式作为参数,在此就不多做讲解了。
[/pre]
21. chop(移除后方字符), chop!(毁灭性移除后方字符)
[pre lang="ruby"]
#移除字符串最后面的字符后,返回一个新字符串
str = "abcdef"
p str.chop #输出:"abcde"
#chop!是毁灭性的操作,会影响原字符串
str = "abcdef"
str.chop!
p str #输出:"abcde"
[/pre]
22. chomp(移除后方指定字符), chomp!(毁灭性移除后方指定字符)
[pre lang="ruby"]
#移除字符串后方指定的字符后,返回一个新字符串
#如果没有递入参数,chomp只会对返回符(/r),换行符(/n),和返回+换行符(/r/n)组合下手
#如果找不到可以移除的字符,那么chomp会原封不动地返回本来的字符串
p "abcdef\n".chomp #输出:"abcdef"
p "abcdef".chomp("ef") #输出:"abcd"
#chomp!是毁灭性的操作,会影响原字符串
str = "abcdef\r\n"
str.chomp!
p str #输出:"abcdef"
[/pre]
23. sub(单次替换内容, substitute的缩写), gsub(全局替换内容,global substitute的缩写)注:后缀!即成毁灭性操作
[pre lang="ruby"]
#sub和gsub用于寻找匹配并替换内容,然后返回新的字符串
#sub和gsub的分别就是sub替换了一次之后就会停止,而gsub会处理并替换所有匹配的字符序列
#递入的查找参数可以是字符串,也可以是正则表达式(请参考F1汉化帮助文档的附录)
str = "RMXP RMXP RMXP"
p str.sub("XP", "VA") #输出:"RMVA RMXP RMXP"
p str.gsub("XP", "VA") #输出:"RMVA RMVA RMVA"
str = "hello there"
p str.sub(/[aeiou]/, "*") #输出:"h*llo there"
p str.gsub(/[aeiou]/, "*") #输出:"h*ll* th*r*"
#后缀!的sub!和gsub!是毁灭性操作,也就是会对原本的字符串作改动
[/pre]
H - 数组内置方法
1. empty?(判断是否为空)
[pre lang="ruby"]
#变量赋值
a = []
b = [5, 6, 7, 8]
#判断数组是否是空着的
p a.empty? #输出:true
p b.empty? #输出:false
[/pre]
2. include?(判断是否包含),any?(判断是否存在),count(判断数量),nitems(非空值的元素数量)
[pre lang="ruby"]
#include?用于判断数组内是否包含某个元素
p [1,2,3].include?(5) #输出:false
p [1,2,3].include?(2) #输出:true
#any?如果直接调用,是用于判断数组内是否有非空值的元素
p [nil, nil, nil].any? #输出:false
p [1, 2, nil].any? #输出:true
#any?可以接受代码块(一个局部变量,代表元素)来进行迭代,如果有任何一个判断通过则返回true。
p [1,2,3,4,5].any?{|i| i < 0} #输出:false
p [1,2,3,4,5].any?{|i| i >= 3} #输出:true
#count直接调用的时候,和size和length一样,是获取数组内的元素数量
p [1, 2, 3].count #输出:3
p [4, 5, 6, 7, 8].count #输出:5
#count可以接受代码块(一个局部变量,代表元素)来进行迭代,并返回通过判断的元素的数量
p [1,2,3,4,5].count{|i| i < 0} #输出:0
p [1,2,3,4,5].count{|i| i >= 3} #输出:3
#nitems用于获取数组内非空值的元素数量
p [nil, nil, nil].nitems #输出:0
p [1, 2, nil].nitems #输出:2
[/pre]
3. push(推入), pop(拉出), shift(首位移出), unshift(首位移入), clear(清空)
[pre lang="ruby"]
#push用于在数组的尾端加入新元素(返回加入新元素后的数组)
arr = [1, 2, 3]
arr.push(7)
p arr #输出:[1, 2, 3, 7]
#pop用于移除并获取数组尾端的元素
arr = [1, 2, 3, 4]
p arr.pop #输出:4
p arr #输出:[1, 2, 3]
#shift用于移除并获取数组最前端的元素
arr = [1, 2, 3, 4]
p arr.shift #输出:1
p arr #输出:[2, 3, 4]
#unshift用于在数组的最前端加入新元素(返回加入新元素后的数组)
arr = [1, 2, 3]
arr.unshift(7)
p arr #输出:[7, 1, 2, 3]
#clear用于清空数组内的所有元素
arr = [1, 2, 3, 4]
arr.clear
p arr #输出:[]
[/pre]
以上几个方法可以用来实现"队列"(queue)和"栈"(stack)。如果不知道什么是队列和栈,可以去百度搜索科普一下。
push用于“进栈”或者“进列”的操作。pop用于“出栈”的操作,而shift用于“出列”的操作。clear当然是清除栈或者队列了。
相反方向的话,unshift用于进栈/进列, shift用于出栈,而pop用于出列。
[pre lang="ruby"]
#如果看不懂这是在干啥的话,我觉得…嗯大概你还没去科普吧…
#栈的演示(使用push和pop)
stack = []
p stack.push(1) #输出:[1]
p stack.push(2) #输出:[1, 2]
p stack.push(3) #输出:[1, 2, 3]
p stack.pop #输出:3
p stack.push(4) #输出:[1, 2, 4]
p stack.push(5) #输出:[1, 2, 4, 5]
p stack.pop #输出:5
p stack.pop #输出:4
p stack.pop #输出:2
p stack.push(6) #输出:[1, 6]
p stack.clear #输出:[]
#队列的演示(使用push和shift)
queue = []
p queue.push(1) #输出:[1]
p queue.push(2) #输出:[1, 2]
p queue.push(3) #输出:[1, 2, 3]
p queue.shift #输出:1
p queue.push(4) #输出:[2, 3, 4]
p queue.push(5) #输出:[2, 3, 4, 5]
p queue.shift #输出:2
p queue.shift #输出:3
p queue.shift #输出:4
p queue.push(6) #输出:[5, 6]
p queue.clear #输出:[]
[/pre]
4. first(第一个), last(最后一个)
[pre lang="ruby"]
#变量赋值
arr = ["a","b","c","d","e"]
#获取数组里的第一个元素
p arr.first #输出:"a"
#获取数组里的最后一个元素
p arr.last #输出:"e"
[/pre]
5. insert(注入), delete(删除), delete_at(从指定位置删除)
[pre lang="ruby"]
#insert用于往数组的指定位置注入元素(位置可以是负数)
#此方法返回成功注入的数值。如果注入失败会返回nil。
#格式:insert(位置,元素)
arr = [1,2,3,4,5]
arr.insert(3,6)
p arr #输出:[1, 2, 3, 6, 4, 5]
#delete用于删除数组里的指定元素
#如果有重复的元素,全部都会被删除
#此方法返回成功被删除的数值。如果删除失败会返回nil。
arr = [1,3,3,4,5,6,7]
arr.delete(3)
p arr #输出:[1,4,5,6,7]
arr.delete(5)
p arr #输出:[1,4,6,7]
#delete_at用于删除数组里指定位置的元素(位置可以是负数)
#此方法返回成功被删除的数值。如果删除失败会返回nil。
arr = [1, 2, 3, 4, 5, 6, 7]
arr.delete_at(3)
p arr #输出:[1, 2, 3, 5, 6, 7]
[/pre]
6. shuffle(随机洗牌), shuffle!(毁灭性随机洗牌), sample(随机取样)
[pre lang="ruby"]
#shuffle用于获取随机排序(洗牌)后的新数组
arr = [1,2,3,4,5,6,7,8]
p arr.shuffle #输出:[3, 5, 1, 6, 4, 7, 2, 8] (随机)
#后缀!的方法是毁灭性操作,也就是会影响原本的数组
arr = [1,2,3,4,5,6,7,8]
arr.shuffle!
p arr #输出:[8, 7, 5, 1, 2, 4, 6, 3] (随机)
#sample用于获取1个(返回整数)或多个(不重复,最多到数组的长度)随机元素
arr = [1,2,3,4,5,6,7,8]
p arr.sample #输出:6 (随机)
p arr.sample(3) #输出:[7, 8, 5] (随机)
p arr.sample(20) #输出:[1, 3, 5, 4, 7, 2, 6, 8] (随机,最多到arr的长度罢了)
[/pre]
7. index(获取索引值),rindex(反向获取索引值)
[pre lang="ruby"]
#递入一个参数,尝试获取它在数组内第一个匹配元素的索引值,如果找不到则返回nil
#rindex则是尝试获取数组内最后一个匹配的索引值
arr = [2,3,4,5,7,3,4,5]
p arr.index(4) #输出:2
p arr.rindex(4) #输出:6
p arr.index(9) #输出:nil
p arr.rindex(9) #输出:nil
#这两个方法也可以接受代码块(一个局部变量,代表元素)来迭代并返回第一个通过判断的元素的索引值
#index是从第一个元素开始迭代,而rindex是从最后一个元素开始迭代
arr = [1,6,9,3,5,2,1,4]
p arr.index{|i| i >= 5} #输出:1
p arr.rindex{|i| i >= 5} #输出:4
[/pre]
8. values_at(元素提取)
[pre lang="ruby"]
#变量赋值
arr = [1,3,5,7,9,11,13,15]
#元素提取递入的参数最少一个,最多无限
#提取的元素会作为新的数组而返回
p arr.values_at(3) #输出:[7] (与p [arr[3]] 相同)
p arr.values_at(0, 4, 6, 7) #输出:[1, 9, 13, 15] (与p [arr[0], arr[4], arr[6], arr[7]] 相同)
p arr.values_at(-1, 5, -5) #输出:[15, 11, 7] (与p [arr[-1], arr[5], att[-5]] 相同)
[/pre]
9. select(选择), select!(毁灭性选择), keep_if(条件保留)
[pre lang="ruby"]
#使用select时递入代码块,接受元素为局部变量
#所有通过判断的元素将会作为新的数组返回
arr = [1,2,3,4,5,6,7,8,9]
arr1 = arr.select do |i|
i < 5 || i == 8
end
p arr1 #输出:[1,2,3,4,8]
p arr #输出:[1,2,3,4,5,6,7,8,9](arr不受影响)
#后缀!的方法是毁灭性操作,也就是会影响原本的数组
#select!和keep_if的功能是一样的,只是名字不同
arr = [1,2,3,4,5,6,7,8,9]
arr1 = arr.select! do |i|
i < 5 || i == 8
end
p arr1 #输出:[1,2,3,4,8]
p arr #输出:[1,2,3,4,8](arr已被更改)
[/pre]
10. reject(反选择), reject!(毁灭性反选择), delete_if(条件删除)
[pre lang="ruby"]
#使用reject时递入代码块,接受元素为局部变量
#所有通过判断的元素将会作为新的数组返回
arr = [1,2,3,4,5,6,7,8,9]
arr1 = arr.reject do |i|
i < 5 || i == 8
end
p arr1 #输出:[5,6,7,9]
p arr #输出:[1,2,3,4,5,6,7,8,9](arr不受影响)
#后缀!的方法是毁灭性操作,也就是会影响原本的数组
#reject!和delete_if的功能是一样的,只是名字不同
arr = [1,2,3,4,5,6,7,8,9]
arr1 = arr.reject! do |i|
i < 5 || i == 8
end
p arr1 #输出:[5, 6, 7, 9]
p arr #输出:[5, 6, 7, 9] (arr已被更改)
[/pre]
11. reverse(反转顺序), reverse!(毁灭性反转顺序)
[pre lang="ruby"]
#反转数组内元素的顺序,作为新的数组返回
arr = [1,2,3,4,5,6,7,8]
p arr.reverse #输出:[8, 7, 6, 5, 4, 3, 2, 1]
#后缀!的方法是毁灭性操作,也就是会影响原本的数组
arr = [1,2,3,4,5,6,7,8]
arr.reverse!
p arr #输出:[8, 7, 6, 5, 4, 3, 2, 1]
[/pre]
12. uniq(移除重复元素,unique的缩写), uniq!(毁灭性移除重复元素)
[pre lang="ruby"]
#移除数组内的重复元素(每项只留一个),作为新的数组返回
arr = [1,2,2,2,3,3,3,3,5,6,9,9,0]
p arr.uniq #输出:[1, 2, 3, 5, 6, 9, 0]
#后缀!的方法是毁灭性操作,也就是会影响原本的数组
arr = [1,2,2,2,3,3,3,3,5,6,9,9,0]
arr.uniq!
p arr #输出:[1, 2, 3, 5, 6, 9, 0]
[/pre]
13. sort(排序), sort!(毁灭性排序)
[pre lang="ruby"]
#对数组内的元素做出排序,作为新的数组返回
arr = [6,7,4,5,2,3,9,6,7,3,1]
p arr.sort #输出:[1, 2, 3, 3, 4, 5, 6, 6, 7, 7, 9]
#后缀!的方法是毁灭性操作,也就是会影响原本的数组
arr = [6,7,4,5,2,3,9,6,7,3,1]
arr.sort!
p arr #输出:[1, 2, 3, 3, 4, 5, 6, 6, 7, 7, 9]
[/pre]
14. slice(分割), slice!(毁灭性分割)
[pre lang="ruby"]
#slice和[]元素引用的功能相似
arr = [1,3,5,7,9,11,13,15]
p arr.slice(5) #输出:11 (与arr[5]相同)
p arr.slice(-2) #输出:13(与arr[-2]相同)
p arr.slice(3,2) #输出:[3, 5, 7](与arr[3,2]相同)
#slice!是毁灭性的,也就是取出的数值会从数组里删除
arr = [1,3,5,7,9,11,13,15]
p arr.slice!(5) #输出:11
p arr #输出:[1, 3, 5, 7, 9, 13, 15] (可以看到11已经被删除了)
p arr.slice!(2..5) #输出:[5, 7, 9, 13]
p arr #输出:[1, 3, 15]
[/pre]
15. compact(移除空值), compact!(毁灭性移除空值)
[pre lang="ruby"]
#移除所有在数组里的空值(nil),作为新的数组返回
arr = [1,7,nil,3,nil,nil,5,8,9]
p arr.compact #输出:[1, 7, 3, 5, 8, 9]
#后缀!的方法是毁灭性操作,也就是会影响原本的数组
arr = [1,7,nil,3,nil,nil,5,8,9]
arr.compact!
p arr #输出:[1, 7, 3, 5, 8, 9]
[/pre]
16. rotate(旋转), rotate!(毁灭性旋转)
[pre lang="ruby"]
#按照递入的参数而执行向左(正数)或向右(负数)的“整体移动”,作为新的数组返回
arr = [1, 2, 3, 4, 5, 6, 7, 8]
p arr.rotate(2) #输出:[3, 4, 5, 6, 7, 8, 1, 2] (向左整体移动2步)
p arr.rotate(4) #输出:[5, 6, 7, 8, 1, 2, 3, 4] (向左整体移动4步)
p arr.rotate(-1) #输出:[8, 1, 2, 3, 4, 5, 6, 7] (向右整体移动1步)
p arr.rotate(-3) #输出:[6, 7, 8, 1, 2, 3, 4, 5] (向右整体移动3步)
#后缀!的方法是毁灭性操作,也就是会影响原本的数组
arr = [1, 2, 3, 4, 5, 6, 7, 8]
arr.rotate!(2)
p arr #输出:[3, 4, 5, 6, 7, 8, 1, 2]
[/pre]
17. collect/map(集合), collect!/map!(毁灭性集合)
[pre lang="ruby"]
#迭代数组里面的每个元素,把计算的结果整合并作为新的数组返回
#collect和map的功能是一样的,只是名字不同
arr = [1, 2, 3, 4, 5, 6, 7, 8]
arr1 = arr.collect do |i|
i *= 2
end
p arr1 #输出:[2, 4, 6, 8, 10, 12, 14, 16]
#后缀!的方法是毁灭性操作,也就是会影响原本的数组
arr = [1, 2, 3, 4, 5, 6, 7, 8]
arr.collect! do |i|
i *= 2
end
p arr #输出:[2, 4, 6, 8, 10, 12, 14, 16]
[/pre]
18. inject(集合迭代计算)
[pre lang="ruby"]
#迭代数组里面的每一个元素,对一个变量做出计算
#接受一个参数和一个代码块。参数是变量的初始值,代码块接受2个局部变量(变量,元素)。
arr = [1, 2, 3, 4, 5, 6, 7, 8]
a = arr.inject(5) do |v,i| #v是变量,i是元素
v += i
end
p a #输出:41 (注:5 + (1 + 2 + 3 + 4 + 5 + 6 + 7 + 8) = 41)
[/pre]
I - 哈希表内置方法
1. empty?(判断是否为空)
[pre lang="ruby"]
#变量赋值
a = {}
b = {1 => 2, 3 => 4}
#判断哈希表是否是空着的
p a.empty? #输出:true
p b.empty? #输出:false
[/pre]
2. default(默认值), default=(设置默认值)
默认值在“哈希表”的部分提及过。如果使用[]尝试取出值时找不到键的话,会返回默认值。
[pre lang="ruby"]
#变量赋值
hash = {1 => 2, 3 => 4, 5 => 6}
#查看当前默认值
p hash.default #输出:nil
p hash[3] #输出:4
p hash[7] #输出:nil
#设置默认值
hash.default = 666
p hash.default #输出:666
p hash[3] #输出:4
p hash[7] #输出:666
[/pre]
3. include? / has_key?(判断是否存在键), has_value?(判断是否存在值)
[pre lang="ruby"]
#变量赋值
hash = {1 => "a", 3 => "b", 5 => "c"}
#判断是否存在键
p hash.include?(3) #输出:true
p hash.has_key?(3) #输出:true
p hash.include?(4) #输出:false
p hash.has_key?(4) #输出:false
#判断是否存在值
p hash.has_value?("b") #输出:true
p hash.has_value?("x") #输出:false
[/pre]
4. keys(获取所有键), values(获取所有值), flatten(铺平成数组)
[pre lang="ruby"]
#变量赋值
hash = {1 => "a", 3 => "b", 5 => "c"}
#获取装有所有键的数组
p hash.keys #输出:[1, 3, 5]
#获取装有所有值的数组
p hash.values #输出:["a", "b", "c"]
#将哈希表铺平成数组(这和to_a不一样,铺平后是一维数组而不是二维)
p hash.flatten #输出:[1, "a", 3, "b", 5, "c"]
[/pre]
5. length(长度), size(大小)
length和size都是获取哈希表内键值配对的数量
[pre lang="ruby"]
#变量赋值
hash = {}
hash1 = {"a" => "c"}
hash2 = {1 => 2, 2 => 3, 3 => 4, 5 => 7}
#获取键值配对的数量
p hash.length #输出:0
p hash.size #输出:0
p hash1.length #输出:1
p hash1.size #输出:1
p hash2.length #输出:4
p hash2.size #输出:4
[/pre]
6. invert(反转键与值)
[pre lang="ruby"]
#变量赋值
hash = {1 => "a", 3 => "b", 5 => "c"}
#获取一个新的哈希表,键与值是反过来了的
p hash.invert #输出:{"a" => 1, "b" => 3, "c" => 5}
[/pre]
7. clear(清空),delete(删除)
[pre lang="ruby"]
#清空哈希表
hash = {1 => 2, 3 => 4, 5 => 6}
hash.clear
p hash #输出:{}
#根据递入的键删除哈希表内的键值配对,会返回删除的值
#如果找不到键,就会返回nil,而哈希表不会受影响
hash = {1 => "z", 3 => "x", 5 => "c"}
p hash.delete(7) #输出:nil (没有找到该键值配对)
p hash.delete(3) #输出:"x"
p hash #输出:{1 => "z", 5 => "c"} (3 => "x"这个配对已经被删除了)
[/pre]
8. merge(合并), merge!(毁灭性合并)
[pre lang="ruby"]
#哈希表没有如数组般的加法运算,而是需要调用merge方法来进行合并
#递入的哈希表的键值配对会覆盖原本哈希表已有的键值配对
#合并的结果将作为新的哈希表而返回
hash = {1 => "a", 3 => "b", 5 => "c"}
hash1 = {1 => "x", 2 => "y", 3 => "z"}
p hash.merge(hash1) #输出:{1=>"x", 3=>"z", 5=>"c", 2=>"y"}
p hash #输出:{1 => "a", 3 => "b", 5 => "c"}(hash不受影响)
#后缀!的方法是毁灭性操作,也就是会影响原本的哈希表
hash = {1 => "a", 3 => "b", 5 => "c"}
hash1 = {1 => "x", 2 => "y", 3 => "z"}
p hash.merge!(hash1) #输出:{1=>"x", 3=>"z", 5=>"c", 2=>"y"}
p hash #输出:{1=>"x", 3=>"z", 5=>"c", 2=>"y"} (hash已被更改)
[/pre]
9. select(选择), select!(毁灭性选择), keep_if(条件保留)
[pre lang="ruby"]
#使用select时递入代码块,接受键和值两个局部变量
#所有通过判断的键值配对将会作为新的哈希表返回
hash = {1 => "a", 3 => "b", 5 => "c", 7 => "d", 9 => "e"}
hash1 = hash.select do |key, value| #key是键,value是值
key < 5 || value == "e"
end
p hash1 #输出:{1 => "a", 3 => "b", 9 => "e"}
p hash #输出:{1 => "a", 3 => "b", 5 => "c", 7 => "d", 9 => "e"}(hash不受影响)
#后缀!的方法是毁灭性操作,也就是会影响原本的哈希表
#select!和keep_if的功能是一样的,只是名字不同
hash = {1 => "a", 3 => "b", 5 => "c", 7 => "d", 9 => "e"}
hash1 = hash.select! do |key, value| #key是键,value是值
key < 5 || value == "e"
end
p hash1 #输出:{1 => "a", 3 => "b", 9 => "e"}
p hash #输出:{1 => "a", 3 => "b", 9 => "e"}(hash已被更改)
[/pre]
10. reject(反选择), reject!(毁灭性反选择), delete_if(条件删除)
[pre lang="ruby"]
#使用reject时递入代码块,接受键和值两个局部变量
#所有不通过判断的键值配对将会作为新的哈希表返回
hash = {1 => "a", 3 => "b", 5 => "c", 7 => "d", 9 => "e"}
hash1 = hash.reject do |key, value| #key是键,value是值
key < 5 || value == "e"
end
p hash1 #输出:{5 => "c", 7 => "d"}
p hash #输出:{1 => "a", 3 => "b", 5 => "c", 7 => "d", 9 => "e"}(hash不受影响)
#后缀!的方法是毁灭性操作,也就是会影响原本的哈希表
#reject!和delete_if的功能是一样的,只是名字不同
hash = {1 => "a", 3 => "b", 5 => "c", 7 => "d", 9 => "e"}
hash1 = hash.reject! do |key, value| #key是键,value是值
key < 5 || value == "e"
end
p hash1 #输出:{5 => "c", 7 => "d"}
p hash #输出:{5 => "c", 7 => "d"}(hash已被更改)
[/pre]
11. sort(转换成数组后排序)
[pre lang="ruby"]
#哈希表没有直接排序的方法,因为本来就不注重顺序
#因此要排序的话,是先转换成数组再排序的
hash = {3 => "b", 7 => "d", 1 => "a", 9 => "e", 5 => "c"}
p hash.sort #输出:[[1, "a"], [3, "b"], [5, "c"], [7, "d"], [9, "e"]]
#默认的hash.sort和hash.to_a.sort是一样的,因为是先转换成数组再排序
[/pre]
12. Hash[](基于数组创建哈希表)注:这不是调用的方法
[pre lang="ruby"]
#哈希表在使to_a或sort转换成数组后(flatten不行),或者格式相同的数组可以再次被转换成哈希表
#使用格式是Hash[数组],我们会用上面sort的例子来作为范例
arr = [[1, "a"], [3, "b"], [5, "c"], [7, "d"], [9, "e"]]
hash = Hash[arr]
p hash #输出:{1 => "a", 3 => "b", 5 => "c", 7 => "d", 9 => "e"}
#所以将sort和Hash[]混合使用后,得出哈希表真正的排序语句
hash = {3 => "b", 7 => "d", 1 => "a", 9 => "e", 5 => "c"}
hash1 = Hash[hash.sort]
p hash1 #输出:{1 => "a", 3 => "b", 5 => "c", 7 => "d", 9 => "e"}
[/pre]
2.1 面向对象
展开折叠
面向对象编程(Object-oriented programming, 缩写为OOP)是一种具有对象(Object)概念的编程范型(模范,方法),同时也是一种程序开发的方法。
它将对象作为程序的基本单元,将程序和数据封装其中,以提高软件的重用性、灵活性和扩展性。对象里的程序可以访问及经常修改对象相关连的数据。
在面向对象程序编程里,计算机程序会被设计成彼此相关的对象。
(参考:维基百科)
什么是对象?
打开脚本编辑器,我们可以看到大部分默认脚本里都有一个关键字:class。
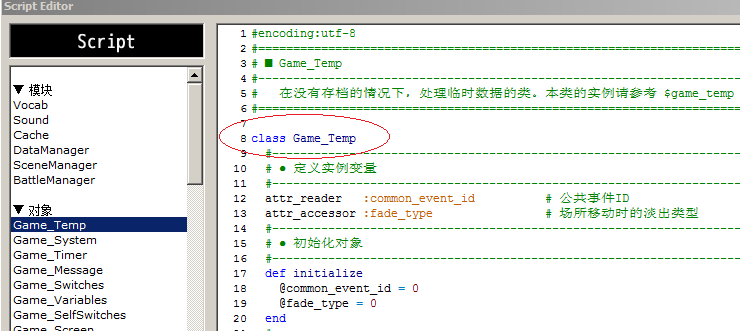
这个关键词用于定义一个类,也就是数据类型的蓝图。
对象,就是类的实例,是基于数据类型的蓝图所创造出来的一个“物件”。
它拥有自己的变量,拥有自己的方法,也可以与其他对象交互。
上面的附图内显示的,是Game_Temp这个类的定义(详细信息请看绿字注释)。
它的实例在创建后将被储存在$game_temp这个变量里面。$是什么意思呢?这个我们之后会提到。
在Ruby里面,一切都是对象。一切数据,不管是整数、字符串还是数组,都是基于类而创建的,更不用说自定义的数据类型。
类本身也是对象。这一个特性我们会在之后关于“模块”的部分进一步探讨。
如果到这儿还是无法明白的话,请看浓缩版本的吧:
类(Class),是数据类型的蓝图,定义着方法和会用到的变量。
对象(Object),是基于类而创造出来的实例(Instance,实际例子),有着属于自己的一套方法和变量。
2.2 类与实例
展开折叠
重要的事情要说三次!所以,再说一次!类是数据类型的蓝图!对象是基于类而创造出来的实例!
在定义一个类的时候,我们需要用class关键词。格式如下:
[pre lang="ruby"]
class 类的名字
(内容)
end
[/pre]
类的内容可以是调用方法(在游戏开始时会进行处理),设置变量/常量,或者是定义方法。
在完成定义后,这个蓝图会作为一个对象被存在与类的名字相同的常量里。(这就是为啥之前说过,类也是对象)
那么,我们可以调用它的new方法来创建实例。嗯…new…这个方法…好像哪儿见过,对吧?
没错,Array.new就是手动创建一个数组(Array)的实例而Hash.new是手动创建一个哈希表(Hash)的实例。
让我们来定义一个空的类,并尝试创造它的实例吧。而且不止一个,要三个!
[pre lang="ruby"]
#定义类
class AAA
#暂无内容
end
#创建实例
a = AAA.new
b = AAA.new
c = AAA.new
#显示数据
p a
p b
p c
[/pre]
好,那么在RMVA里面运行以上列出的代码之后,我们会看到控制台上显示着这么样的玩意儿:(注:后边的十六进制数是随机的)
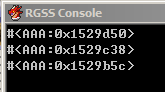
这…是啥?AAA是类的名字没错,但是后面的十六进制数是什么东西?为什么显示的三个变量,那串十六进制数都不一样?
这是它的对象ID。就算是基于同个类所创造的,不同的实例,对象ID是不一样的。换句话说,相同的实例,对象ID是一样的。
就像身份证号。同样都是人类,你的身份证号和他的身份证号是不同的,代表着是不同的两个人。
那么我们可以总结,以上的代码基于一个类,生成了三个不同的实例。如何证明它们的不同?看对象ID就知道了。
接下来,我们来尝试运行这段代码。
[pre lang="ruby"]
#定义类
class AAA
#暂无内容
end
#创建实例
a = AAA.new
b = a
c = b
#显示数据
p a
p b
p c
[/pre]
输出:
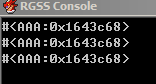
嗯?三个都一样?那就是说… a, b和c三个变量所存着的,是同一个对象?
没错。在执行 a = AAA.new 这个语句的时候, 我们基于AAA类创建了一个实例,然后把它的引用(reference)赋值给变量a。
因此,在执行b = a,c = b这两句的时候,是基于这个引用来赋值的。好,那么问题来了。什么叫引用?
在Ruby语言里面,我们可以这么形容:假设一个电脑机房内的每个电脑都有自己的密码,只有知道密码的人可以使用它。
这个情况下,如果把创建实例比喻为往这个机房里增添一台新电脑(类比喻为电脑的制造蓝图而它的实例就是那台电脑),那么引用相当于这台电脑的"密码"。
我们把对象的引用存到一个变量里后,就可以使用句号(.)来调用它的方法。这个我们在介绍"方法定义与调用"(章节1.4)时曾经提到过。
我们也可以将引用赋值给别的变量,甚至是作为参数来传递给别的方法。总而言之,有了引用,我们才能与一个对象做出互动。
如果引用没了呢?这就是另一个话题了。当一个对象被孤立(isolated)(整个程序的所有变量都没有它的引用),它就会被视为“垃圾”(garbage)。
Ruby自带的垃圾回收(garbage collection)系统会不定时地清理这种对象,以腾出内存空间,避免系统资源的浪费。
关于“垃圾回收”,我们之后会进一步地讨论。
2.3 实例方法与变量
展开折叠
类的定义里面包括方法和变量。每一个基于这个类而创建的实例,都会有这些方法和变量。
接下来,我们要介绍的是类的initialize(初始化)方法。它是在创造对象后立即调用的方法,一个对象的一生只会调用一次。
这个方法是选择性定义的。不过大部分的情况下,这个方法是需要用上的)
[pre lang="ruby"]
class AAA
def initialize
p "hello!!!"
end
end
a = AAA.new
#输出:
#"hello!!!"
[/pre]
我们也可以让initialize方法接受参数。这些参数在使用new方法创建对象的时候递入。
[pre lang="ruby"]
class AAA
def initialize(a,b)
p a + " " + b
end
end
a = AAA.new("66RPG","RPGMaker")
#输出:
#"66RPG RPGMaker"
[/pre]
initialize方法无法手动调用。尝试调用时会报错。
我们可以在类里面定义实例方法(instance method),也就是类的实例可以使用的方法。
[pre lang="ruby"]
class AAA
def initialize
p "初始化"
end
def add(a,b)
p a.to_s + " + " + b.to_s + " = " + (a+b).to_s
end
def sub(a,b)
p a.to_s + " - " + b.to_s + " = " + (a-b).to_s
end
end
a = AAA.new
a.add(5,6)
a.add(7,8)
a.sub(10,3)
a.sub(6,1)
#输出:
#"初始化"
#"5 + 6 = 11"
#"7 + 8 = 15"
#"10 - 3 = 7"
#"6 - 1 = 5"
[/pre]
当然在实例里面,方法是可以互相调用的(不过注意别搞出死循环来啊!就是a调用b,b调用a,然后就没有然后了)。
[pre lang="ruby"]
class AAA
def abc
cde
end
def cde
p "hello!"
end
end
a = AAA.new
a.abc #输出:"hello!"
[/pre]
我们在读默认脚本的时候,常见到一个关键词:self(自身)。就如这个英文单词的意思,它的用途是获取这个对象自身的引用。
self可以用于修饰类里面的,对于自身实例方法的调用(更容易辨认)。
[pre lang="ruby"]
class AAA
def abc
self.cde #前面有没有加self都没差的,加了只是为了好看/更容易辨认
end
def cde
p "hello!"
end
end
a = AAA.new
a.abc #输出:"hello!"
[/pre]
使用self获取的引用当然可以给变量赋值,还能作为参数递给其他方法。这我们就不再提及了。
self的另一个使用法就是作为返回数据以达成调用链的功效。这是艺术啊!
[pre lang="ruby"]
class AAA
def add(a,b)
p a.to_s + " + " + b.to_s + " = " + (a+b).to_s
return self #返回自身的引用
end
def sub(a,b)
p a.to_s + " - " + b.to_s + " = " + (a-b).to_s
return self #返回自身的引用
end
end
a = AAA.new
a.add(1,2).sub(4,3).add(6,7).sub(9,5)
#输出:
#"1 + 2 = 3"
#"4 - 3 = 1"
#"6 + 7 = 13"
#"9 - 5 = 4"
[/pre]
如果看不懂这条“调用链”的运作原理的话,可以看看下面的详解:
[pre lang="ruby"]
注:此代码无法运行
a.add(1,2).sub(4,3).add(6,7).sub(9,5)
相等于
b = a.add(1,2)
c = b.sub(4,3)
d = c.add(6,7)
e = d.sub(9,5)
[/pre]
实际上只要是有返回数据的方法都能如此调用。
比如我们要把一个浮点数给向下取整了之后,转换成字符串:
[pre lang="ruby"]
#普通写法
a = 3.14159
a = a.round(2)
a = a.to_s
#调用链
a = (3.14159).round(2).to_s
[/pre]
为了代码的简洁,能尽量链起来的方法调用就链起来咯。当然宽度不够时就没办法了(如1.00版RMVA残念的事件脚本指令输入窗)。
在说完方法之后,是时候说变量了。我们在RMVA的默认脚本里见过很多种变量。@开头的有,@@开头的也有,$开头的也有,没前缀的当然有。
这些前缀是什么意思呢?没有前缀又是什么意思呢?那就让我们接着看下去吧!
没有前缀的变量,叫做局部变量(local variable)。它们所存在的领域(作用域)只有在一段代码块内,不论是方法,还是递入迭代器的代码块。
在代码块执行完毕后,这个变量就会失效了。如果一个对象的所有引用都失效,那么它就会因为被“孤立”而被垃圾回收机制不定时清除。
局部变量必须先赋值才能被读取,否则将会报错。
[pre lang="ruby"]
a = 10
b += a #报错!局部变量b未赋值!
a = 10
b = 0
b += a #没问题
[/pre]
局部变量作用域范例 - 代码块:
[pre lang="ruby"]
5.times{|i| print i} #输出:01234
p i #报错!局部变量i未赋值!
[/pre]
局部变量作用域的范例 - 方法:
[pre lang="ruby"]
def abc(a)
b = 5
return a + b
end
abc(10)
p b #报错!局部变量b未赋值!
[/pre]
局部变量和无参数的方法调用时非常相似。因此,如果出现撞名的情况,较后定义的会生效。
[pre lang="ruby"]
def a
return 10
end
def b
a = 2
return a + 5
end
p b #输出:7
[/pre]
如果没有 a = 2 这行呢?
[pre lang="ruby"]
def a
return 10
end
def b
return a + 5
end
p b #输出:15
[/pre]
由此可见,系统如果找不到该代码块内有能用的局部变量,就会去找能用的方法了。两个都没有?报错啊。
虽然如此,我们可以使用self(获取对象自身的引用)来指定调用方法(而不是用局部变量)。
[pre lang="ruby"]
def a
return 10
end
def b
a = 2
return self.a + 5
end
p b #输出:15
[/pre]
不过最好还是尽可能避免出现实例方法和局部变量撞名的情况。
说完了局部变量,现在我们来说说实例变量(instance variable)。实例变量的前缀是@,如@hp,@map_id等等。
实例变量,就如其名,就是实例的变量。每个实例都有它自己的一套实例变量。就算是同一个名字,不同实例变量的值有可能不同。
实例变量装的可能是怪物的HP,可能是人物的经验值,就连屏幕上每一个图片的坐标,也都是存在实例变量里的。
一个类所会用到的实例变量一般在initialize(初始化)方法里面定义:
[pre lang="ruby"]
class Person #人
def initialize(age,height,weight)
@age = age #岁数
@height = height #高度
@weight = weight #重量
end
def show_info #显示讯息
p "岁数: " + @age.to_s + " 高度: " + @height.to_s + " 重量: " + @weight.to_s
end
end
a = Person.new(16,165,55)
b = Person.new(21,176,63)
a.show_info
b.show_info
p a
p b
#输出:
#岁数: 16 高度: 165 重量: 55
#岁数: 21 高度: 176 重量: 63
#<#Person:0x12345678 @age=16, @height=165, @weight=55> #注意:对象ID是瞎掰的,反正就是不同就对了
#<#Person:0x12347788 @age=21, @height=176, @weight=63>
[/pre]
从上面的例子中我们可以看到,Person类的两个实例,虽然都有“岁数”(@age),“高度”(@height)和“重量”(@weight)三个实例变变量,但是里面装着的数值都有可能不同。
就像在游戏内,就算是同样类型的怪物,怪物A和怪物B有着分开的HP和MP条,甚至可能连攻击数值都不同(如果有套用敌人数值浮动的脚本系统)。
实例变量只能在实例里面使用。如果要从外部引用来读取或赋值的话,要通过方法才行。毕竟引用符(句号 . )只能调用方法啊…
[pre lang="ruby"]
class AAA
def initialize
@abc = 666
end
end
a = AAA.new
p a.abc #报错:找不到方法"abc"
a.abc = 5 #也是会报错,找不到方法"abc="
[/pre]
从以上的例子我们可以知道,如果要对AAA类的@abc实例变量施行读取/写入操作,必须要定义方法abc和abc=才行。
当然不一定要方法名和实例变量名相同,不过为了方便使用,还是相同的比较好。
[pre lang="ruby"]
class AAA
def initialize
@abc = 666
end
def abc
return @abc
end
def abc=(v) #注意:什么变量名字都行,我个人习惯是v
@abc = v
end
end
a = AAA.new
p a.abc #输出:666
a.abc = 233
p a.abc #输出:233
[/pre]
不过这里又出了一个问题。我有很多很多实例变量啊!难道全部都要定义一个读取和一个写入方法吗?二十个三十个,根本吃不消啊!
这可以别担心。Ruby提供了三个可以在定义类时呼叫的方法:attr_reader(属性读取,attr是attribute的缩写), attr_writer(属性写入),attr_accessor(属性读写)。
这三个方法接受无限个符号作为参数。假设实例变量是@abc,那么符号就是:abc。
[pre lang="ruby"]
class AAA
attr_reader :a, :b #等同定义了 def a; return @a end 和 def b; return @b end
attr_writer :c, :d #等同定义了 def c=(v); @c = v end 和 def d=(v); @d = v end
attr_accessor :e, :f, :g #等同读取和写入方法都定义了
def initialize
@a = 1
@b = 2
@c = 3
@d = 4
@e = 5
@f = 6
@g = 7
end
end
v = AAA.new
p v.a #输出:1
p v.b #输出:2
p v.c #报错!没有定义读取方法!
p v.d #报错!没有定义读取方法!
p v.e #输出:5
p v.f #输出:6
p v.g #输出:7
p v.a = 9 #报错!没有定义写入方法!
p v.b = 8 #报错!没有定义写入方法!
p v.c = 7 #输出:7
p v.d = 6 #输出:6
p v.e = 5 #输出:5
p v.f = 4 #输出:4
p v.g = 3 #输出:3
[/pre]
是不是所有实例变量都要这么做呢?答案是,不,这要看情况。我们会在之后谈到“封装”的部分深入这一点。
如果要“删除”实例变量,那就给它赋值个nil(空值)就好。(如 @abc = nil)
Ruby是非常灵活的语言,但是这也表示…眼残没药医。如果我们把实例变量的名字打错了会发生什么事情呢?会报错吗?
答案是不会。如果一个实例里面的某个实例变量未赋值,那么尝试读取这个实例变量的时候,会得到nil(空值)。
因此,你搞错实例变量名字的地方不会直接报错,而是别的地方出乱子(比如找不到方法或者类型不搭而无法执行运算之类的)。
同样地,忘记初始化(反正就是读取之前必须赋值就对了)变量也会导致这种事情的发生,所以要多加小心啊。
接着,我们要介绍的是类变量(class variable)。它的前缀是@@。人家实例变量是一个@,类变量是两个@。
类变量在RMVA默认脚本里应用的地方非常少,只有Sprite_Base,Window_MenuCommand和Window_DebugLeft有用到。
类变量就是所有该类的实例共有的变量。不管从哪个实例读取这个变量,这个值都是一样的。
类变量的初始化不必,而且最好不要在方法里面进行。它的主要用途在于记忆一些需要保留给别的实例的数据。
与实例变量相似,类变量如果在未赋值的情况下尝试读取,会返回nil(空值)。
范例:类变量的初始化
[pre lang="ruby"]
class AAA
@@aaa = 233
def show_aaa
@@aaa
end
end
a = AAA.new
a.show_aaa #输出:233
b = AAA.new
a.show_aaa #输出:233
[/pre]
范例:类变量作为计数器的使用(用来生成实例的ID)
[pre lang="ruby"]
class AAA
@@count = 0 #初始化计量
def initialize
@@count += 1 #计量+1
@id = @@count #设置ID为计量
end
def show_id #显示ID
p "ID = " + @id.to_s
end
end
a = AAA.new
a.show_id #输出:ID = 1
b = AAA.new
b.show_id #输出:ID = 2
c = AAA.new
c.show_id #输出:ID = 3
[/pre]
类变量的这个用法可以记录实例创建的次序(ID越大的当然就越迟)。
范例:类变量作为数据记忆的使用:
[pre lang="ruby"]
class AAA
@@last_choice = "无" #上一个选项
def initialize(choice)
p "上一次的选项:" + @@last_choice + " ,这一次的选项:" + choice
@@last_choice = choice
end
end
AAA.new("一号") #输出:"上一次的选项:无 ,这一次的选项:一号"
AAA.new("三号") #输出:"上一次的选项:一号 ,这一次的选项:三号"
AAA.new("五号") #输出:"上一次的选项:三号 ,这一次的选项:五号"
[/pre]
最后,就是最万恶的,以$为前缀的全局变量(global variable)。全局变量,字面上的意思,就是那儿都能用的变量。
滥用全局变量真爽啊!不,别这样做。这是因为这会让代码非常难读,而且如果搞不好的话,可能会有冲突的危机。(脑子真的清醒的话…嗯随便吧)
全局变量与实例变量和类变量相似,未赋值的情况下尝试读取会获得nil(空值)。
范例:全局变量的“威能”
[pre lang="ruby"]
class AAA
def abc
$xyz += 5
end
def cde
$xyz = 2
end
def efg
p $xyz + 3
end
end
a = AAA.new
$xyz = 6
a.abc
p $xyz #输出:11
a.efg #输出:14
$xyz = 3
a.efg #输出:6
a.cde
p $xyz #输出:2
[/pre]
全局变量在任何地方都可以被任何对象执行读取或写入的操作。它所引用对象的实例方法也可以在任何时候,在任何地方被调用。
RMVA默认脚本里面,大部分主要游戏对象(前缀Game_)的引用都是由全局变量存着的。比如地图(Game_Map)的实例是存是在$game_map里的。
公共开关是存在$game_switches里面的,而公共变量是存在$game_variables里面的。(它们两个都类似数组,可以用[]和[]=运算符来读取/赋值)
比如呢,对6号公共变量赋值233,就是$game_variables[6] = 233。打开66号公共开关的话,$game_switches[66] = true。
不管是在脚本编辑器内甚至是事件脚本指令(包括行动路径的),都可以如此来运用公共开关和公共变量。
关于哪个游戏对象是哪个全局变量存着的详细列表,请参考本教程的附录。
2.4 封装、继承与多态
展开折叠
面向对象编程的三个基本特征分别是封装(Encapsulation),继承(Inheritance)和多态(Polymorphism)。
在这个部分里面,我们将陆续地认识这些特征的意思,和Ruby为了体现这些特征而准备的语句和机制。
A - 封装
封装是对象和类概念的主要特性,主要概念是“把对象的属性(实例变量)和行为(实例方法)结合成一个独立的单位,并尽可能隐蔽内部细节”。
假设我们有一个用陶瓷封装起来的集成电路芯片。既然封装起来了,里面的电路构造当然也就看不见。作为使用者的我们不需要去关心芯片内部的构造。
我们只需要知道这个芯片有多少个引脚,它的电气参数(如电压,电阻)有啥,每个引脚各自的功用,当然还有这个芯片是用来干什么的。
在面向对象编程里,封装的效果是让对象以外的部分不能随意访问该对象的实例变量和方法。
Ruby默认的情况下,除了initialize(初始化)的所有方法都是公开(public)的。也就是说,只要有这个对象的引用,就能调用它的实例方法。
Ruby提供了两个可以在定义类时呼叫的方法:private和protected。(使用法同attr_reader, attr_writer和attr_accessor)
private(私有)让指定的方法无法通过引用来调用(包括self)。如果从外部调用就会报错。initialize方法默认是这个样的。
protected(保护)和private类似,但是可以透过self获取的,自身的引用来调用这个方法。
[pre lang="ruby"]
class AAA
private :abc #设置方法abc为私有
protected :cde #设置方法abc为被保护
def abc; end
def cde; end
def efg; end
def test #内部测试
abc #没问题
cde #没问题
self.abc #报错:私有方法无法被调用
self.cde #没问题
end
end
a = AAA.new
a.test #开始内部测试
a.abc #报错:私有方法无法被调用
a.cde #报错:被保护的方法无法被调用
a.efg #没问题
[/pre]
Ruby的实例变量默认是私有的(无法从外部读写)。想要“公开”实例变量,我们就得定义读取和写入的方法。
定义类时可以调用attr_accessor的方法快速完成基本读写方法的定义。这些我们在上一个部分就提到过了。
可是,在RMVA默认脚本里面没有用到private和protected啊?
的确是没用到。而且上面也提到过,这是一种概念。只要不让对象的变量和方法被随意调用,就算是达成了封装。
什么是随意调用?为什么要避免这种情况?我们直接看下面的范例。
[pre lang="ruby"]
class Square #正方形
#定义读写方法(将实例变量公开)
attr_accessor :side_length, :area, :perimeter
def initialize(v)
raise "错误!边长必须超过0!" if v <= 0
@side_length = v #边长
@area = v ** 2 #面积,边长的次方
@perimeter = v * 4 #周长,边长的4倍
end
end
square = Square.new(10) #创建一个“正方形”类的实例,初始化边长为10
p square.side_length.to_s + " " + square.area.to_s + " " + square.perimeter.to_s #输出:10 100 40
#如果我们要换个边长的话…
square.side_length = 20
square.area = 20 ** 2
square.perimeter = 20 * 4
p square.side_length.to_s + " " + square.area.to_s + " " + square.perimeter.to_s #输出:20 400 80
#好,现在我们来看乱改会发生什么事…
##啥?居然毫无防备地被乱改了?这不就出事了吗?
square.side_length = -555
square.area = 999
square.perimeter = 233
p square.side_length.to_s + " " + square.area.to_s + " " + square.perimeter.to_s #输出:-555 999 233
[/pre]
在这个“正方形”类里面,用到的实例变量全都公开出去了。不止是读,还有写。
如果别的对象从外部误用了不该调用的方法,或者动了不该被修改的变量(用attr_writer/accessor增添了写入方法)呢?
这些,我们都说不准。如果出了问题,要除错也是个费时费力的事。
那么如果用正确的封装法的话:
[pre lang="ruby"]
class Square #正方形
#定义读取方法(唯读)
attr_reader :side_length, :area, :perimeter
def initialize(v)
self.side_length = v
end
def side_length=(v)
raise "错误!边长必须超过0!" if v <= 0
@side_length = v #设置边长
@area = v ** 2 #面积 = 边长的次方
@perimeter = v * 4 #周长 = 边长的4倍
end
def area=(v)
raise "错误!面积必须超过0!" if v <= 0
@area = v #设置面积
@side_length = Math.sqrt(v) #边长 = 面积的方根
@perimeter = @side_length * 4 #周长 = 边长的4倍
end
def perimeter=(v)
raise "错误!周长必须超过0!" if v <= 0
@perimeter = v #设置周长
@side_length = v / 4 #边长 = 周长除于4
@area = @side_length ** 2 #面积 = 边长的次方
end
end
#创建实例
square = Square.new(10)
p square.side_length.to_s + " " + square.area.to_s + " " + square.perimeter.to_s #输出:10 100 40
#透过调用特制的方法来设置变量
#我们可以看到,其他的变量也跟着做调整,而且有对错误参数的处理机制
square.set_side_length(-555) #报错:错误!边长必须超过0!
square.set_side_length(40)
p square.side_length.to_s + " " + square.area.to_s + " " + square.perimeter.to_s #输出:40 1600 160
square.set_area(144)
p square.side_length.to_s + " " + square.area.to_s + " " + square.perimeter.to_s #输出:12 144 48
square.set_perimeter(32)
p square.side_length.to_s + " " + square.area.to_s + " " + square.perimeter.to_s #输出:8 64 32
[/pre]
封装不只是能够减少外部调用导致的错误。如果是方法本身出错,修改那个方法就好。或许说,我们可以更快知道出错的地方,并施于修复。
当然了,一味地强调封装反而会给写代码的过程带来负担而失去意义。因此,一切都要看实际情况而定。
一般为RMVA写插件脚本的情况下,只要搞清楚方法的调用是否会跳过某些重要的步骤而出现意想不到的结果,并尽量避免这种情况就行了。
B - 继承
继承是两个类之间的一种关系。我们可以定义一个子类(child class/subclass)来继承父类(parent class)的方法。
在Ruby里定义类时,我们可以给它指定一个超类(superclass)。格式是:class 子类名 < 父类名 。
[pre lang="ruby"]
class AAA
attr_accessor :abc
def initialize
@abc = 666
end
def hello
p "hello!"
end
end
class BBB < AAA
def cde
p "23333! " + @abc.to_s
end
end
a = AAA.new
p a.abc #输出:666
a.abc = 55
p a.abc #输出:55
a.hello #输出:"hello!"
a.cde #报错:找不到方法!
b = BBB.new
b a.abc #输出:666
b.abc = 55
b a.abc #输出:55
b.hello #输出:"hello!"
b.cde #输出:"23333! 55"
[/pre]
从上面的例子我们可以看到,BBB类继承了AAA类的方法,而且增添了新的方法。
(注:不提变量是因为Ruby的实例变量在第一次赋值时才当场创建的,所以继承了方法相当于继承了变量)
为什么要这么做呢?这是因为,子类(继承的类)和父类(被继承的类)有“是一种”(is a)的关系。继承是为了强调这一点。
猫和狗都是哺乳动物。消防员和警察都是公务员。四方形和三角形都是形状。武器和护甲都是装备。
我们就用猫和狗来当例子好了。
[pre lang="ruby"]
class Mammal #哺乳动物
def breathe #呼吸
"吸气~ 呼气~"
end
end
class Cat < Mammal #猫
def meow #喵喵叫
"喵~"
end
end
class Dog < Mammal #狗
def bark #汪汪叫
"汪!"
end
end
#创建实例和调用
cat = Cat.new
cat.breathe #输出:"吸气~ 呼气~"
cat.meow #输出:"喵~"
dog = Dog.new
dog.breathe #输出:"吸气~ 呼气~"
dog.meow #输出:""汪!"
[/pre]
我们可以见到的是,Cat和Dog这两个类都拥有Mammal类的方法(在这个例子里是breathe。哺乳动物都是会呼吸的嘛)。
这两个派生(derive)出来的子类有着自己的方法。猫会喵喵叫,狗会汪汪叫。这是没问题的。
因此,继承的一个重要意义就是特化(specialize)一个类,让它进一步地表现出它的功能和特性。
从RMXP跳槽过来的RMVA新手们(假设已经到了会改脚本的阶段)可能会在这里遇到一些问题。
RMVA默认脚本大肆运用了继承(和另一个面向对象基本特征:多态),让同一段代码可以被重复使用。
什么意思呢?非常简单。如果两个(或多个)类的内容非常相似,那就把一样的地方拿出来做成超类,让这两个类继承它。
最明显的例子就是Scene_MenuBase(菜单场景的基底)和继承它的Scene_Menu(主菜单场景),Scene_Equip(装备菜单场景)等等。
附图:RMVA默认场景的继承关系
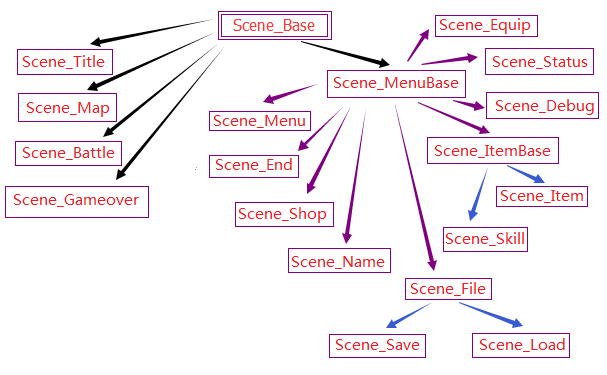
主菜单,装备菜单,技能菜单,道具菜单,存档菜单等等,这些场景的共同点是什么?背景是半透明的啊。
怎么做到的?将地图画面截图之后施行模糊化和调色,然后作为场景的背景贴图。(详细内容请自行参考Scene_MenuBase的方法)
当然,这些菜单场景共同的方法还有帮助窗口(如装备和物品描述)的生成,和角色的切换。
虽然如此,并不是所有重复的代码都适合用继承的概念来简化,尤其是会影响可读性和导致难以理解的时候。这得看使用的情况和前后关系(context)。
而且呢,继承最主要的用途还是强调“是一种”的关系。主菜单,装备菜单,技能菜单,道具菜单,存档菜单等等,这些都是?菜单啊。
最后,Ruby语言让一个父类可以被很多个子类继承,但是一个子类只能继承一个父类。
有兴趣的话可以去科普一下“钻石问题”或者“菱形缺陷”,得知这个限制背后的原因。
C - 多态
多态(Polymorphism)是"多种形态"的缩写。它的定义为“一种将不同的特殊行为和单个泛化记号相关联的能力”。(来源:维基百科)
简单来说,相同的讯息(调用同样名字的方法)基于不同的物件(不同类的实例)会引发不同的动作(执行内容不一样)。
最简单的多态就是不同的类有同样名字的方法,但是内容不同。
[pre lang="ruby"]
class Cat#猫
def make_sound #发出声音
meow
end
def meow #喵喵叫
p "喵~"
end
end
class Dog#狗
def make_sound #发出声音
woof
end
def woof #汪汪叫
p "汪!"
end
end
#创建实例和方法调用
cat = Cat.new
cat.make_sound #输出:"喵~"
dog = Dog.new
dog.make_sound #输出:"汪!"
[/pre]
为什么要这么麻烦呢?我们知道那是猫,那它一定是喵喵叫的啊。调用meow方法不就行了吗?
但是,如果我们不知道那个实例实际上是什么类型,或者是不需要知道呢?这时多态就派上用场了。
假设我们有数个笼子,里面可能关着猫或者狗。我们只能靠叫声来分辨它们。(注意:类的定义和上面的例子一样。)
[pre lang="ruby"]
#随机往数组内放Cat或者Dog的实例,各50%几率,一共5个
arr = Array.new(5){rand > 0.5 ? Cat.new : Dog.new}
#用each迭代器遍历数组里的元素,并调用make_sound方法
arr.each do |i|
i.make_sound
end
#输出:(假设数组里的是[猫,狗,狗,猫,狗])
#"喵~"
#"汪!"
#"汪!"
#"喵~"
#"汪!"
[/pre]
多方便啊。我们不需要去判断到底那是Cat还是Dog的实例而去决定要调用什么方法,因为调用两者共有的方法就对了。
继承与多态有密切的联系。我们可以用Ruby语言实现方法覆盖(method overriding)。
这非常简单。只要在子类里面定义的方法与父类的重名,那么覆盖就会发生了。子类的方法将会优先被调用。
[pre lang="ruby"]
class AAA
def abc
p "父类的原方法"
end
end
class BBB < AAA
def abc
p "子类覆盖的方法"
end
end
#创建实例和方法调用
a = AAA.new
a.abc #输出:"父类的原方法"
b = BBB.new
b.abc #输出:"子类覆盖的方法"
[/pre]
不过很多情况下,子类方法与父类方法的区别只是增加了代码,不管是在前面,在后面,还是前后都有。
这种情况下,我们可以用super关键词来代表父类的原方法(同名方法)。
[pre lang="ruby"]
class AAA
def abc
p "父类的原方法"
end
end
class BBB < AAA
def abc
p "子类增添的代码(前)"
super
p "子类增添的代码(后)"
end
end
#创建实例和调用方法
b = BBB.new
b.abc
#输出:
"子类增添的代码(前)"
"父类的原方法"
"子类增添的代码(后)"
[/pre]
当然了,使用super算是方法调用,可以递参数给父类的原方法。(比如super(1,"a")),更可以用在表达式中(如 return 1 + super)。
super关键词毕竟意思是“调用父类的同名方法”。如果是要从别的方法或者外部调用父类的原方法呢?
Ruby提供了alias_method(方法别名)来给方法取一个别名。格式是:alias_method 方法的别名, 方法的原名 。(注意:符号和字符串都行)
[pre lang="ruby"]
class AAA
def abc
p "父类的原方法"
end
#设置别名为abc_super
alias_method :abc_super, :abc
end
class BBB < AAA
def abc
p "子类覆盖的方法"
end
end
#创建实例和调用
a = AAA.new
a.abc #输出:"父类的原方法"
a.abc_super #输出:"父类的原方法"
b = BBB.new
b.abc #输出:"子类覆盖的方法"
b.abc_super #输出:"父类的原方法"
[/pre]
要注意的是,alias_method必须在原方法定义完成后才能调用,否则会报错(找不到方法)。
最后我们来看继承和多态两个特征交杂的例子吧:
[pre lang="ruby"]
class Regular_Polygon #正多边形
#定义实例变量的读写方法
attr_accessor :side_length
def initialize(v) #初始化
@side_length = v
end
def sides #边的数量
raise "错误!未定义!" #手动报错
end
def area #面积
raise "错误!未定义!" #手动报错
end
def perimeter #周长
return side_length * sides
end
def internal_angle #内角
return 360 / sides #360度除于边的数量
end
def show_info #显示信息
p "边数:#{sides} 边长:#{side_length} 面积:#{area} 周长:#{perimeter} 内角:#{internal_angle}"
end
end
class Square < Regular_Polygon #正方形
def sides #正方形有四个边
return 4
end
def area #正方形的面积是边长的次方
return side_length ** 2
end
end
class Equilateral_Triangle < Regular_Polygon #等边三角形
def sides #三角形有三个边
return 3
end
def area #等边三角形的面积是 边长的次方 乘于 3的方根 再除于 4
return (Math.sqrt(3) / 4) * (side_length ** 2)
end
end
#创建实例调用方法
a = Equilateral_Triangle.new(5)
a.show_info #输出:"边数:3 边长:5 面积:10.825317547305483 周长:15 内角:120"
b = Square.new(7)
b.show_info #输出:"边数:4 边长:7 面积:49 周长:28 内角:90"
[/pre]
2.5 猴子补丁
展开折叠
一提到“猴子”,你们想到了什么呢?一种动物?论坛里的某个风云人物?
实际上,猴子补丁(Monkey Patching)是一种编程技法。定义是“在不修改源代码的情况下进行功能追加和变更。”
为什么这种技法叫“猴子补丁”呢?这有两种说法。第一种就是因为这种拼凑代码的行为就像猴子一般在乱搞(某种意义上真的像是这样)。
第二种说法是,以前这种技法叫“游击补丁”(guerilla patching),而英文单词guerilla(游击队)和gorilla(大猩猩)相似。
所以嘛,不知怎么地这技法就被叫成猴子补丁了咯… 老外的脑洞可不是一般的大啊。
我们常见到“插件脚本”(plugin script)这个名词。我自己也写过安装RMVA插件脚本的教程(看签名档!)。字面上的意思,“插”下去改改设置就得了。
那么为什么要以插件脚本的形式来修改RMVA的脚本呢?这是为了不影响默认的脚本,尽量避免因为出现错误而覆水难收。
尤其是忘记改了默认脚本的哪儿和原本这儿是长什么样子的情况,要排解问题实在是浪费时间和精力啊。
这,就是“猴子补丁”发挥力量的时候了。Ruby作为一个开放性的动态语言,支持拓展和重定义成为它的优势。
首先要说说类的拓展。我们知道,要定义一个类的时候,要用class关键词,而格式是class 类的名字; ...(类的内容)... end。
但是如果因为某些原因而导致要分开两段来写呢?这是可以的。
假设我们有一个类的定义为:
[pre lang="ruby"]
class AAA
def abc
p "方法abc"
end
def cde
p "方法cde"
end
end
[/pre]
在类的定义结束后,我们想要给这个类追加方法或者声明(如attr_accessor),但是我们又不想改动本来的类定义。要怎么办呢?
那么在Ruby语言,我们可以在它的下面追加多一次class...end,里面有追加的方法的定义和声明。
[pre lang="ruby"]
#原本的类定义
class AAA
def abc
p "方法abc"
end
def cde
p "方法cde"
end
end
#追加的类定义
class AAA
def efg
p "方法efg"
end
end
#创建实例与方法调用
a = AAA.new
a.abc #输出:"方法abc"
a.cde #输出:"方法cde"
a.efg #输出:"方法efg"
[/pre]
那么在RMVA脚本编辑器里面,我们需要知道游戏运行的时候,左边列表内所有脚本是从上到下运行的。运行完了一个就运行下一个,完成了就关闭程序。
所以我们可以把上面的例子如此放入脚本编辑器内而获得输出的结果:
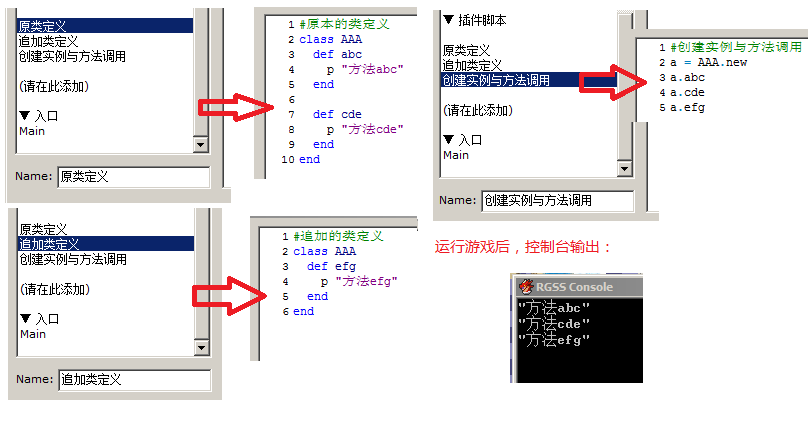
好,那么我们知道了如何透过猴子补丁的方式来给一个类追加方法。那么如果我们在追加类定义里面用了与原类定义相同的方法名字呢?
那就会造成方法覆盖了。新的方法取代(压制)旧的方法,达成了修改脚本的目标。
[pre lang="ruby"]
#原方法定义
class AAA
def abc
p "汪汪汪"
end
end
#追加方法定义
class AAA
def abc
p "喵喵喵"
end
end
#创建实例与方法调用
a = AAA.new
a.abc #输出:"喵喵喵" #而不是"汪汪汪"
[/pre]
我们知道,在用继承和多态的时候,如果子类覆盖父类的方法时,实际上只是在前面,后面或者前后都有增添代码,可以使用super关键词来调用父类的原方法。
就算是子类的其他方法或者透过引用从外部调用,也可以(在父类内)用alias_method来给原方法定一个别名。
那么同样地,在运用猴子补丁技法的时候,我们也可以给原方法取一个别名,让新方法可以调用。
Ruby为此准备了alias关键词。它和alias_method的功能相似,但是有一定的差距。
alias的使用格式是:alias 方法别名 原方法名 。两者之间不需要逗号(毕竟alias是关键词,所以系统有特殊的处理法)。
方法别名和原方法名可以直接就是方法名,符号,或者字符串。我的个人习惯是用符号,毕竟它在编辑器里面的颜色还是挺好看的(而且易读)。
[pre lang="ruby"]
#假设方法的别名是 old_area 而方法的原名是 area
#直接用方法名
alias old_area area
#用符号
alias :old_area :area
#用字符串
alias "old_area" "area"
[/pre]
在给旧方法创建了一个别名之后,就能让新方法像用了super关键词那样,调用旧的方法,并在调用的前面或者后面增加代码。
[pre lang="ruby"]
#原类定义
class AAA
def abc
p "旧方法的代码"
end
end
#追加类定义
class AAA
#设置别名
alias :old_abc :abc
def abc
p "新方法增添的代码(前)"
old_abc
p "新方法增添的代码(后)"
end
end
#创建实例与调用方法
a = AAA.new
a.old_abc #输出:"旧方法的代码"
a.abc
#输出:
"新方法增添的代码(前)"
"旧方法的代码"
"新方法增添的代码(后)"
[/pre]
alias和alias_method有着一定的差别。由于alias是一个关键词而alias_method是一个方法,前者使用时,参数中间不需要逗号,而后者需要。
另外,alias的作用领域在声明的地方,而alias_method的作用领域在呼叫它的地方。这个不太重要,因为我们大多都是直接在类定义里设置别名的。
不过我的建议是,将alias_method留给继承关系,而将alias用在猴子补丁这块儿。而且,我建议一律使用符号作为参数,容易看也容易写。
这样会比较容易明白,这到底是要继承父类的原方法,还是调用同个类内被覆盖的旧方法。
我们在Ruby编程里面可以用猴子补丁技法来拓展和更改接近任何事物。不喜欢系统方法?改啊。嫌名字难听或者太长?别名啊。方法不够?加啊。
假设我们要给数值(整数和浮点数)增添一个"钳"(clamp)方法,将数值限制到一个范围内。这在Ruby 2.4版成为了系统方法,但是RMVA的Ruby 1.9.2版没有。
注1:"钳"的运作原理是:如果该数值小于范围的最低值,就返回最低值。如果大于最高值,就返回最高值。否则,就返回那个数值。
注2:整数和浮点数的父类是Numeric(数值),所以要在这儿追加操作。
[pre lang="ruby"]
class Numeric #数字(整数,浮点数的父类)(为啥我会知道?F1帮助文档里有啊…)
#给数字增添"钳"功能
def clamp(min,max)
return min if self < min #数值小于范围的最低值,就返回最低值
return max if self > max #数值大于最高值,就返回最高值
return self #否则就返回数值
end
end
#实际测试
p 5.clamp(4,6) #输出:5 (在范围内所以小于自身)
p (7.888).clamp(12.3,60.5) #输出:12.3(钳到了最小值)
p 257.clamp(0,255) #输出:255 (钳到了最大值)
[/pre]
基本上没人能阻止你用猴子补丁技法来篡改系统方法,不管是追加还是更改功能。不过难度是有的,毕竟你不知道原本的代码是长啥样子。
就连RGSS3提供的内置类(如Bitmap, Sprite)也都能如此篡改。看不到原本的代码不代表你不能靠想象力啊(笑)。
最后要介绍的是运算符重载(Operator Overloading)。什么运算符?+ - * / [] 这些啊。重载?什么意思?就是更改它们的功能啊。
我去,这么冰淇淋?对的,就是这么冰淇淋。在Ruby语言内,运算符的操作是方法的一种。大部分运算符的功能都可以重新定义。
这就是为啥在Ruby语言,不止数字可以用加(+)和减(-)操作符,连字符串和数组都可以用加减操作符(而它们的功能在上一个章节介绍过了)。
作为实践例子,我们来创建一个Vector2D(二维向量)的类。二维向量有X值和Y值。我们也重载了to_s方法,让puts显示数据时显示它的值。
[pre lang="ruby"]
class Vector2D #二维向量
attr_accessor :x #X值
attr_accessor :y #Y值
def initialize(x = 0,y = 0) #初始化
@x = x
@y = y
end
def to_s
return "(#{x}, #{y})"
end
end
#创建实例和调用
a = Vector2D.new(1,2)
b = Vector2D.new(3,4)
puts a #输出:(1, 2)
puts b #输出:(3, 4)
#加法运算(a + b)
c = Vector2D.new
c.x = a.x + b.x
c.y = a.y + b.x
p c #输出:(4, 6)
[/pre]
我去,这加法运算…好麻烦啊啊啊!不能用c = a + b 这样的,比较简单的方法吗?
当然行啊,运算符重载就是用来干这档事的。我们就来重载加法(+)运算符吧!
注意:以下的范例是追加类定义。如果要实际测试的话请自行合并代码。
[pre lang="ruby"]
#给Vector2D类追加+运算符的重载定义
class Vector2D
def +(v)
return Vector2D.new(@x + v.x, @y + v.y)
end
end
#测试
a = Vector2D.new(1,2)
b = Vector2D.new(3,4)
c = a + b
puts c #输出:(4, 6)
[/pre]
嘿,这不就搞定了吗?运算符重载真强啊!只要把剩余的需要的运算符都重载了,这个类就完美了(请自己尝试)!
以下是可以重载的Ruby运算符:
[pre lang="ruby"]
[] []= 元素引用,元素赋值
! ~ (逻辑非,位非)
+@ -@ (一元加,一元减)
+ - * / (加,减,乘,除)
** % (乘方,取余)
<< >> (左位移,右位移)
& | ^ (位和,位或,位异或)
<= < > >= (小于或等于,小于,大于,大于或等于)
== === != (等于,特殊等于,不等于)
=~ !~ (匹配,不匹配)*注:一般用于正则表达式
<=> (联合比较运算)
[/pre]
2.6 类方法与模块
展开折叠
在Ruby,一切皆为对象。不管是字符串,整数,数组,范围,还是基于自定义的类所创建出来的实例(那当然了)。
但是,就连类本身也是对象!什么意思呢?这么说吧。类就像一张蓝图,上面记载着创建出来的实例会是什么样子的。
但是这张蓝图的图纸,本身也是个对象。是生产图纸的蓝图的实例。要生产用来画蓝图的图纸,也得有一张蓝图来记载图纸的规格啊材料什么的。
要如何引用这个类对象呢?非常简单。它的名字就是存着这个对象的常量。(比如String存着字符串的类对象,Float存着浮点数的类对象等等)
解释器(系统)在处理类定义的时候,它会给这个类定义创建一个对象,然后将这个对象的引用存到同名的一个常量里面。
这个对象的类是Class,也就是类对象本身的蓝图。
为什么我们要知道这些呢?那是因为,我们接下来会介绍的,就是类方法(class method)和与它有关的事物。
类方法,就是类本身的实例方法。new就是其中一个类方法。比如说我们要创建一个空的数组。我们可以用Array.new来达成目标。
那么Array是数组的类,而new是它的类方法。那么让我们来看看如何定义类方法吧!
在类定义里面定义类方法的方式,是在方法的名字前面前缀"self.",代表给自身(类)定义方法。类方法可以是运作符重载。
我们就以上一个部分(运作符重载)使用的Vector2D(二维向量)类来当范例。注意:以下的范例是追加定义,因此请自行合并代码。
[pre lang="ruby"]
#追加定义
class Vector2D
def self.zero #创建零向量
return self.new(0,0)
end
def self.[](x,y) #过载[]运算符来当做new用
return self.new(x,y)
end
end
#实际调用
a = Vector2D.zero
puts a #输出:(0, 0)
b = Vector2D[4,5]
puts b #输出:(4, 5)
[/pre]
嘿,这不是挺好的嘛!有各种方法来创建新的对象啊!要弄什么向量啦矩阵啦也方便很多。
但是这又出现了两个问题。第一,每次都要前缀"self."很麻烦。第二,要取别名时怎么办?
我们可以加用 class << self ... end 来开启单例类的定义空间。单例类(singleton class)就是单一对象的类定义,只对该对象有效。
比如我们可以把上面的范例如此重写,而我们又可以用alias来给类方法取别名:
[pre lang="ruby"]
#追加定义
class Vector2D
class << self #开启单例类的定义空间
def zero #创建零向量
return self.new(0,0)
end
def [](x,y) #过载[]运算符来当做new用
return self.new(x,y)
end
alias :zero_alias :zero #给self.zero定一个别名:zero_alias
end
end
#实际调用
a = Vector2D.zero
puts a #输出:(0, 0)
b = Vector2D[8,4]
puts b #输出:(8, 4)
c = Vector2D.zero_alias #尝试使用zero的别名
puts c #输出:(0, 0) #成功了!
[/pre]
我个人的习惯是如果需要用到alias(或者alias_method)才用class << self。这会因人而异。
那么之前我们有介绍过变量的类型。有实例变量,类变量…那么既然类是个对象,它能不能用实例变量呢?能。
基于它所创造的实例能不能用这个实例变量呢?不能。那么…前缀@@的类变量和无法改动的常量呢?
类和基于它所创造的实例都能用。好,那么就来看看范例:
[pre lang="ruby"]
class AAA
#类方法
class << self
def set_var #设置类的实例变量和类变量
@self_var = 666
@@class_var = 233
end
def show_var#显示类的实例变量和类变量
p "类"
p @self_var
p @@class_var
end
end
#实例方法
def show_var #显示该实例的实例变量和类变量
p "实例"
p @self_var
p @@class_var
end
end
#实际调用
AAA.set_var
AAA.show_var
AAA.new.show_var
#输出:
#"类"
#666
#233
#"实例"
#nil
#233
[/pre]
由此可见,类里的@实例变量只能由类方法使用,而@@类变量则是类和它的实例所共用的。
那么我们在说到实例变量和类变量时有说过,实例变量是在initialize方法里面初始化的。类变量则可以在类定义的空间内直接赋值初始化。
那么我们来做个试验吧!如果把@前缀的实例变量放在方法外面会发生什么事!
[pre lang="ruby"]
class AAA
#类方法
class << self
#在单例类定义空间内赋值:实例变量,类变量,常量
@self_instance_var = 233
@@self_class_var = 555
SELF_CONSTANT = 666
def show_var #显示变量和常量
p "类"
p @self_instance_var
p @@self_class_var
p SELF_CONSTANT #注:会报错
p @instance_var
p @@class_var
p CONSTANT
end
end
#在类定义空间内赋值:实例变量,类变量,常量
@instance_var = 777
@@class_var = 888
CONSTANT = 999
#实例方法
def show_var #显示变量和常量
p "实例"
p @self_instance_var
p @@self_class_var
p SELF_CONSTANT #注:会报错
p @instance_var
p @@class_var
p CONSTANT
end
end
#实际调用
AAA.show_var
AAA.new.show_var
#输出:
#"类"
#nil #@self_instance_var
#555 #@@self_class_var
#报错:找不到常量SELF_CONSTANT (需要修复才能继续)
#777 #@instance_var
#888 #@@class_var
#999 #CONSTANT
#"实例"
#nil #@self_instance_var
#555 #@@self_class_var
#报错:找不到常量SELF_CONSTANT (需要修复才能继续)
#nil #@instance_var
#888 #@@class_var
#999 #CONSTANT
[/pre]
那么从上面的实验我们可以观察到:
[pre lang="ruby"]
在类定义空间(class << self)里面,
-> @实例变量无法被读取(nil)
-> @@类变量可以被类方法和实例方法读取
-> 常量无法被读取,而且会报错
在类定义空间里面,
-> @实例变量可以被类方法读取,但是无法被实例方法读取
-> @@类变量可以被类方法和实例方法读取
-> 常量可以被类方法和实例方法读取
[/pre]
那么在类里定义的常量除了可以在类的内部使用(不管是类方法或是实例方法),还可以从外部直接引用。
不过,引用常量的方法与调用方法不同。不是属性解析符(. 句号)而是常量解析符(:: 双冒号)。
[pre lang="ruby"]
class AAA
#定义常量
CONSTANT = 666
end
#使用常量解析符(::)引用AAA类内的CONSTANT常量
p AAA::CONSTANT #输出:666
[/pre]
好,那么我们已经知道了怎么定义类方法和在类里定义常量,也知道类其实是Class(可以说是类的蓝图)的实例。
在RMVA默认脚本里,我们可以看到一些脚本里定义的并不是类(class)而是另一种玩意儿:模块(module)。
什么是模块?用最简单的方法来描述的话,就是不能创建实例的一种类。不过,实际情况却是相反的。
类是可以创建实例的一种模块。这是因为类是模块的子类。(Class < Module ,注意:Module是模块的蓝图类)
既然是这样,为什么要用模块呢?第一种原因非常直白,就是用于表示“不应该存在实例”。
RMVA默认脚本中的DataManager, SceneManager, BattleManager等模块,都是只用类方法,类本身的实例变量和常量的。
它们并不需要实例方法和实例变量,所以定义为module(模块)而不是class(类)。这可以避免使用者误操作而弄出了个实例。
创建模块的方法,就是将定义时的class替换成module罢了。要注意的是,模块没有继承能力。
[pre lang="ruby"]
#模块定义
module AAA
#定义常量
CONSTANT = 666
#定义类方法
def self.abc
p "RMVA"
end
#开启单例类定义空间来定义类方法
class << self
def cde
p "66RPG"
end
end
end
#实际调用
AAA.new #报错!找不到new方法!(嗯,模组没有new也无法创建实例)
AAA.abc #输出:"RMVA"
AAA.cde #输出:"66RPG"
p AAA::CONSTANT #输出:666
[/pre]
模块的使用还有第二个鲜为人知的原因:用于实现多重继承。也就是将模块内定义的实例方法混入别的类/模块里面。
所有的类和模组默认都有两个方法:include(包括)和extend(拓展)。用法和attr_accessor相似,就是在类/模组定义里调用。
使用格式是:include 模组名 或者 extend 模组名。它们可以在不影响类继承的情况下,给一个类/模块添加实例方法(include)或者类方法(extend)。
首先来看看include的用法:
[pre lang="ruby"]
#定义模块
module AAA
#定义常量
CONST = 666
#定义类方法
def self.abc
p 555
end
#定义实例方法(对模块本身来说无用)
def cde
p 233
end
end
#定义类
class CCC
#使用include来混入模组内的常量和实例方法
include AAA
end
#实际调用
c = CCC.new
c.abc #报错!找不到方法!#混入只对模块内的实例方法有效
c.cde #输出:233 #代表模块AAA里定义的实例方法abc成功混入了CCC类
CCC.abc #报错!找不到方法!#混入只对模块内的实例方法有效
CCC.cde #报错!找不到方法!#使用include混入方法是作为类的实例方法而不是类方法
p CCC::CONST #输出:666 #代表模块AAA里定义的常量成功混入了CCC类
[/pre]
我们也可以在模块里include。然后,可以通过这个模快将常量和实例方法转交给类。
模块内通过include而获得的常量可以被通常方式引用,但是实例方法却不能,只能用来让别的类include获取。
[pre lang="ruby"]
#定义模块
module AAA
CONST = 666
def abc
p 233
end
end
#定义模块 - 用include混入模块AAA
module BBB
include AAA
end
#定义类 - 用include混入模块BBB
class CCC
include BBB
end
#实际调用
c = CCC.new
c.abc #输出:233 #代表模块AAA里定义的实例方法成功通过模块BBB来混入CCC类
p BBB::CONST #输出:666 #模块AAA里的常量混入了模块BBB
p CCC::CONST #输出:666 #模块AAA里的常量通过模块BBB混入了CCC类
BBB.abc #报错!找不到方法!include混入的方法是作为实例方法,所以模块无法调用
[/pre]
见识了include的功能,现在我们来看extend。extend将模块内定义实例方法作为类方法来混入别的类或者模块。
[pre lang="ruby"]
#模块定义
module AAA
CONST = 666
def abc
p 233
end
end
#类定义 - 用extend来将模块AAA里的实例方法混入,作为自己的类方法
class CCC
extend AAA
end
#实际调用
CCC.abc #输出:233
p CCC::CONST #报错!找不到常量!#这是因为extend并不会混入常量
c = CCC.new
c.abc #报错!找不到方法!#通过extend混入的是作为类方法,因此实例无法调用
[/pre]
extend不止可以添加类(class)的类方法,也能添加模(module)的类方法。毕竟类就是可以创建实例的模组嘛。
include和extend如果同时用会怎么样?那就类方法也有,实例方法也有,常量也有咯。这是要看情况和需求的。
模块的这个混入能力让我们可以更有效地整理方法。比如C类通过include混入A模块和B模块来添加常量和实例方法,然后extend了E模块来添加类方法。
另一个D类则include了B模块和F模块,然后extend了G模块… 这样可以在不影响既有的继承关系之下,另外再增添方法和常量。
这是Ruby的一大精髓啊,可不能被埋没了。不过…变量呢?实例变量不就是有用到时才赋值创建的嘛,对吧。
如果想要让模块里定义的实例方法可以从外部被调用,怎么办?那就在模块的定义里调用module_function来指定可以被外部调用的实例方法。
用法基本上和attr_accessor差不多。让我们直接看范例:
[pre lang="ruby"]
#定义模块
module AAA
#定义实例方法
def abc
p 666
end
def cde
p 233
end
module_function :abc #指定可以被外部调用的实例方法
end
AAA.abc #输出:666
AAA.cde #报错!找不到方法!
[/pre]
调用module_function后,指定的实例方法会成为该模块的类方法。
这些实例方法仍然可以通过include或者extend被混入类/模组里,但是会成为私有的实例/类方法。
那么这个部分的最后,我们要说到的是模块和类的嵌套(nested class/module)。
我们在RMVA默认脚本里可能有看过这样的代码:RPG::Item,RPG::Weapon,RPG::Animation::Frame …这些在F1帮助文档里面的数据结构部分也见过。
这些其实是类的名字。数据库元素的类。RPG::Item是道具数据库内的元素的类。RPG::Weapon则是武器数据的类。
那么我们现在要讨论的,就是这个"RPG::"是什么玩意儿。我们再复习一下类的创建原理。
解释器(系统)在处理类/模块定义的时候,它会给这个类/模块定义创建一个对象,然后将这个对象的引用存到同名的一个常量里面。
如果我们在公共区域(没有被任何class或者module包着)定义一个类或者模块,那么这个常量,就是全局的了。
那我们在类的定义或者模块的定义里面又定义了一个类或者模块的话呢?嵌套就产生了。内层类的引用会作为外层类的常量来储存。
[pre lang="ruby"]
module AAA
module BBB
CONST = 666
def self.xxx
p "xyz"
end
end
class CCC
class DDD
def efg
p 10086
end
end
def cde
p 555
end
end
self.abc
p 233
end
end
#实际调用:
p AAA.abc #输出:233
p AAA::BBB::CONST #输出:666
AAA::BBB.xxx #输出:"xyz"
c = AAA::CCC.new
c.cde #输出:555
d = AAA::CCC::DDD.new
d.efg #输出: 10086
[/pre]
不管是类(class)还是模块(module)都能互相嵌套。这能让类/模块作为命名空间(namespace)来让代码的管理更方便。
命名空间是啥?就是如果你有完全不相干的,名字相同的两个类,你可以将它嵌套进不同的类/模块来作鉴别。嵌套进去的就是命名空间。
比如名字同是Weapon的另个类,我们可以把它嵌套进名为SRPG的类/模块里面(就成了SRPG::Weapon),让它有个特殊的名字。
这样的话,SRPG::Weapon就不会跟没有嵌套的Weapon搞混了。尤其是Ruby有猴子补丁的情况下,这是很严重的事情。
一般上,如果只是用来作为命名空间而没有其他用意的话,我的建议是一律用模组(module)作为“容器”。
我们其实还有另一种方法可以实现嵌套(巢状结构)。请看范例:
[pre lang="ruby"]
module AAA; end #空的模块,作为容器
class AAA::BBB
#内容1
end
class AAA::BBB::CCC
#内容2
end
[/pre]
以上的代码和下列的代码是一样的:
[pre lang="ruby"]
module AAA
class BBB
#内容1
class CCC
#内容2
end
end
end
[/pre]
当然用哪个比较好,这是说不清的,因为这得看个人风格。不过我建议是初次定义时用后者(嵌套),而追加定义用前者(用::来平铺)。
2.7 垃圾回收机制
展开折叠
Ruby毕竟是面向对象的语言,一切事物都是对象。也就是说,我们时时刻刻都在创建对象。一个字符串是一个对象,一个数组又是一个对象。
那么问题就来了。对象毕竟是一组数据,是要耗费内存的(不知道什么是内存的…快去百度搜索!)。电脑的记忆体空间是有限的。
RMVA的内存消耗限制大概是900MB~1.1GB之间吧。也许因人而异。在我自家的2GB旧电脑上,内存消耗到了这个范围程序就崩溃了。
既然我们一直在创建对象,那么就是会一直在消耗内存啊。对象多,内存消耗就越多,那久而久之不就崩溃了吗?
为了避免这种问题的发生,Ruby配备了一个叫做“垃圾收集器”(Garbage Collection,简称GC)的机制。
在说到对象和引用的时候,我们知道了引用的重要性。如果程序内的所有活跃的变量都没有存着某个对象的引用,那么它就是被“孤立”了。
这个被“孤立”的对象,可以说是已经“死了”。既然死了,这个尸体总不能挡着路啊。这就是GC的工作范围。
GC什么时候会执行任务?不知道,也无法预测。我们也不怎么需要注意,除非你在做内存消耗非常巨大的事情。
我们作为RMVA的使用者所需要知道的,就是如何让GC可以辨识到这是垃圾,而清除它。
要消除一个对象的引用,最直接的方法就是把存着它的引用的变量赋值成别的东西,比如nil(空值)。
[pre lang="ruby"]
a = Array.new
a = nil
[/pre]
除了全局变量(前缀$),类变量(前缀@@)和类实例变量(类方法用的@变量)之外的变量都是暂时性的。也就是说,它的寿命总有到尽头的时候。
我们知道,局部变量(无前缀)的作用域是代码块内罢了。也就是说,代码块结束的时候,局部变量会被删除而导致原本存着的对象失去引用。
[pre lang="ruby"]
def abc
a = Array.new
#方法结束后,局部变量a就被删除了,里面的数组也就被孤立了
end
abc #方法调用
[/pre]
实例变量(前缀@)的作用范围是实例的内部。如果该对象因受孤立而被GC清除,那么它里面所有实例变量都会被删除。
[pre lang="ruby"]
class AAA
def initialize
@aaa = Array.new
#在实例被GC清除后,实例变量会被删除,导致@aaa里原本装着的数组被孤立,迟早被GC处理掉
end
end
a = AAA.new
a = nil #原本装着的AAA类的实例被孤立,迟早会被GC处理掉
[/pre]
因此,如果要长期保存一个对象,我们必须确保它的引用被保存在永久保持活跃状态的变量里面。
这是RMVA默认脚本里,Cache(缓存)模块的功能。游戏所导入图像素材的引用会被存在一个哈希表里面。
这个哈希表的引用被存在Cache模块的一个类实例变量里面(@cache)。
我们知道,Ruby的垃圾回收机制是自动运行的。什么时候会清除一个受孤立的对象,我们无法知道。
但是,我们可以手动呼叫GC来立即处理掉所有受孤立的对象,尤其是在进行了大幅度消耗内存的操作之后。
只要呼叫GC.start就行了。GC是Ruby垃圾回收模块的名字,而start是开始的意思。
[pre lang="ruby"]
a = Array.new
a = nil #导致上一行的数组被孤立
GC.start #手动呼叫垃圾回收机制
[/pre]
不过,手动呼叫GC来清除对象的时候可能会耗费一些时间。一次过处理的对象多了也许会有点慢,所以要多加注意。
注意:2.8和2.9是较高级的内容,但是只要能成功理解,会对脚本的编写有很大的帮助。
2.8 对象之根与高阶操作
展开折叠
看到这里,想必你已经知道如何解读大部分RMVA的默认脚本,也可以参考注释模仿默认脚本做些许的修改了吧。
不过,学习是漫无止境的。在这一个部分,我们会探讨Ruby对象的“根源”,也会认识到一些高级方法和概念。
首先,你可曾想过,为什么一个空的类还是有可以调用的实例方法?
[pre lang="ruby"]
class AAA; end #定义空的类
p a.to_s #输出:"#AAA<0x12345678>" #注:后面的十六进制数是随机生成的
[/pre]
啥?空的类居然知道to_s(转换成字符串)方法?哪儿来的?难道它有超类(或者称为父类)?
没错。Ruby的所有对象都有内置的超类。我们可以找出它的超类,和它的超类的超类的超类…一直到它最初的根源。
这个方法叫做superclass(显示超类),是一个类方法。好,那我们来看看,空的类的超类是啥。
[pre lang="ruby"]
class AAA; end
p AAA.superclass #输出:Object
[/pre]
哇哦!找到了!AAA的超类是Object。Object可是对象的英文名啊。为了不搞混,还是把它称为“物件”好了。那么Object的超类又是啥?
[pre lang="ruby"]
p Object.superclass #输出:BasicObject
p BasicObject.superclass #输出:nil #就是没了
[/pre]
好,很明显,Object(物件)的超类是BasicObject(基本物件)。
因此我们可以推断出,任何在脚本里自定义的类,都有内置的继承链:类 < 超类 < Object < BasicObject。
to_s这个方法,想必是从它的内置超类里面传承下来的。
但是现在有一个问题。我们在介绍类方法和模块的时候提到过,类是一个对象,是Class类的实例。(模块是Module类的实例)
现在我们来验证一下这个说法,要使用的是class(显示自己是哪个类的实例)方法:
[pre lang="ruby"]
module AAA; end #定义空模块
class BBB; end #定义空类
p AAA.class #输出:Module
p BBB.class #输出:Class
[/pre]
验证成功!模块是Module的实例,而类是Class的实例。
现在我们来看看Class的继承树是怎样的,寻找它的根源。(用superclass方法)
[pre lang="ruby"]
p Class.superclass #输出:Module
p Module.superclass #输出:Object
p Object.superclass #输出:BasicObject
p BasicObject.superclass #输出:nil #就是没了
[/pre]
Class > Module > Object > BasicObject
哎哟,怎么又回到Object来了?是的。Ruby里面一切都是对象。一切的父类都是Object,这是很正常的事情。
把以上所得到的编成一张表的话,是长这个样子的:
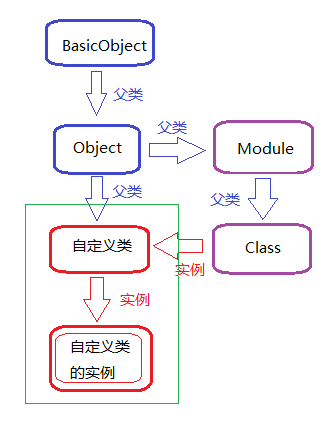
这样我们就看清楚了各种类与实例之间的关系,也得出一个结论:Object(和它的父类BasicObject)是Ruby一切对象之根。
那么除了用superclass方法(注:superclass是Class类的实例方法)来获取一个类的超类之外,我们还可以用ancestors(祖先们)来获取继承树。
继承树里面除了显示自身和所有超类之外,还会显示出自身或者任何超类所混入的模块。
我们就以Array来做例子吧。
[pre lang="ruby"]
p Array.ancestors #输出:[Array, Enumerable, Object, Kernel, BasicObject]
[/pre]
从得出的列表我们可以知道:
Array(数组)混入了Enumerable(枚举)这个模块
Object(物件)混入了Kernel(核心)这个模块
Array的继承树是:Array < Object < BasicObject
那么问题来了。为什么我们要知道这些?只是因为这是较“高级”的事情,去探讨只是因为兴趣吗?
实际上,我们需要知道每个内置类的类方法和实例方法,以运用它们来简化原本非常复杂的事情。
举个例子好了。请问,如何知道一个对象是什么类的实例?告诉你吧,有两种判定法。
第一种是用is_a?方法。这是Object的实例方法,因此内建在所有对象里面了。第二种是用class(也是Object的实例方法)获取类,然后比较一下。
[pre lang="ruby"]
a = "123"
p (a.class == String) #输出:true
p (a.class == Array) #输出:false
p a.is_a?(Object) #输出:true
p a.is_a?(Hash) #输出:false
[/pre]
用class获取类来比较和用is_a?方法来判断的分别就是is_a?会考虑超类和混入的模块。
我们可以推断,a.is_a?(String) 的功能与 a.class.ancestors.include?(String) 相似。
那为什么我会知道要用class来获取类呢?那是因为我知道了一切对象内置的超类必定有Object。
然后,我在Ruby官方帮助文档(RubyDoc)里关于Object的资料页面里找到了class的功能。
这样看来,这个部分绝对是非常重要的呢。
但是,Ruby类的方法那么多,怎么知道一个类有什么方法呢?Object类里面提供了数种实例方法来获取方法列表。
要获取公共方法列表的话,要用 public_methods,要获取受保护方法列表的话,要用 protected_methods 。
公共方法和受保护方法都要的话,用 methods 就行了,但是如果要获取私有方法的列表,需要用private_methods 。
如果你嫌获取私有方法要另外调用很麻烦,你大可用猴子补丁技法给Object追加一返回methods + private_methods的方法。
获取的方法列表里面装着的是方法名字的符号。
现在我们来看看Object有多少种实例方法。
[pre lang="ruby"]
#注意:以下的数据是基于RMVA自带的Ruby 1.9.2的。其他版本Ruby可能会不同。
p Object.new.public_methods.count #输出:56
p Object.new.protected_methods.count #输出:0
p Object.new.private_methods.count #输出:71
[/pre]
我去!56个公共方法?71个私有方法?要完啊!这是因为Object混入了Kernel(核心)模块的实例方法,也继承了BasicObject的实例方法。
以上三种显示方法列表的方法都是给实例调用的。如果类与模块本身调用的话,会显示它们的类方法。
因此,我们需要用public_instance_methods,protected_instance_methods和private_methods获取类或模块的实例方法。
如果要同时获取公共和受保护的实例方法列表,就要用instance_methods。不过一般上内置的受保护方法非常少,所以直接用它就好。
[pre lang="ruby"]
p Object.instance_methods.count #输出:56
p Object.private_instance_methods.count #输出:71
[/pre]
那么我们来看看Object的类方法和实例方法到底有哪些,有多少。
[pre lang="ruby"]
p "Object的类方法(公共)"
p Object.methods.sort #sort是排序
p "Object的类方法(私有)"
p Object.private_methods.sort
p "Object的实例方法(公共)"
p Object.instance_methods.sort
p "Object的实例方法(私有)"
p Object.private_instance_methods.sort
[/pre]
输出:
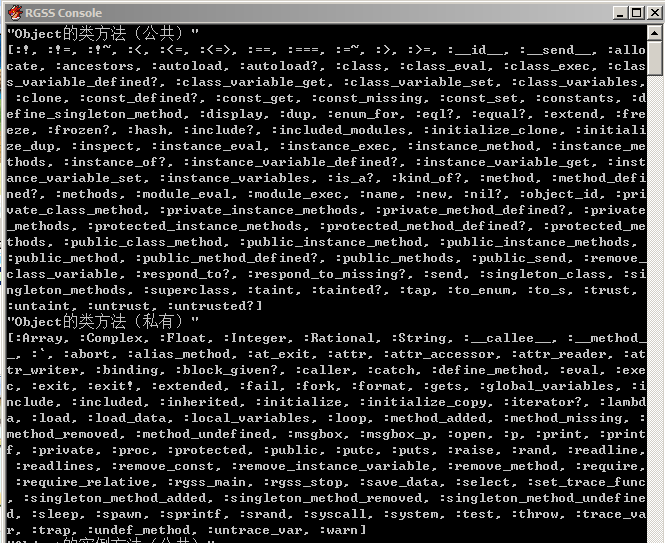
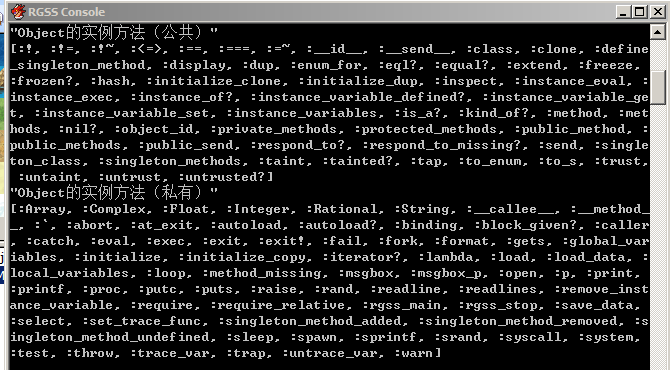
哇哦!好多!所以啊,这可是个宝库。我们可以获取任何实例对象的方法列表,和任何类/模块的类方法和实例方法列表。
除了获取方法列表之外,我们还可以获取…常量,实例变量,类变量甚至全局变量的列表。
获取常量:constants,获取实例变量:instance_variables,获取类变量:class_variables,获取全局变量:global_variables 。
constants和class_variables是类方法,instance_variables和global_variables是实例方法。
global_variables是私有方法,所以调用时不能用解析符。不过不管在哪儿调用都一样的啦。
[pre lang="ruby"]
class AAA
CONST = 100
@@class_var = 555
def initialize
@abc = 5
@cde = 8
end
end
#实际调用
p AAA.constants #输出:[:CONST]
p AAA.class_variables #输出:[:@@class_var]
a = AAA.new
p a.instance_variables #输出:[:@abc, :@cde]
[/pre]
除此之外,Object还提供了instance_variable_get(获取实例变量)和instance_variable_set(设置实例变量)两个非常强大的方法。
有些时候,我们需要遍历一个对象的所有实例方法来施展一些操作。RMVA默认脚本里,Scene_Base类就有如此的方法。
这两个方法是:update_all_windows(更新所有窗口)和dispose_all_windows(释放所有窗口)。没错,这时透过遍历实例变量而达成的。
让我们来看看范例吧!
[pre lang="ruby"]
#类定义
class AAA
def initialize
@abc = 555
@cde = 666
end
def show
p "#{@abc} #{@cde}"
end
end
#实际调用
a = AAA.new
p a.instance_variable_get(:@abc) #输出:555 #注意:必须有@前缀
p a.instance_variable_get("@cde") #输出:666 #注意:参数可以是符号或字符串
a.instance_variable_set(:@abc, 233) #第一个参数是名字,第二个是赋值内容
a.show #输出:"233 666" #成功篡改实例变量@abc了!
[/pre]
一般来说,如果要删除一个实例变量,我们直接给它赋值nil(空值)就好了。不过…如果强迫症发作硬是要删除呢?从列表内删除掉?
每个对象都有一个私有的实例方法:remove_instance_variable(移除实例变量)。
既然是私有的,就是说它无法从外部调用。我们要给它建一个“包裹”。
[pre lang="ruby"]
class AAA
def initialize
@abc = 555
@cde = 666
end
def remove_ivar(v)
remove_instance_variable(v)
end
end
#实际调用
a = AAA.new
p a.instance_variables #输出:[:@abc, :@cde]
a.remove_ivar(:@abc)
p a.instance_variables #输出:[:@cde]
[/pre]
不过呢,毕竟面向对象的基本特征之一是“封装”,instance_variable_get之类的方法滥用的话,可能就会造成结构紊乱,所以得善用啊。
在Ruby内,一切都是对象。这包括最顶层(全局)的作用域,也就是main。它是一个Object类的实例。因此,所有Object类的实例方法都是全局方法。(比如p和rand)
[pre lang="ruby"]
p self #输出:main
p self.class #输出:Object
[/pre]
在全局作用域里定义的每一个方法,都会成为Object类的私有实例方法。定义的每一个类/模块,都会成为Object类的常量之一。
[pre lang="ruby"]
v = Object.private_instance_methods #暂存当前Object的私有实例方法
def aaa; end #定义空的全局方法
p Object.private_instance_methods - v #显示Object新增的私有实例方法
#输出:[:aaa]
v = Object.constants #暂存当前Object的常量
class AAA; end #定义空的类
module BBB; end #定义空的模块
p Object.constants - v #显示Object新增的常量
#输出:[:AAA, :BBB]
[/pre]
因此,我们可以调用Object.constants来查看全局常量,然后筛选出类/模块(有至少一个小写字母,除非你命名自定义类为全大字母)。
[pre lang="ruby"]
p Object.constants.select{|s| s.to_s =~ /[a-z]/} #显示所有全局常量,筛选出所有至少包含一个小字母的常量
[/pre]
输出:
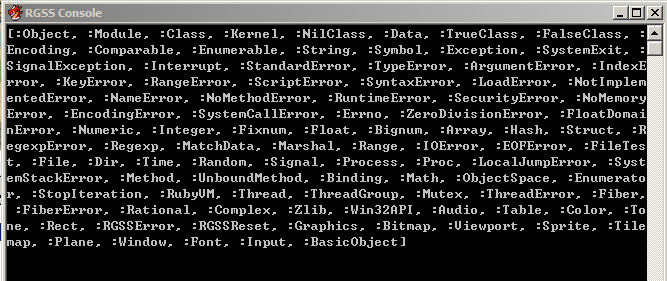
这就是RMVA系统所自带的类的列表了。有系统的String(字符串)啊Array(数组)啊什么的,还有RGSS3的Sprite(图像精灵)之类的。
Ruby的各种类还有很多很多我们可以运用的高效率方法。本教程没特别介绍的,就得靠自己去科普了。
2.9 方法对象与代码块
展开折叠
在上一个部分,我们学到了透过名字来获取或设置实例变量的方法(instance_variable_get和instance_variable_set)。
实际上啊,连方法调用都可以这么做。Object类提供了两个方法:send(发送)和public_send(公共发送)。
用法是:send(方法名字, 参数) 。有多少个参数就填多少个,否则不需要。public_send只能用于调用公共方法,因此较为安全。
[pre lang="ruby"]
#定义类和方法
class AAA
def add(a,b)
a + b
end
def abc
p 666
end
end
#实际调用
a = AAA.new
a.send(:abc) #输出:666 #相等于a.abc
b = a.send(:add, 7, 9) #相等于a.add(7,9)
p b #输出:16
[/pre]
send的功能非常强大。它可以强制调用一个对象的私有方法,更是可以基于储存起来的方法名字进行调用。
让我们来看看下面的,基于四则运算的这个例子:
[pre lang="ruby"]
a, b = 6, 2 #注意:这是a = 6; b = 2 的缩写
[:+,:-,:*,:/].each { |s| p a.send(s, b) end
#输出:
#8 # a + b #等同 a.send(:+, b)
#4 # a - b #等同 a.send(:-, b)
#12 # a * b #等同 a.send(:*, b)
#3 # a / b #等同 a.send(:/, b)
[/pre]
这是非常方便的。如果需要以同样的参数呼叫多个方法,可以考虑用这个方式来精简化。
当然,send和public_send最重要的使用情况还是调用的方法不固定的时候。
Ruby的一切都是对象。这句已经重复了说了不知道多少遍,不过还是得说。就连方法也是对象。
什么?方法也是对象?那是不是可以把一个对象方法的引用交给别的对象来调用啊?答对了!
这是RMVA默认脚本里,窗口(尤其是指令窗)和场景互动的主要方法。因此,我们必须得熟悉这个技巧。
获取实例变量的方法是instance_variable_get,那么获取方法引用的方法是method和public_method。
两者的区别就是,public_method只能获取公共方法,而method可以获取公共,私有和受保护方法的引用。
获取方法之后,我们可以用该方法对象的call方法(要附上参数)来实际调用那个方法。
让我们来看范例:
[pre lang="ruby"]
class AAA
def initialize(v)
@aaa = v
end
def abc
p @aaa
end
end
#实际调用
a = AAA.new(5)
b = AAA.new(7)
c = a.method(:abc)
d = b.method(:abc)
c.call #输出:5
d.call #输出:7
[/pre]
我们发现的是,c和d同样是AAA类的abc方法,但是它们属于不同的,AAA类的实例(分别属于a和b)。
因此,它们的作用域不一样,是基于所属的实例的。(这关系到实例变量和用self获取的自身引用)
我们可以透过调用方法的方式来创建,注销或者移除方法。先来说后者吧。
Module(模组的蓝图)提供了undef_method和remove_method两个方法。用法和attr_accessor相似。
def是定义,那么undef是?注销定义。remove则是移除的意思。两者的差距在于会不会追溯超类和混入模块。(后者会)
一般上我们都是用undef_method来注销方法的。比如让一个类无法透过new来创造实例。
[pre lang="ruby"]
class AAA
class << self
undef_method :new
end
end
a = AAA.new #报错!找不到方法new!
[/pre]
这样的话,new这个方法就报废了。它也不会去看父类(Object等等)和混入模块有没有这个方法了。(remove_method移除的则会)
那么你会问的是,这有什么用?如果我要用其他的类方法来创建新的实例,没有new不就悲剧了吗?
其实new的定义是这样的:
[pre lang="ruby"]
class AAA
class << self
def new(*args)
a = allocate
a.send(:initialize, *args)
return a
end
end
end
[/pre]
allocate是Class的实例方法。调用它会生成一个未初始化的对象。我们需要(用send)调用了initialize之后才是正确的方法。
因此,我们大可自己创建一个新的私有方法来避免透过new来创建新的方法。当然如果只是作为父类的,更是不用担心了。
话说回来…把new设置成私有不就行了吗?private :new 啊。啊…对哦…哈哈哈。
我们知道,在类里定义方法是要用def关键词,而定义类方法的话,最好的方式就是用class << self开启类方法的定义域。
不过,def关键词和alias关键词类似,都是脚本在读取的阶段就已经由解释器(系统)处理了的。
如果要在运行的时候追加方法的定义,尤其是方法名字和内容还未知的情况下,我们需要用define_method来达成这个效果。
让我们直接看范例,比较一下def和define_method的差别:
[pre lang="ruby"]
#注意:此段代码无法直接运行
#使用def定义方法
def add(a,b)
return a + b
end
#使用define_method定义方法
define_method(:add) do |a, b|
return a + b
end
[/pre]
参数的定义和def一样。def add(a = 0, b = 0, *args); end 和 define_method(:add) do |a = 0, b = 0, *args| end是一样的。
我们知道,如果呼叫method会获得这个实例的方法对象(的引用)。得到的是该实例所属的,绑定了的方法对象。
我们可以调用unbind参数来获得一个解绑了的,无绑定的方法。这是UnboundMethod(无绑定方法)的实例,无法被调用。
这个无绑定的方法必须调用bind来绑定一个对象,而且是限定与定义这个实例方法的类的实例对象,才能被调用。
目前我们并没有遇到过需要解绑方法的情况,因此不附上范例。
我们可以调用类方法instance_method(和限定公共的public_instance_method)来获取未绑定的实例方法。
这个方法可以用bind来指定一个对象作为接受者(receiver),完成方法的绑定而允许调用。
[pre lang="ruby"]
class AAA
def initialize(v)
@aaa = v
end
def abc
p @aaa
end
end
#实际调用:
a = AAA.new(7)
method_a = AAA.instance_method(:abc)
method_a = method_a.bind(a)
method_a.call #输出:7
[/pre]
为什么要知道这个呢?方法在创建实例的时候就有了啊,怎么还需要再来个移花接木呢?
是这样的。instance_method 和 bind 和 define_method 配合,能挥它威猛的实力。假设我们有如此的代码:
[pre lang="ruby"]
class AAA
def add(a,b)
a + b
end
def sub(a,b)
a - b
end
def p_add(a,b)
p "答案:"
p add(a,b)
end
def p_sub(a,b)
p "答案:"
p sub(a,b)
end
end
[/pre]
我们可以缩写成这样:
[pre lang="ruby"]
class AAA
def add(a,b)
a + b
end
def sub(a,b)
a - b
end
["add", "sub"].each do |s|
sym = :"p_#{s}" #快速创建符号 如:p_add或者:p_sub
old = instance_method(:"#{s}") #获取方法add或者sub
define_method(sym) do |a,b| #创建新方法p_add或者p_sub
p "答案:"
p old.bind(self).call(a,b) #相当于 p add(a,b) 或者 p sub(a,b)
end
end
end
[/pre]
也许两个方法还不能展现这个做法的精辟,不过随着要定义的方法越来越多,或者是方法的名字或内容不固定,就显得很有用了。
类是对象,方法是对象,还有什么不是对象的?没有,一切都是对象。
还记得调用一些方法(比如刚才的define_method就是了)时附上的代码块(Block)吗?它也是对象!
代码块可以作为Proc类的实例被储存为对象。Proc是Procedure(过程)的缩写,可以视为匿名方法(不知道是谁的方法,反正执行就对了)。
创建Proc对象的方式有三种,而调用Proc和调用方法对象一样,都是通过call方法的。让我们直接看范例吧:
[pre lang="ruby"]
proc1 = proc {|a,b| a + b}
p proc1.call(1,2) #输出:3
proc2 = Proc.new {|a,b| a + b}
p proc2.call(1,2) #输出:3
proc3 = lambda {|a,b| a + b}
p proc3.call(1,2) #输出:3
[/pre]
注意:{|a,b| a + b} 和 do |a,b| a + b end 是相似的,但前者的优先度较高。不过只要调用方法时参数都用括号包住,才不用担心什么优先度呢。
而且,就如define_method时我们用的代码块那样,我们是可以指定默认参数和追加参数的。(如 |a = 0, *args|)
Proc.new和proc是一样的(一般用后者)。不过,lambda却不一样。lambda产生的Proc对象是会检查参数数量的。
[pre lang="ruby"]
proc1 = proc {|a,b| p a + b}
lambda1 = lambda {|a,b| p a + b}
proc1.call(1) #报错!执行运算失败! #这是因为只有一个参数,另一个成了nil
proc1.call(1,2) #输出:3 #正常
proc1.call(1,2,3) #输出:3 #这是因为多余的参数会被无视
lambda1.call(1) #报错!参数数量错误!需要2个参数但只给了1个!
lambda1.call(1,2) #输出:3 #正常
lambda1.call(1,2,3) #报错!参数数量错误!需要2个参数却给了3个!
[/pre]
一般我们把lambda产生的,会检查参数数量的Proc对象称为lambda表达式(lambda expression),作为真正的匿名方法(毕竟proc不会检查参数数量)。
lambda除了会检查参数数量之外,还可以从里面调用return来返回内容。proc则不行。要知道一个Proc对象是不是lambda,要调用lambda?方法来判断。
如果我们要给方法递代码块,怎么办?实际上,所有方法后面(参数的后方)都能接受代码块。问题只是在方法会不会去用它罢了。
让我们来看看代码块要怎么呼叫(call)吧!
[pre lang="ruby"]
def abc
yield
end
def cde(&block)
block.call
end
abc { p "hello" } #输出:"hello"
abc #报错!没有附上代码块!
cde { p "hello" } #输出:"hello"
cde #报错!没有附上代码块!
[/pre]
噢,如果没有给代码块指定一个名字,那么就要用yield(产生)关键词来运行这个代码块(可以附上参数,类似call)。
要指定一个名字的话,前缀是&,然后调用的时候呼叫call就对了,后面附上参数。注意:代码块不算在参数列表内。
不过这里就出了一个问题。有些方法,如Array(数组)的count(计量)方法,是可以选择要不要附上代码块的。
但是我们也看到了,如果在没有附上代码块的情况下用yield或者call,就会出错。那要怎么才能避免这个问题呢?
我们可以在方法里面调用block_given?方法来判定是否给了代码块,来判断要进行什么操作。
[pre lang="ruby"]
def abc
if block_given?
yield
else
p "没有代码块"
end
end
abc {p "有代码块"} #输出:"有代码块"
abc #输出:"没有代码块"
[/pre]
Proc的意义就是把代码块封装起来,作为一个对象,因此可以作为普通的参数来递入给方法,或者直接使用。
如果已经是封装成Proc对象的代码块呢?怎么递入上列的方法里面?那就在参数前面加&符号。
一般遇到这种情况的时候,请用lambda而不是proc来封装代码块。proc比较偏于后台的运作,而不是前端的调用。
[pre lang="ruby"]
def abc(&block)
block.call
end
a = lambda { p "hello" }
abc(&a) #输出:"hello"
[/pre]
总而言之,Ruby还有非常非常多的东西可以发掘,也还有很多还没介绍的事物。比如Fiber(纤程,将在解析事件原理时提到),Enumerator(枚举器)等等。
原本还想写更多的(甚至想介绍元编和进一步解说单例类),但是我觉得到这儿已经很足够了。接下来的章节,我们会真正地进入RGSS3的系统解析。
届时,如果遇到了什么看不懂的(或者忘了)信息,还请再次回来参考属于基础理论篇的第一和第二章。
|
评分
-
查看全部评分
|

 写轮眼

 发表于 2016-12-31 22:30:53

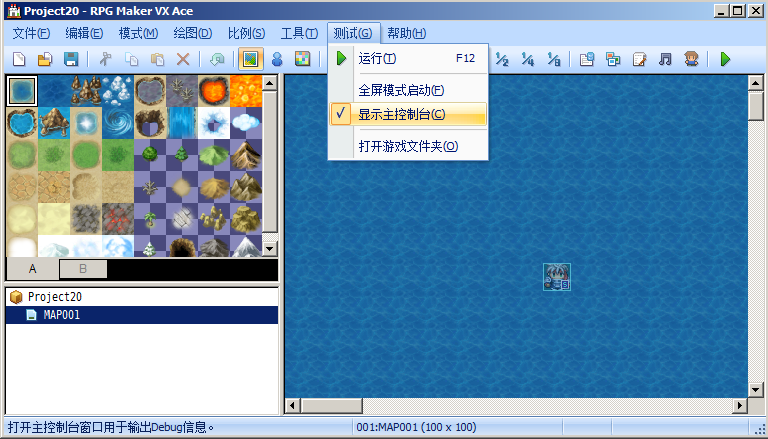


 提升卡
 沉默号角
 喧嚣号角
 变色卡
 升龙剑


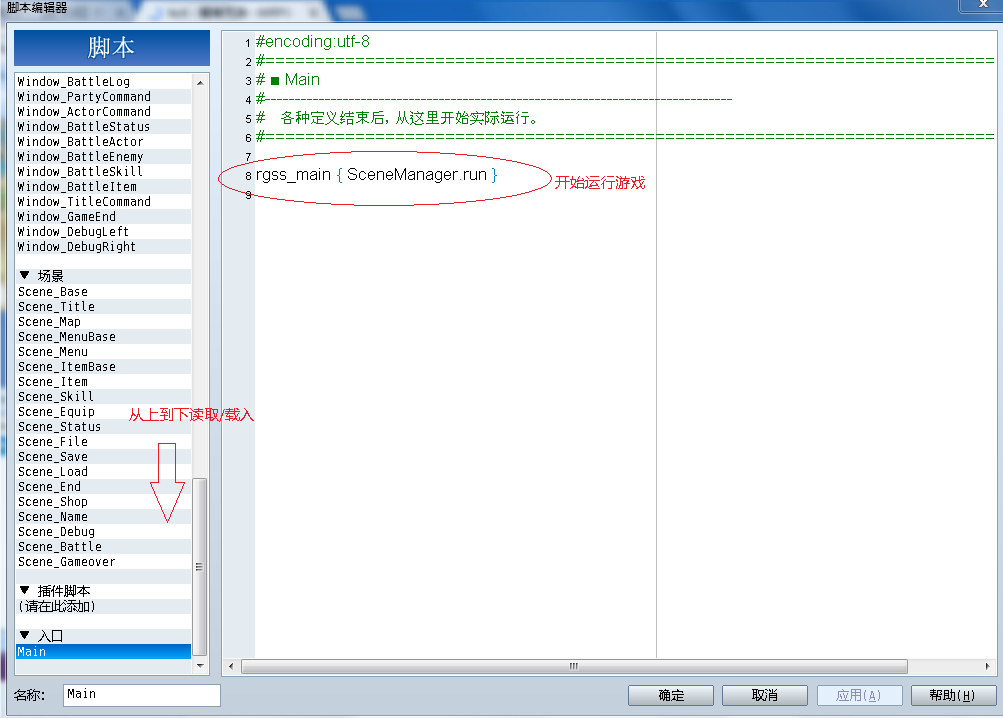
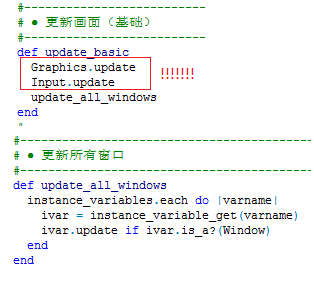
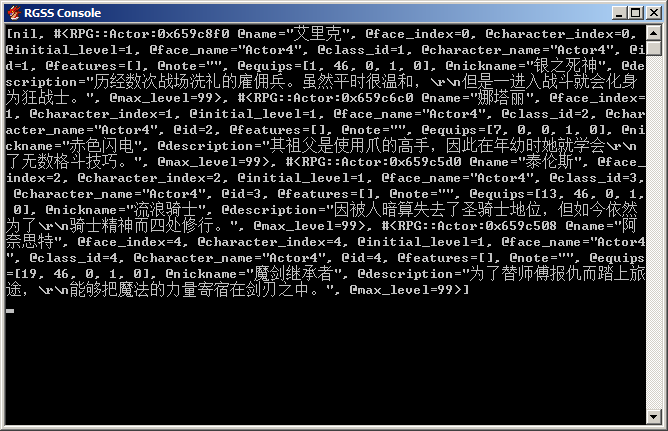
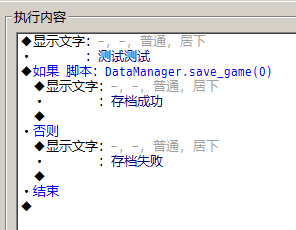
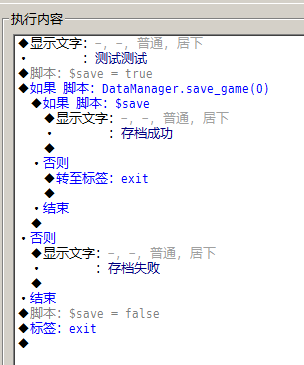


 发表于 2018-6-18 19:10:56


