楼主: taroxd

[版务] RGSS 3 入门教程大家写(第二弹)

[复制链接]
梦石
0
星屑
122
在线时间
552 小时
注册时间
2012-8-18
回帖
1392
发表于 2014-7-4 00:34:01 | 显示全部楼层
本帖最后由 无脑之人 于 2014-7-9 12:45 编辑

Hash

[fold]
哈希表(Hash,又称散列表),是根据关键字而直接访问在内存存储位置的数据结构。也就是说,它通过把键值通过一个函数的计算,映射到表中一个位置来访问记录,这加快了查找速度。这个映射函数称做散列函数,存放记录的数组称做散列表。【二话不说先抄一遍wiki】

Hash可以理解为建立了一个映射,你让10映射到9,让“abc”映射到:abc,让10669588209映射到nil什么的都可以,换句话说,你可以用任意的对象作为关键字,用Hash映射到另一个对象上,而不是像数组那样只能用整数作为索引。并且这个查询过程可以达到数组一样的速度

首先是创建:

  1.   a = { 10 => "abc", "abc" => :abc }
  2.   b = Hash[:abc, 10, :defg, 233]
  3.   c = Hash[[:abc, 10], [:defg, 233]]
  4.   
复制代码
这是一次性做好Hash的方法
  如果你的索引只有Symbol,那么ruby提供了一个语法糖(Ruby 1.9特性):
  1. a = {abc: 10, defg: 233}
  2.   #等同于
  3.   a = {:abc => 10, :defg => 233}
复制代码
你也可以创建一个新的空Hash,然后依次访问并赋值:
  1. a = Hash.new # {} 也可以
  2.   a[:abc] = 10
  3.   a[:defg] = 233
  4.   
复制代码
然后是使用,Hash同样以下标操作符来访问,如:

  1.   a = {}
  2.   a["10"] = 999
  3.   a["10"] #=> 999
  4.   a[10] #=> nil
  5.   
复制代码
他的使用和数组很像【毕竟都是容器】,里面自然也包括譬如insert,delete_if之类的,也含有Enumerable所要求的,下面我们来说说Hash一些独有的功能
  1.关于each,Hash的each是等同于each_pair,也就是说,相当于一个[key,value]为元素的数组,然而Hash也是有each_key和each_value的
  2.关于include?,该方法在Hash中等同于has_key?,不过Hash也有一个has_value?(目测这两个方法效率差远了/ \)
  3.可以使用keys和values得到Hash中的所有关键字和值组成的数组
  4.Hash拥有merge方法,就是把两个Hash合并在一起,h1.merge(h2)时,重复元素按照h2为准;merge可以带块,用于处理冲突情况,块参数是 关键字,旧值,新值:

  1.   h1 = {:a => 1, :b => 2}
  2.   h2 = {:b => 3, :c => 4}
  3.   h1.merge(h2) do |key, old, new|
  4.     new - old
  5.   end  #=> {:a => 1, :b => 1, :c => 4 }
  6.   h1 #=> {:a => 1, :b => 2},破坏性请使用merge!
  7.   
复制代码
【冷门小课堂】
  我们可以通过Hash.new的参数,提供找不到索引的默认值
  1. a = Hash.new(0)
  2.   a[:abc] = 10
  3.   a[:defg] = 233
  4.   p a[:wwwwwww] #=> 0
  5.   b = Hash.new
  6.   p b[:wwwwwww] #=> nil
  7.   
复制代码
Hash的default=方法能够在创建以后调整这个默认值
  【/冷门小课堂】
  
接着是用途方面,Hash的用途虽然说起来好像不多,但是他作为一个基本的数据结构,用途实际上是非常广泛的【换句话说闲着没事你就可以用用】
1. 简化代码结构,使用更加便捷,便于调试
  举个例子,全键盘脚本里面有一大堆全局变量,而且名字好长好长的!用的时候想要存起来一会儿再使用时,却不知道这个存的整数究竟是什么
  我们可以用hash来让他变得更加方便易用
  我们在module Kboard下面加上一句Keys = {}
  接着将里面的$R_Key_A之类的全部换成Keys[:A]
  还有GetKeyState.call(rkey)之类的全部换成GetKeyState.call(Keys[rkey])
  这样的话,我们在使用时传递的是Symbol,调试过程中可以清晰的看出是检测哪个按键,并且名字也变短了,何乐而不为呢?
2.独立开关啊之类的数据库
  独立开关本质上便是使用了Hash,地图上的事件实际上也是用Hash来存储的,可见Hash能适合做一个存放数据的东西
3.进行高速的查找
  如果是需要一些奇怪的算法时,使用Hash有时能够降低算法的复杂度哦【会玩算法了还用看教程?2333】
  
  
  【冷门小课堂】
  Hash的效率
  Hash看起来好像是很平常很普通,实际上它的实现是非常具有创造性的,他超越了数组顺序查找【O(n)】,线索树查找【O(lgn)】的效率达到了神奇的O(1)!
  这么说可能不太明白,我们来用普通的数组查找写一个伪Hash来看看【希望读者能够尝试一下】

  1.   class MiaoHash
  2.     def initialize
  3.           @keys = []
  4.           @values = []
  5.         end
  6.         def [](key)
  7.           if(@keys.include(key))
  8.             @values[@keys.index(key)]
  9.           else
  10.             nil
  11.           end
  12.         end
  13.         #[]=和其他一些方法也类似,不过多书写了
  14.   end
  15.   
复制代码
上面的代码,在每次取值的时候,都经过至少一次数组查找,数组有多长,他便要查多长,效率某种意义上来讲很低,数组增长一倍,他的查找基本上就慢一倍
  就算是很流弊的写出了Ruby版红黑树【这玩意在Ruby里效率目测比上面顺序查找还低】,他的查找也是lgn的,数组增长一倍,他的查找平均起来就要多经过一次,增长1024倍,查找便是增加了10倍【其实他还强制要求元素可以比较,这是功能上的缺陷】
  所以说,要善于利用Hash,让自己的游戏更流畅哦XD
  【/冷门小课堂】
  
  【冷门小课堂】
    在我刚开始学Ruby的时候,我一直认为Array是一种特殊的Hash,不得不说,这样理解貌似很正确
        但是实际上呢,反而是Hash利用了Array的O(1)随机存取特性,才做到了O(1)的查找
        Hash的原理是,将关键字进行一个计算得到一个整数,对于这个整数进行计算得到一个数组的下标,然后直接达到那个下标的位置获取到目标对象
        那么,这个计算出来的整数如果重复了怎么办呢?这种情况被称为碰撞,他的解决办法有很多,请看教程最下方留的wiki地址,不过意思是说,Hash的这种O(1),可以说是理想状态下的,他算是一种均摊O(1),你要是真让它每次都计算出同一个整数那么……………………请允许我找一个被上的表情
        散列表的wiki: http://zh.wikipedia.org/zh-cn/%E5%93%88%E5%B8%8C%E8%A1%A8
  【/冷门小课堂】

  【误区】
    之前听到过这样的说法:“如果需要整数作为索引就务必用Array,其他的对象再用Hash”
    这确实是一个误区,举一个简单的例子,假如说我需要1, 10669588209, 1e999作为索引,难道我要开1e999这么大的数组么?当然这是不现实的
    对于一些零散的整数作为索引时,我们仍然建议使用Hash,它能够有效的节约你的空间。而对于一些连续的整数,或者间距很小的整数作为索引时,用Array则是比较合理的,不过,对于频繁的中间插入删除的话【比如事件这种东西】仍然建议使用Hash,他的行为比较有效率
  【/误区】
  
  Hash结合Symbol有非常好的效果,请读者善于利用Hash的特性,为自己的游戏增光添彩吧XD
  完毕~☆
  [/fold]
  好晚了= =想写的更多也撑不住了……只希望这种半昏迷状态不要出什么岔子就好Orz……

Plus:Hash实际应用之Cache模块
[fold]
Cache模块是用来进行高速缓存的,每次生成Bitmap都需要一定的时间,因此我们可以暂存起来减少一遍又一遍的生成和释放
Cache的核心是一个Hash,在这里我提供一个示例代码供读者参考,当然,只是示例,提供一个思路而已
@data #据说这样可以防止@被坑
[pre lang="ruby" line="1"]module XXXCache
  @data = Hash.new
  def self.load(bmp_addr)
    return @data[bmp_addr] if @data[bmp_addr] && !@data[bmp_addr].disposed?
    @data[bmp_addr] = Bitmap.new(bmp_addr)
  end
end[/pre]
首先我们创建了一个Hash进行高速缓存
然后定义了load方法,这个方法获取到一个字符串,紧接着进行已有图片的查找
如果已经有这个Bitmap对象,并且没有被释放,那么他就直接返回Hash里面已有的Bitmap,不进行图片创建
如果没有,那么我们就建立一个新的Bitmap,并将它放进去【,作为最后一个语句,这个Bitmap将被返回】
[/fold]

点评

hash = { a: 1, b: 2, 12345 => '上山打老虎' } hash[:a] hash[12345]  发表于 2014-7-7 16:56
读取.................................................................  发表于 2014-7-7 12:40
/hæʃ/ 不要读哈希  发表于 2014-7-7 12:19
怎么读Hash啊魂淡  发表于 2014-7-7 12:12

评分

参与人数 1星屑 +150 梦石 +1 收起 理由
taroxd + 150 + 1 认可答案 extra

查看全部评分

我要填坑!我要背单词!我要学日语!我要每天锻炼!
好吧呵呵= =
回复

使用道具 举报

梦石
0
星屑
76
在线时间
1379 小时
注册时间
2012-7-5
回帖
1643

开拓者

发表于 2014-7-4 08:29:35 | 显示全部楼层
本帖最后由 taroxd 于 2014-7-4 09:24 编辑

[面向对象]-[脚本为什么都要插入到main以上]


[fold=脚本为什么都要插入到main以上]
脚本都是从上到下顺序运行的

这一点非常重要, 实际RGSS3运行时先加载dll, 再从上到下定义完所有的module和class, 最后从Main里的rgss_main { SceneManager.run }开始运行
实际上是调用(运行)了rgss_main方法, 而上面的脚本只起定义的作用而没有被实际运行
那么Main后面的内容执不执行呢?

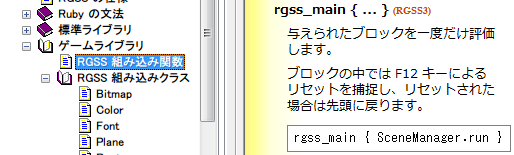
就RGSS3来说, 我们要先看一下rgss_main { ... }是何方妖怪, 翻开F1-RGSS参考-游戏库-RGSS内部函数
QQ截图20140704081106.png
大概意思是说, 给这个方法一个块(关于块的含义请参考其他相关页面), 它就把这个块执行一遍然后继续运行下面的脚本, 按F12将重新调用这个方法
亦即, 只要有这个方法, 游戏就能被运行一遍直到场景(Scene)全部释放, 这个游戏结束, SceneManager.run 的使命完成了, 脚本继续向下运行
当下面没有脚本的时候, 游戏自动退出
当然也可以造一个游戏不能自动退出的假象:
  1. rgss_main { SceneManager.run }
  2. msgbox '~!@#$%^&*()'
  3. rgss_stop
复制代码
[/fold]

内容好少

评分

参与人数 1梦石 +1 收起 理由
taroxd + 1 认可答案

查看全部评分


  -fk: -azogi:
回复

使用道具 举报

梦石
0
星屑
9557
在线时间
5074 小时
注册时间
2013-6-21
回帖
3459

开拓者贵宾剧作品鉴家

发表于 2014-7-4 20:49:23 | 显示全部楼层
本帖最后由 RyanBern 于 2014-7-8 10:48 编辑

[fold=数组的概念和常用操作方法]
内置基本类——数组
这是一个大家最喜欢用的类了,对不?反正在不太理解它之前呢,大概知道这是一个什么东西,用着也挺爽的。但是万恶的F1竟然只给出了数组的部分方法,导致我们看不懂大神的脚本,这就有点不太爽了(说着玩呢,F1给的东西足够多了,应该谢谢它才是)。
•数组是个啥?
数组,顾名思义,就是数据的(有序)集合。它按照特定的编号,把一堆数据组成一个整体,统一处理。在Ruby中,数组的特性和C系语言不太相同,比较明显的特征就是:长度可变,类型可以不必相同(真的不必相同么?)。在这点看来,Ruby中的数组倒是和向量(Vector)比较相似。它们内部实际上都是Object指针,这就实现了“类型可不必相同”(不过实际上也可以认为是一样的,都是Object)。

举个简单的例子,假如你要用四个变量分别代表四个个人的年龄,你可能这样写:
  1. x1 = 18 # 第一个人的年龄
  2. x2 = 18 # 第二个人的年龄
  3. x3 = 24 # 第三个人的年龄
  4. x4 = 21 # 第四个人的年龄
复制代码
这不是胡闹么?假如要有100个人的话,要写100个变量,机器受得了你也受不了。
于是我们就有了数组:
  1. x = [18,18,24,21]
  2. x[4] = 9 # 让第五个人的年龄为9
复制代码
数组还未细致讲解,这里便出现了几个令人费解的问题:

数组怎么生成?
你设置第五个人的年龄,为啥方括号里面是4?
如果学过其它编程的,还会提出一个问题,这里数组还可以越界的?

好吧我承认我写的顺序不对,那就先从数组初始化开始吧。

•初始化一个数组
Ruby中,所有东西都是对象,数组也不例外。因此能通过调用数组的类方法new来生成数组。
  1. a = Array.new # a 是一个空数组
  2. a = Array.new(3) # a 是一个长度为3的数组,由于未经初始化,这三个单元都是nil
  3. a = Array.new(3, 0) # a 是一个长度为3的数组,所有单元都初始化为0
  4. a = Array.new(4){|i| 2*i} # a 是一个长度为4的数组,所有单元依次为0,2,4,6
复制代码
啥?从来没见这么用的?谁说的?Scene_File(60)就有一个。

我知道你想说啥,初始化数组还有一个更好看的写法,利用方括号。
  1. a = [0,1,2,3]
复制代码
这样写既指定了数组的长度,又指定了数组的初始内容,比较容易阅读。
初始化一个空的数组,用空的方括号[]就可以了。
但是不要忘记上面几种写法啊,假如你要初始化一个数组,单元依次为0,2,4,…,198,如果用前面那种写法,要一行就可以了。
  1. a = Array.new(100){|i| 2*i}
复制代码
否则的话就要这样
  1. a = []
  2. for i in 0…100
  3.   a << 2*i
  4. end
复制代码
多难看,是不是?

咦?怎么不小心把一个不认识的符号打了进去?没关系,我们下面就要说说数组的基本操作,这样就会认识它了。
•数组的基本操作
访问和修改:
有了数组当然要访问它的元素啦,否则你造出来一个东西又不让人家看看里面长啥样岂不是很过分。数组存取的特点是顺序存储,随机访问。数组里面的元素都是连起来放的,就好像种萝卜一样(喂喂,这是啥比喻),所以就是“顺序存储”,如果要访问数组某特定单元时,就可以直接说出这个单元所在的索引(index),你就会马上能找到它。(为啥说个索引就能找到?我就不告诉你其实是指针计算来实现的~)

数组的索引是从0开始的,有效的索引到它的长度(length)再减去1。如果数组一共有5个单元,那么有效的索引就是0,1,2,3,4。那么访问对应索引的方法就是:
  1. self[index]
复制代码
如果对实际不存在的索引进行访问,则会返回nil
  1. a = [1,2,3]
  2. p a[1] # => 2
  3. p a[3] # => nil
复制代码
这种现象称之为数组越界,如果在别的语言中,数组越界是很危险的事情,会发生各种奇葩的问题,在Java中能好点,如果数组越界了,系统会扔出数组边界溢出异常,然后就闪退了。但是在Ruby中,越界却是返回了个nil,并不报错。不过,一旦对nil进行操作的话,会发生各种No method error,这样系统也不得不退出了。

其实索引可以是负数,表示从最后一个单元开始算的第几个。
  1. a = [1,2,3,4]
  2. p a[-1] # => 4 # 从后往前数第1个
  3. p a[-3] # => 1 # 从后往前数第3个
  4. p a[-5] # => nil # 从后往前数第5个,当然,没有这个东西,返回nil
复制代码
在这里扯一个笑话,有一天小明到杂货店去买水,跟老板说:“要两瓶水”。老板拿出两瓶水,说:“两瓶水,拿好。这是第0瓶,这是第1瓶。”小明说:“老板,给我第2瓶”。说完就拿起后面那瓶一口喝下去,随后喷了出来,喊道:“烫烫烫烫烫烫……”

啥?没懂?好吧我承认笑点低了点。不过数组索引是从0开始的总要记住吧,还有就是注意越界,要不然烫死你~

说了访问,该说说怎么修改了。这里要用到这个方法:
  1. self[index] = val
复制代码
意思就是将索引为index的地方修改成val。
如果index是一个有效的,直接修改则是。如果index超过了数组的范围呢?会发生什么情况?我们试试:
  1. a = [1]
  2. a[3] = 0
  3. p a # => [1,nil,nil,0]
复制代码
在这里,如果对实际不存在的(正数)索引赋值,那么就会把那个位置赋上你需要的值,并且会在中间补上nil。

那么,如果索引是负的,并且找不到相关位置,那么会怎样?答案:数组越界,闪退。
  1. a = [1]
  2. a[-1] = 0 # =>[0]
  3. a[-3] = 0 # out of Array
复制代码
看来数组还是会越界的。

小知识补充:方法’[]’和’[]=’
千万别小看了这两个方法,它们的作用不仅仅是数组索引访问那么简单。实际上,任何类都可以定义这两个方法,从而达到某种功能,这并不是数组特有的方法。
定义的方式为
  1. def [](index)
  2. # do something
  3. end
  4. def []=(index,value)
  5. # do something
  6. end
复制代码
使用方法和数组的相同,分别是
  1. obj[i]
  2. obj[i] = value
复制代码
这样看起来obj像是一个数组一样,而它实际又不是个数组。啥?你问我有没有例子?当然有,Game_Variables,Game_Switches不都是例子么?我好像说了我不该说的……

数组的切片(slice):
利用’[]’方法,我们可以对数组进行切片,从而达到访问数组一部分的目的。具体的方法为:
  1. self[a,b] # 从第a个单元起,切取b个单元
  2. self[a..b] # 切取索引为a和b之间的所有元素,一共切取b-a+1个
  3. self[a…b] # 切取索引为a和b之间,但是不含b的所有元素,一共取b-a个
复制代码
例:
  1. a = [2,4,6,8]
  2. p a[0,2]  # => [2,4]
  3. p a[1..3]  # => [4,6,8]
  4. p a[1…3] # => [4,6]
复制代码
再来几个特殊的:
  1. a = [1,2,3,4,5]
  2. p a[4..7] # => [5]
  3. p a[6..10] # => nil
  4. p a[-3,3] # => [3,4,5]
复制代码
在这里,常用a[-n,n]表示从后往前切取n个单元。
注意,数组切片不会破坏原来的数组,返回的其实是一个新的数组,只不过是按照原始数组操作而已。
注:这个利用方括号的方法和下面两个差不多:
  1. slice(index)
  2. slice(start,length)
  3. slice(range)
复制代码
可以利用重磅方法slice!直接对原数组进行操作,有破坏性。

数组的遍历:
这个是最常用的方法了。可惜本人已经被RGSS1教坏了,用的是for~end,在这里不想再提起陈年旧事,因此我要改邪归正,用正规的遍历写法。在这里深深悔过。
  1. each{|x|...}
  2. each_index{|i|...}
  3. each_with_index{|item, index|...}
复制代码
后面通常跟一个block或者是do~end,表示你不但要遍历数组,还要逐个地按照取出的单元进行操作。第一个那个是对数组元素从前到后遍历,第二个是对数组的索引从0到最后开始遍历。第二个等同于:(0…ary.size).each{|index| …}
第三个即含有数组的每个单元,又有数组每个单元的索引index,这个方法当数组内容和索引都有用的时候比较实用。
例:把数组a的每个元素都变成它的2倍
  1. a = [1,2,3,4]
  2. a.each{|x| x *= 2}
  3. p a # => ???
复制代码
这样写对吧?当然不对,试试发现,a还是[1,2,3,4]。为啥?因为那个x是块的参数,对参数进行改变怎么会影响实际参数的值呢?显然不行。应该这样:
  1. a = [1,2,3,4]
  2. a.each_index{|i|a[i] *= 2}
  3. p a # => [2,4,6,8]
复制代码
其实到后面还有更方便的方法collect!和map!,它们都可以实现这个功能。
再来一个例子:
  1. a = [2,3,5,7,11]
  2. a.each_with_index{|num, i| print sprintf("第%d个素数是%d", i+1, num)}
复制代码
用了sprintf表达式不要拍我,我知道应该用内嵌表达式~

数组的添加和删除:
其实利用索引的方法,可以基本实现数组的添加和删除,但是使用一些功能还是不太方便。比方说你要删除数组第0号单元,该怎么做呢?

a = a[1,a.size-1]是吗?好像没啥问题啊(大雾)。
其实可以这样:
  1. a.slice!(0)
复制代码
学以致用,很好,不过我们还有更简单的写法。

因此我们要用下面几个常用的方法来解决这些常用的操作:

push(obj1, obj2,…):将obj1,obj2,…依次插入到数组最后,这样做会让数组的长度增加,插入几个增加几。
  1. a = [1,2]
  2. a.push(3) # => a = [1,2,3]
复制代码
这个操作,和使用运算符’<<’的效果相同。因此上面的那句,也可写成:
  1. a = [1,2]
  2. a << 3 # => a = [1,2,3]
复制代码
pop:将数组的最后一个单元删去,这样做会让数组的长度-1,并且,返回被删除的元素。这是一个非常好的功能,就好像一个一个地从数组后面拿出来东西用,用完了就扔掉一样。
如果数组是空的,则返回的是nil
例:这是RM的F1给出的例子
  1. array = [1, [2, 3], 4]
  2. p array.pop      # => 4
  3. p array.pop      # => [2, 3]
  4. p array          # => [1]
  5. p array.pop      # => 1
  6. p array.pop      # => nil
  7. p array          # => []
复制代码
顺便说一下,pop可以带参数pop(n),这样的话就是从后面删除n个,这个和slice!(-n,n)也相同。

shift:与pop相反,这个方法是删除数组的最前面的一个单元,并且返回被删除的元素。例子就不多说了。
同样的,shift也可以跟一个参数shift(n),这个和slice!(0,n)相同。

unshift(obj1,obj2,…):与push相反,这个方法是在数组最前面依次插入元素obj1,obj2,…,例子也不说了。

如果是任意位置插入,就要用到下面的方法了:

insert(index, obj1, obj2,…)
它表示按照顺序插入obj1,obj2,…插入的起始位置的索引是index
例:还是F1的例子
  1. ary = ["foo", "bar", "baz"]
  2. ary.insert 2, 'a', 'b'
  3. p ary                  # => ["foo", "bar", "a", "b", "baz"]
复制代码
如果想要仅仅删除的话,就要用到下面三个方法了:

delete(obj):删除所有和obj相同的元素

delete_at(index):删除索引为index的那个元素

delete_if{|item|...}:删除符合条件的所有元素,条件在块中给出。

当然,如果没有这个元素或者是没有这个索引,那么方法什么也不做。
例子:
  1. a = [1,1,2,3,5]
  2. a.delete(1)   # => [2,3,5]
  3. a.delete_at(1) # => [2,5]
复制代码
另外一个方法是reject!,它的单词含义是“拒绝”,实际意义是删除所有满足要求的元素,如果被操作的数组发生改变,返回self,如果没有满足条件的元素可供删去,返回nil。使用时通常要带一个块,这个和delete_if很相似。
  1. a = [0,1,2,3,4,5]
  2. a.reject!{|i| i % 3 == 0} # 删除所有3的倍数
  3. p a # => [1,2,4,5]
复制代码
如果reject不带叹号,则不会改变a,而是返回一个删除之后的数组,这点和delete_if就不一样了。

数组的查找:
如果我们想在数组中进行查找,那么我们就要用到下面的几个方法。

include?(obj):判断数组中是否含有obj,这个我想大家都熟悉了吧。

find{…}:根据块来查找符合条件的(第一个)元素。返回这个元素,如果不存在,返回nil。

select{…}:根据块来查找符合条件的所有元素,而后把它们做成一个数组返回。如果不存在这样的元素,返回一个空数组。

例:
  1. a = Array.new(10){|i| i}
  2. p a.find{|i| i % 3 == 2}   # => 2
  3. p a.find{|i| i % 11 == 10}  # => nil
  4. p a.select{|i| i % 3 == 2}  # => [2,5,8]
复制代码
数组之间的操作:
数组和数组之间也有一些操作,这给我们处理数组无疑又提供了便捷的方法。

self + other:连接两个数组,加号左边的在前,右边的在后,返回连接之后的数组。
  1. a = [1,2]
  2. b = [3,4]
  3. p a + b # => [1,2,3,4]
  4. p a   # => [1,2] 没有变化
  5. p b  # => [3,4] 也没有变化
复制代码
这个相加的方法和concat方法不同,concat方法的使用:

self.concat(other):将other连接到self的后面,但是连接之后,self发生变化。也就是说concat对原始数据有破坏性。

self – other:取两个数组的差集,即出现在self中的元素,但不出现在other中的元素。
self & other:取交集,即既出现在self中的元素,又出现在other中的元素.
self | other:取并集,即出现在self或者other中的元素。

例:
  1. a = [1,2,3,4]
  2. b = [2,4,5,6]
  3. p a – b # => [1,3]
  4. p b – a # => [5,6]
  5. p a & b # => [2,4]
  6. p a | b # => [1,2,3,4,5,6]
复制代码
self == other:判断两个数组是否相等,这里相等的含义是大小,内容完全相同。

数组的排序:
这里有sort和sort!两个方法,前者会新生成一个排序数组,后者则会直接在原始数据上修改。
这两个方法都可以带块,表示排序的方式(即自己指定什么叫“大于”,什么叫“小于”)。不带块时,用’<=>’方法来比较两个元素的大小。(不要问我’<=>’是什么)

说了这么多,还不如直接写个例子说明问题。
  1. a = [2,4,1,3,6,-2,-3,-9]
  2. a.sort!{|x,y| y.abs - x.abs}
  3. p a # => [-9,6,4,3,-3,2,-2,1]
复制代码
这个例子是说把a中的元素按照绝对值从大到小排序。那么这个块中的结构该如何解释呢?首先|x,y|是参数,不用管他,后面的y.abs – x.abs是个式子,这个式子是可以计算的,并且返回值要能和0作比较。那么块可以解释为,判断两个东西x,y谁更靠前,那你就算算后面那个式子y.abs – x.abs,如果它比0要小,那么x在前面,比0大的话,y在前面。如果等于0的话,证明如果按照这个标准来排,它们的“大小”相同。至于它们的顺序,这个就不好说了。如果排序法是稳定的,那么顺序应该和未排序之前相同。不过,鬼知道它用了什么排序法,稳定性也无法得知。

在RGSS3中的很多地方出现了sort!这个方法,比方说BattleManager(352),这里是按照速度确定行动次序,再比方说Game_Party(91),这里是按照次序获取所有武器。

补充:还有名为sort_by/sort_by!的方法,它的作用是在原始数据和另一组值(通常是数字)之间建立一一映射,并且按照这另一组值的顺序排序。使用时要用块指定映射规则。
  1. a = ["a", "aa", "aaaa", "aaa"]
  2. a.sort_by!{|s| s.length} # => ["a", "aa", "aaa","aaaa"]
复制代码
和之前的一样,sort_by会返回一个新生成的数组,而sort_by!则是直接在原始数组上操作。
这样写起来更加方便,不过用sort!也可替代,只需要定义好映射函数而已。

还有几个方法,很常用,想来想去还是放到查找这里比较好。
max
max{|a,b| ...}:查找最大值,使用的时候可以带块也可以不带。不带块的情况下,用方法'<=>'确定所有元素的大小关系,返回这个元素。带块的情况下,要指定“在什么意义下的最大”,这点跟sort所带的块比较相似。例如:
  1. a = ["a", "aaa", "aaaaaa", "b"]
  2. p a.max # => "b"
  3. p a.max{|s1, s2| s1.length - s2.length} # => "aaaaaa"
复制代码
块内的意义已经在sort方法里面描述,这里不再叙述。

当然,也有max_by这个方法
max_by{|item| ...}:按照一定的标准寻找最大值,这个跟sort_by里面的参数也相似,如果忘了看看上面的OK。
于是上面的第二个例子可改写为:
  1. a.max_by{|s| s.length}
复制代码
min
min{|a, b| ...}
min_by{|item| ...}:和max系列对应,只不过求的是最小值,用法和max系列完全一样。

数组的其他方法:
conpact
compact!:删除数组中的所有nil,前者会返回删除之后的新数组。而后者会破坏原始数据,如果原数组中有nil,返回self,如果没有nil,返回nil。

clone:复制一个数组,我们知道,直接把连个数组之间进行赋值,只是对同一个内存空间起了个别名,如果想要生成一个备份数据,那么就要用clone方法。其实这个方法对所有object来说都是一样的,如果仅仅是要做一个原始数据备份,那么就clone一下。不过,这个方法有一点一定要注意。clone是浅层(shallow)的拷贝,它只负责拷贝数组本身的内容,而不负责拷贝数组元素指代的内容。我们举一个例子。
  1. class A
  2.   attr_accessor :x
  3.   def initialize(x = 0)
  4.     @x = x
  5.   end
  6. end
  7. a = Array.new(3){|i| A.new}
  8. b = a.clone
  9. p a[0],b[0] # => ???
  10. a[0] = A.new(1)
  11. p a[0],b[0] # => ???
复制代码
你们猜猜两次输出会输出什么?
第一次a[0]和b[0]都是一个东西,一个地址,@x值也是一样的。
第二次a[0]和b[0]是不同的。
现在明白那句“浅层的拷贝”是啥意思了么?不明白不要咬我。

map{|item| ...},collect{|item| ...}:这两个方法的功能差不多,首先要对数组进行遍历,然后依照遍历的每个元素,按照一定的规则产生一个新的值,逐一返回,并做成一个数组作为整体的返回值。块中写的东西就是按照什么规则产生什么值。例如:
  1. @weapons.keys.sort.collect {|id| $data_weapons[id] }
复制代码
这是Game_Party(91)的一句话,collect之前那一段的意思是,@weapons是一个Hash表,现在我们取出它所有的主键keys,然后按照从小到大排序,到这里,返回的应该是一个数组。而后,对这个数组进行collect,从前向后遍历所有的单元(这里就是那个参数id),而后,根据每一个id,对应$data_weapons[id]中的一个RPG::Weapon对象,将所有对应出来的RPG::Weapon对象做成一个数组,返回它。不知道说明白没有。

现在看看这个方法的名字还是比较形象的,collect的意思是“收集”,map的意思是“对应”,而方法的作用,的确是“遍历数组,并且按照遍历的单元收集数据”,或者说“遍历数组,并且按照遍历的单元一一对应出一组新数据”。
这让我想起了RM技术区的一个帖子:字符串转数组。
现在字符串str = "1 2 3 4",怎么样才能把它转换成一个数组[1,2,3,4]?
str.to_a是不是?多么简洁?看玩笑呢吧。
那应该咋办?应该是:
  1. str.split(/ /).map{|x| x.to_i}
复制代码
这一句就可以了,不过里面牵扯了字符串的方法,不懂的同志恶补一下吧。
当然,这两个方法都有其对应的重磅方法map!和collect!,表示直接在原始数组上做变换。这样我们就可以解决很久以前我们提到的一个问题,把数组中所有元素都变成二倍。
  1. a = [0,1,2,3]
  2. a.map!{|i| 2*i}
复制代码
看起来方便多了,也好看多了。

flatten:数组的展开。这个方法用得不多,RGSS3里面反正是没找到。(啥?没找到那说了有啥用),它的作用是处理数组嵌套的问题,由于数组中间的元素仍然可以是数组,那么一个数组经过处理之后,数组中间所有的数组都会被展开,有几层展几层。这个方法可以变高维数组为一维数组。例
  1. a = [1,[2,3],4,[5,[6,7]]]
  2. a.flatten # => [1,2,3,4,5,6,7]
复制代码
当然,可以指定深度,用flatten(depth),表示展开到第几层,更深的就不展开了。

clear:清空数组,就是删除所有的元素。

uniq:
uniq!:唯一数组。这两个方法会把数组中重复的元素去除,只留下第一个。对于前一个方法,总是返回一个新的数组,原数组不变。对于后面的重磅方法,如果数组发生变动,返回self,如果数组未发生变动,则返回nil。
注:可以用块来指定啥样元素叫“重复”,比方说下面这个。
  1. a = ["1.2", "2.3", "2.5", "3.7", "3.9", "3.98", "4.0"]
  2. p a.uniq{|s| s[/^\d+/]} # => ["1.2", "2.3", "3,7", "4.0"] 小数点之前的数相同就认为是重复的
复制代码
↑这个代码在RMXP上得不到预期结果,是不是RMXP的Ruby版本太旧?

all?{|item|...}:遍历整个数组,块中的语句返回true或者false,如果遍历结束后,块永远返回true,则这个方法返回true,否则返回false。
  1. a = [1,3,5,7,9]
  2. p a.all?{|n| n % 3 != 0} # => false
  3. p a.all?{|n| n %2 != 0} # => true
复制代码
意思就是看看所有元素是不是均满足一个条件。

any?{|item|...}:遍历整个数组,块中的语句返回true或者false,如果任意一个单元使得块返回true,则整体返回true,否则,块永远返回false时,返回false。
  1. a = [1,3,5,7,9]
  2. p a.any?{|n| n % 3 != 0} # => true
  3. p a.any?{|n| n % 2 == 0} # => false
复制代码
意思就是看看有没有元素满足这一条件。

数组的常用方法就说完了。
[/fold]

点评

↓辛苦,是我写的太多了,而且有一堆废话……  发表于 2014-7-10 16:29
于是在下专门写了个代码来转换阁下的文本  发表于 2014-7-10 15:51
↓这破玩意竟然有几万字……我一点都没有注意啊  发表于 2014-7-10 15:26
正在做chm的在下看到阁下这篇几万字的论文深深的手抽= =|||【首先要把阁下的教程复制粘贴修饰成htm文档  发表于 2014-7-10 15:23
VA是1.9.2  发表于 2014-7-6 19:38

评分

参与人数 3星屑 +50 梦石 +2 收起 理由
taroxd + 2 认可答案 extra
kuerlulu + 20 精品文章
无脑之人 + 30 精品文章

查看全部评分

回复

使用道具 举报

…あたしは天

梦石
0
星屑
2308
在线时间
4033 小时
注册时间
2010-10-4
回帖
10548

开拓者贵宾

 楼主| 发表于 2014-7-5 18:10:17 | 显示全部楼层
本帖最后由 taroxd 于 2014-7-5 20:16 编辑

[fold=内置基本类——字符串]

字符串在RGSS3的脚本中地位并不高。但是,我们在自定义脚本的时候,常常会用到数据库里的“备注”功能。
这时候,就需要一点我们处理字符串的能力了。
而处理字符串,往往和正则表达式密切相关。因此,这一节仅仅会介绍对字符串简单的处理。
因为如此,这一节

字符串的生成:
字符串可以用单引号和双引号生成,这个想必大家都知道。
同时,我们也知道,双引号的字符串可以内嵌。
值得注意的是,内嵌表达式的形式可以是多种多样的。并且结果会自动转换为字符串(通过to_s方法)
如:
[pre lang="ruby" line="1"]
a = '#{1}'  # 没有替换效果
"the variable a is #{a}"              #=> the variable a is #{1}
"It is #{1 + 1 == 2} that 1 + 1 == 2" #=> It is true that 1 + 1 == 2
"#{a << '0' until a.size > 10; a}"    #=> #{1}0000000
[/pre]
总之,#{}里面就是另一个世界。你可以善用这个功能。
此外,还有两种生成字符串的方法,但更加不常用。在此不做介绍。

It's Play Time!
这次我们来玩事件脚本。
看到事件-脚本那个指令了吗?没错,玩的就是你!艾里克啊我又来调戏你了。

阅读默认脚本,我们看到
[pre lang="ruby" line="1"]
class Game_Actor < Game_Battler
  attr_accessor :name                     # 名字
  attr_accessor :nickname                 # 称号
  #...
end
[/pre]

name? nickname? 看这个样子就像是字符串啊。今天我们就来调戏这两个家伙。
什么?看不懂attr_accessor?给我复习前面的知识去233
现在事件脚本栏的第一行打好 actor = $game_actors[1]
这样,我们就把这个Game_Actor类的实例艾里克拿到手了。
想要弄清楚原因的话,可以阅读Game_Actors类的定义。你应该有这个实力去阅读,我这里就不再展开了。

[pre lang="ruby" line="1"]
actor = $game_actors[1]
# 现在,我们干什么呢...
# 对了,就把昵称加到名字前面吧!
actor.name =   # 一行写不下,换行
"#{actor.nickname}·#{actor.name}"
[/pre]

这里用到了我们刚刚讲过的内嵌表达式。
执行这个事件,我们来打开菜单看一下艾里克的名字。
不出所料,果真变成了“银之死神·艾里克”!

下面开始正式介绍字符串的一些常用方法。
要想掌握的话,模仿上面那一个事件脚本,开始玩吧!

+ 将两个字符串连在一起,生成一个新的字符串
[pre lang="ruby" line="1"]
actor.name = actor.name + '亲' # 艾里克亲
[/pre]
<< 或 concat: 将后一个字符串的内容连接到这个字符串中
注意:参数传入整数的话,会有奇怪的事情发生哦~
因此上面的代码,更好的实现应该是:
[pre lang="ruby" line="1"]
actor.name << '亲' # 艾里克亲
[/pre]
或者
[pre lang="ruby" line="1"]
actor.name.concat('亲') # 艾里克亲
[/pre]
* 将字符串重复n遍
[pre lang="ruby" line="1"]
actor.name *= 2 # 艾里克艾里克
[/pre]

== 两字符串相等

=~ 正则表达式匹配(下一章)

str[index] / str.slice(index): 获取第index位的字符,没有则为nil
index的表示方式和数组一样。
str[start, length] / str.slice(start, length): 从start开始,获取长度为length的字符串。没有则为nil
str[range] / str.slice(range): 获取区间内的字符串,没有则为nil
str[regexp] / str[regexp, capture] / str.slice(regexp) / str.slice(regexp, capture): 获取正则表达式匹配的字符串。见下章。
str[match_str] / str.slice(match_str): 如果match_str是str的子字符串,则返回子字符串,否则返回nil
[pre lang="ruby" line="1"]
puts actor.name[0]        #=> 艾
puts actor.name.slice(-1) #=> 克
puts actor.name[6]        #=> nil
puts actor.name[-2, 2]    #=> 里克
puts actor.name[0..1]     #=> 艾里
puts actor.name[1...-1]   #=> 里
puts actor.name['艾里']   #=> 艾里
p actor.name['艾里克亲']  #=> nil
[/pre]
总结:[]和slice这两个东西,还真的就是完完全全一样的……

str[index] = other_str
str[start, length] = other_str
str[range] = other_str
str[regexp] = other_str
str[regexp, capture] = other_str
str[regexp, name] = other_str
str[match_str] = other_str
将对应部分的字符串替换为other_str。对应部分参考str[]
[pre lang="ruby" line="1"]
actor.name['克'] = '亲'
actor.name[1]    = '克'
# 打开菜单,发现他的名字变成了艾克亲...
[/pre]

slice!(index)
slice!(index, length)
slice!(range)
slice!(regexp)
slice!(match_str)
同slice,但是会移除原字符串的对应部分。
[pre lang="ruby" line="1"]
puts actor.name.slice!(1)  #=> 里
# 打开菜单,发现他的名字已经变成了艾克...
[/pre]

chars: 返回每个字符构成的数组
[pre lang="ruby" line="1"]
p actor.name.chars #=> ["艾", "里", "克"]
# 由于编码问题,输出结果可能为 ["\u827E", "\u91CC", "\u514B"]
[/pre]

each_char {|char| ... }: 对每个字符进行迭代
[pre lang="ruby" line="1"]
actor.name.each_char {|char| puts char }
# 输出结果
艾
里
克
[/pre]

chomp、chomp!:去掉字符串结尾的换行和空格。
chomp返回去掉之后的字符串;chomp!具有破环性,如果未做修改则返回nil,否则返回原来的字符串
其实这个方法可以传入一个字符的参数,来清除末尾所有的这个字符。

clear: 清空字符串

each_line {|line| ... }: 迭代每一行

empty?: 这个字符串是否为空字符串。

start_with?([str]+) / end_with?([str]+): 字符串是否以str之一开头/结尾
[pre lang="ruby" line="1"]
puts actor.name.start_with?('艾里')           #=> true
puts actor.name.start_with?('艾', '爱', '唉') #=> true
puts actor.name.end_with?('克里')             #=> false
[/pre]

include?(str): 字符串是否包含子字符串str
[pre lang="ruby" line="1"]
puts actor.name.include?('艾里') #=> true
puts actor.name.include?('艾克') #=> false
[/pre]

intern / to_sym: 将字符串转换为符号

length / size: 获取字符串的长度

reverse / reverse!: 将字符串颠倒。其中reverse!具有破坏性
[pre lang="ruby" line="1"]
puts actor.name.reverse! #=> 克里艾
[/pre]
然后打开菜单,发现他的名字真的变成了克里艾……

to_i / to_f: 转换为整数或浮点数
[/fold]

点评

没看到未完待续么……  发表于 2014-7-5 19:36
卧槽你的教程怎么这么短,我还以为你要像RyanBern把那些常用方法都解析一下…………  发表于 2014-7-5 19:29
这种内置是库级别的内置,而不是语法级别的内置,zeroload原则有什么办法。再者不是所有的正则都符合ruby的使用方法呀= =  发表于 2014-7-5 19:27
好吧c++什么时候易用过了……  发表于 2014-7-5 19:26
c++11不是内置正则么?我记错了?正则不都和Ruby一样简单易用吗,比如屏蔽广告,文本编辑器的查找之类的  发表于 2014-7-5 19:24

评分

参与人数 1星屑 +100 梦石 +1 收起 理由
VIPArcher + 100 + 1 认可答案

查看全部评分

回复

使用道具 举报

梦石
0
星屑
9557
在线时间
5074 小时
注册时间
2013-6-21
回帖
3459

开拓者贵宾剧作品鉴家

发表于 2014-7-6 11:04:37 | 显示全部楼层
本帖最后由 RyanBern 于 2014-7-6 14:34 编辑

[fold=正则表达式的概念和其应用]
       下面说正则表达式吧。终于说到你了。
       正则表达式,名字听起来就挺高大上的,对不?似乎很难学?看不懂?别这样。学什么都系都要有信心才是。本人刚开始学的时候也这样,不过经过若干个小时的努力,已经基(sha)本(ye)理(bu)解(hui)了。不过话说回来,用好了正则表达式,无论是看脚本还是处理字符串,能力都会提升很多。这样,当别的新人看到你写的脚本时,会说“哇塞,正则表达式耶,好高端耶”,是不是很有成就感呢?(这是在zuodie)

       有关正则表达式的教程,论坛上已经有了很多,本人填这部分坑呢,80%的内容都是依照Ace 图书馆的教程来的,当然也有少部分改编。啥?抄袭可耻?我抄袭了么?(大雾)

•什么是正则表达式
       所谓正则表达式(Regular Expression,Regexp),可以将其理解为有特殊含义的字符串(String),可以作为字符串匹配的模式串(Pattern)来使用,比纯字符串有更高的灵活性。正则表达式最重要的作用就是进行模式匹配,这为Ruby大范围处理文本信息提供了方便。至于匹配的具体过程我们无需去关心,因为毕竟我们走的是面向对象的编程道路,对于那些琐碎的中间过程可以不必考虑,不过有兴趣的同学可以百度一下“模式匹配算法”、“KMP模式匹配”,但是在这里我们不去进行讨论。
•正则表达式的初始化
正则表达式属于Regexp类的对象,初始化需要调用new方法。
Regexp.new(string, [option[,lang]])
这个初始化方法一共有三个参数,第一个string描述的是正则表达式的内容,这里建议用单引号''包围的字符串,这样做的好处是单引号字符串不解析里面的其他结构,完全按照引号内部的字符内容搬到正则表达式里面去。第二个option描述的是正则表达式的选项。一共有三个常用选项。第三个lang描述的是编码规则,这个参数我们通常用不到。

下面我们说说正则表达式的选项。所谓正则表达式的选项,我们可以将它理解成正则表达式的一种自定义可选匹配规则。
i选项(Regexp::IGNORECASE):匹配的时候不区分大小写字母,即大写的A可以和小写的a匹配成功。
m选项(Regexp::MULTILINE):多行模式,使得”.”元字符能匹配换行符”\n”。
x选项(Regexp::EXTENDED):忽视正则表达式中的空白字符,相当于删去所有空白字符而后重新连接的正则表达式。
注:空白字符的定义和C语言中的定义是一样的,相当于使得isspace为1的字符。

那么我们可以写一个例子:
  1. rgx1 = Regexp.new('Abc', Regexp::IGNORECASE) # rgx1内容为'Abc',匹配的时候忽略大小写。
  2. rgx2 = Regexp.new('def.', Regexp::MULTILINE) # rgx2内容为'def.',匹配的时候,'.'可以匹配换行符。
  3. rgx3 = Regexp.new('ABC.', Regexp::MULTILINE | Regexp::IGNORECASE) # rgx3同时打开了i选项和m选项。要同时打开选项用按位或'|'符号。
复制代码
这样写固然很好,但是作为Ruby的实用类,正则表达式的地位和数组还有字符串的地位相当。既然数组和字符串都有比较简洁的初始化方式,那么正则表达式也不例外。

你早说啦喂,你要是说了我发誓永远不再用Regexp.new了。

实际上用一对双斜线”//”来初始化一个空的正则表达式,这个和数组用一对方括号”[]”初始化是一样的,也可以像字符串常量那样初始化正则表达式,如
  1. rgx1 = /abc/
  2. rgx2 = /Abc/i  # 打开i选项
  3. rgx3 = /def./im  # 打开i选项和m选项
复制代码
看起来的确方便好多啊,俺可以忘掉Regexp.new了(大雾)~

•正则表达式的内容和含义
同字符串一样,正则表达式里面几乎可以写任意的字符,但是正则表达式中的字符有很强的特殊性,当然,有些无法解析的正则表达式不能通过编译。

关键的问题是?正则表达式里面的那些东西写出来到底是啥意思?字符串我知道,里面写的就是一些字符,当然如果写的是火星文,我也看不懂。那么正则表达式呢?我们在一开始就说了,正则表达式的作用是进行模式匹配,并且充当模式串(Pattern)的作用。那么正则表达式的内容就应该是“一个字符串的(部分)模式”。啥?正则表达式是一个“模式”?好吧我承认我说不清这个了。那么就写个感性的认识,假如字符串str = "a:123",我要看看里面是不是含有类似于"[字母]:"(例如a:,b:)这样的模式(结构),那么正则表达式就可以用来描述这个模式或者结构。
•正则表达式的匹配规则
问题:既然正则表达式用于模式匹配,那么什么叫做匹配,什么叫做不匹配?

要弄清楚这个问题,首先要了解单字符匹配的概念:正则表达式中的一个字符和目标串中的一个字符成功匹配。我们把正则表达式里面的每一个字符看作一个小容器,每一个小容器都只能装某种特定的物件;而将字符串里面的每一个字符看作一个个物件,这个物件能够放到一个小容器里面,那么正则表达式的这个字符就和目标字符串中的那个字符匹配。

我们称一个正则表达式和一个字符串匹配,如果存在字符串的一个子串str,使得子串的每一个字符和正则表达式的每个字符一一地匹配。
请注意这里“一一地”的含义,这样说起来有些难懂,我们举几个例子,领会匹配的含义:
  1. regex = /abc/
  2. str1 = "aabcd"
  3. str2 = "ababd"
  4. p regex =~ str1 #=> 1 匹配成功
  5. p regex =~ str2 #=> nil 匹配不成功
复制代码
注意到了么?第一个字符串里面恰好有一个字串"abc",和正则表达式指定的格式相同,所以匹配。第二个字符串里面找不到子串"abc",没有满足正则表达式格式的子串,匹配失败。

那么在上面的例子中,我们接触到了一个新的符号,这也是正则表达式的一个方法。
regex =~ str:将正则表达式和str比对,如果匹配成功,则返回匹配位置第一位的索引,如果匹配失败,返回nil。
于是regex =~ str1的返回值是1,这恰恰因为子串"abc"中的字符"a"的索引为1。

为了更好理解正则表达式的匹配,下面阐述一下匹配的一些原则:

连续匹配:一个正则表达式只能和目标串的一个子串匹配,而不能和目标串的若干个子串连接之后得到的新串匹配。例如:
  1. p /ab/ =~ "abcd" #=> 0
  2. /ab/ =~ "acdb" #=> nil,在这里a和b分开了,不算匹配
复制代码
整体匹配:匹配必须是正则表达式的整体,而不能是正则表达式的一部分。
首次匹配:如果某正则表达式和某字符串的多个子串匹配,则认为匹配的子串是满足整体匹配的左起第一个子串。
  1. p /ab/ =~ "cabababa" # => 1 而不是3或者5
复制代码
•Regexp类
为了更好理解表达式,我们来看看Regexp类,即正则表达式的类。

类方法:
Regexp.last_match:返回最近一次正则表达式匹配的MatchData对象,这个方法等同于访问内部变量$~。
Regexp.last_match([nth]):若nth=0,则返回匹配的整个字符串$&,否则返回第nth个括号相匹配的字符串$1,$2,$3……这个方法等同于访问$&,$1,$2……
在这里,什么叫“第nth个括号相匹配的字符串”?正则表达式中可以带括号,括号将正则表达式分成了若干个部分,这里我们还没有讲到,暂时记一下,后面我们会说。

实例方法:
self =~ string:和String对象进行匹配,匹配成功匹配的所在位置,匹配失败返回nil。
self === string:和String对象进行匹配,匹配成功返回true,匹配失败返回false。
self.match(str):和str进行匹配,返回匹配的结果MatchData。
to_s:返回正则表达式的字符串形式。
•MatchData类
储存正则表达式匹配中间过程信息的类,可以通过$~获取。
实例方法:
self[nth]:返回第nth个匹配部分。
post_match:返回匹配部分之后的字符串。
pre_match:返回匹配部分之前的字符串。
to_a:返回$&,$1,$2,……的数组形式。
to_s:返回整个匹配部分。
注:调用Regexp.last_match就会返回最近一次匹配的MatchData对象,里面含有最近一次匹配的各种信息。如果匹配失败,则返回nil。这时候调用Regexp.last_match[1]会导致NameError,因为你显然不能对nil调用'[]'方法。但是调用Regexp.last_match(1)却会返回ni,这是因为这个语句等同于访问内部变量$1。体会一下这两个方法的区别就好。
•几个内部全局变量
和模式匹配有关的内部全局变量已经在Ruby中定义,可以在进行一次匹配之后使用它们。
$~:保存最近一次匹配的信息,是一个MatchData的实例,如果不存在则为nil。
$&:保存最近一次成功匹配的字符串的子串,如果匹配失败,则为nil。
$1,$2,$3……:保存最近一次成功匹配中,和第1、2、3……个括号匹配的字符串。如果没有对应括号或则匹配失败,则为nil。

•元字符及其解析
正则表达式中,字符分为元字符和普通字符。普通字符只能和它本身匹配,元字符就是有特殊含义的字符。注意元字符和字符串中的转义字符的区别。转义字符属于普通字符,而元字符是某种意义下的“通配符”。还有一些特殊的数量指定符,后面我们都要讲到。在Ruby的正则表达式中,不带反斜线的字母和数字和带反斜线的符号都是普通字符。而带反斜线的字母和数字和不带反斜线的符号一般都是元字符。这样说起来比较拗口,我们举几个例子吧。
普通字符:a,b,\n,\\
元字符:.,^,\w,\D
啥?这些都是啥意思?稍后我们就解析一下。

在F1中搜索正则表达式,我们可以看到里面列出了所有元字符的用法。这些东西没必要记住,需要的时候可以自行翻阅。不过F1里面对某些元字符描述的不是特别清楚,在这里进行如下补充。
.:匹配除换行符\n以外的任何一个字符,如果使用正则表达式选项m,则可以匹配任意字符。
^:行首,匹配输入字符串头部或者换行符\n之后的位置。
  1. p "\n".gsub(/^/,"o") #=> "o\n"
复制代码
注1:这里\n之后如果什么都不写,不算另起一行。只有形如"\nx"的字符串才算是两行,每一行的行首都满足整体匹配的条件。
注2:元字符“^”匹配的是字符串头部,即字符串每一行开始部分之前的那个地方,而不是字符串每一行的第一个字符。
注3:这里用gsub方法意在指示出整个字符串有多少个可以匹配的子串,并不和我们刚才所说的“首次匹配”相矛盾。
$:行尾,匹配输入字符串尾部或者换行符\n之前的位置。
  1. p "\n".gsub(/$/,"o") #=> "o\no"
复制代码
注:元字符“$”匹配的是字符串中换行符之前的那个位置,而不是换行符本身或者换行符之前的那个字符,另外,“$”也可匹配字符串最后面的那个位置(可以由上一个例子看出)。
\w:匹配任何数字字母字符,包括下划线,等同于[0-9a-zA-Z_]。
\W:匹配\w以外的字符。
\s:匹配任何空字符,等同于[ \n\r\t\f\\v],注意,空格" "也算空字符。
\S:匹配任何非空字符,即\s以外的字符。
\d:匹配一个数字字符,等同于[0-9]
\D:匹配\d以外的字符。
\A:匹配字符串头部,和^不同,换行对其无影响。
  1. p "\nx".gsub(/\A/,"o") #=>"o\nx"
复制代码
上面的例子中,字符x在第二行里面,但是\A没有匹配到x之前\n之后的位置,这就说明\A只能匹配字符串最前面的位置。
\Z:匹配字符串尾部,字符串以\n结束,则匹配换行符之前的位置。
  1. p "x\n".gsub(/\Z/,"o") #=>"xo\no"
复制代码
注意和$的区别,对于"x\np\n",用\Z匹配得到的是"x\npo\no",用$得到的是"xo\npo\no"。也就是说$能匹配所有\n之前的位置,而\Z只能匹配最后一个\n之前的位置。
\z:匹配字符串尾部,换行符对其无影响。
  1. p "x\np\n".gsub(/\z/,"o") #=>"x\np\no"
复制代码
也就是说\z只能匹配字符串最后面的那个位置,和\A有点相互对应的意思。
|:替换,意思就是说既可以匹配它左边的内容,也可以匹配它右边的内容。例如/foo|bar/既可以匹配"foo",也可以匹配"bar"。为了避免歧义,可以在需要的地方加上括号。

下面的一些元字符带有圆括号结构,如果你是自上而下阅读,建议先跳过这部分,等你了解了正则表达式的群组化之后再来进行这里的阅读。
(?# ):注释,括号中的任意字符将被忽略。
注1:这部分括号不算作后项引用考虑的范围之内。
  1. /(.)(?#zzr)(zzr)/ =~ "azzr"
  2. p $2 #=>"zzr"
复制代码
注2:如果括号的开头不是?#,则不把它看作注释,而是看作一个数量指定符”?”和普通字符”#”。
(?:):单一群组化,它不具备后项引用功能,不为后项引用提供服务。意思就是说这部分的结构不算做后项引用,当用后项引用查第几个括号时,这个不算。
(?=):先行(lookahead),使用先行的内部pattern指定匹配的位置,相当于做一个判断。
注1:和先行匹配的部分不会出现在比较结果里面,它的作用只是判断。判断结束之后,如果匹配,则回到先行匹配的开始处进行后面的匹配,否则认为匹配失败。用更通俗易懂的话说就是,先看看这部分是不是和先行内部的模式匹配,如果匹配,再看看是不是和正则表达式实际内容匹配。
注2:/(?=foo)bar/表示的其实是同时和foo和bar匹配的字符串(当然,怎么可能有这样的字符串),而不是"foobar"这样的连写。
(?!):否定先行(negative lookahead),使用否定的pattern指定匹配位置。
注1:和先行匹配同理,否定先行的匹配部分不会出现在比较结果里面。
注2:/(?!foo)bar/表示的是不和foo匹配并且和bar匹配的子串(显然只能为"bar"),而不是一个不和foo匹配的子串和一个和bar匹配的子串的连写。
注3:/foo(?!bar)/表示和子串"foo"匹配,但是这个子串(紧跟着的)后面的若干位不能和bar匹配,匹配的结果依然是否定先行以外的部分(即$&的值是"foo")。
(?ixm-ixm):在正则表达式中临时改变正则表达式的匹配选项ixm。
例:(?i)表示打开i选项,(?-i)表示关闭i选项。一旦改变后,就一直按照这个选项匹配,直到再次变动。
(?ixm:):在括号范围内临时改变正则表达式的匹配选项,括号外恢复正则表达式的初始选项。

•字符簇
用[]来指定字符簇,匹配的时候,字符串中的字符可以匹配出现在[]中字符的任意一个。注意,一个字符簇只能匹配一个字符,只是这个代表的字符具有选择性,因此[ab]能匹配字符a或字符b,而不是/ab/。从某种意义上来讲,字符簇也算作是一种“自定义的通配符”。
例如[abc]能匹配a,b,c中的任何一个,/[abc]xx/可以匹配"axx","bxx","cxx"。
[]中可以用^,-,来表示范围,[a-z]表示匹配a到z中任意一个,[^abc]表示匹配除了abc以外的任何一个字符,^不在开头表示其字符本身,-在头尾也表示其字符本身,另外“.”元字符在方括号中只与它本身匹配,失去“基本通配”的作用。
对字符簇内的集合允许取交、并、差。
[a-c[mp]]能和a,b,c,m,p任何一个匹配。
[a-z&&[d-f]]能和d,e,f任何一个匹配,相当于取交集。
[a-f&&[^bc]]能和a,d,e,f任何一个匹配,相当于取差集。
以上三个字符簇都是合法的。
另外不允许使用空的字符簇[]或者是只有^的字符簇[^],字符簇内的字符可以重复(例如[aaa]),能通过编译,但是没必要这样做。
•群组化与后项引用
使用正则表达式中的圆括号()可以将正则表达式群组化,以供后项引用使用。群组化有什么用?这给我们解析字符串提供了更大的方便。有时候,匹配的部分含有我们需要的信息,利用群组化就可以提取出这些信息。还有,群组化是为了给后项引用提供支持,后项引用这个东西我们一会儿就说到。
注意,即使是群组化,依然要求目标串和正则表达式完全匹配,括号的作用只是保存部分匹配结果来达到为后项引用使用的目的。这样做能为我们之后使用匹配过程中的信息提供方便。
例如:/((foo)BAR)\1\2/等同于/((foo)BAR)fooBARfoo/。
  1. /((foo)BAR)/ =~ "foo"
  2. p $1 #=> nil
复制代码
部分匹配,但是整体不匹配,返回结果是nil,$1也为nil。这就说明了群组化只是起到了分组的作用,并没有改变匹配的原则。
对应的括号必须位于后项引用的左侧,这个道理是显然的,因为只有对这部分进行匹配之后,才能确定\1引用的是什么。\1表示左起第一个左括号包围的群组,由于括号匹配具有唯一性,我们可以知道这个左括号所对应的右括号是什么(不懂的同学自行百度“括号匹配”),因此\1的值就会被完全确定。
注:内部变量$n(n是正整数)指的是在匹配成功的情况下,左起第n个左括号(及其对应的右括号)所包围的群组对应匹配的子串的值。由于括号匹配的唯一性,$n的值也可以被完全确定下来。

引入这种群组化的思想有什么用?我们看下面一个例子:
例:写出一个正则表达式,它能匹配连续两个相同字符。
解:/(.)\1/
如果没有群组化和后项引用,似乎会很困难。这也就说明,含有后项引用的正则表达式的值是动态确定的,而不是静态的,也就是说这种正则表达式的值在程序运行过程中才能被确定下来,编译的时候是无法确定其值的。
注:处于括号内的后项引用通常不起作用。
  1. p /(\1)/ =~ "x" # => nil
复制代码
因为这个时候\1所代表的还没有确定。
但是,如果包含后项引用的最外层括号的序号大于后项引用的序号,那么后项引用是有效的,这里,包含后项引用的括号起到的作用是群组化或者避免歧义。
  1. /(\w\d)(\1)1/ =~ "z1z11"
  2. p , $1, $2 # => "z1z11" "z1" "z1"
复制代码
•后项引用和八进制代码
这一部分是对F1相应部分的解读,感觉没必要抠得太深。写程序最忌讳二义性,而这里抠的恰恰就是二义性的问题。因此造出一堆没什么意义的歧义正则表达式是及其无聊的事情。不过既然提到了,就在这里说说,感觉应该可以跳过这一部分。
后项引用超过两位时,和八进制代码容易混淆。所谓八进制代码,其实是用八进制数来表示的一类特殊的(元)字符。Ruby中规定,如果有对应的括号,那么就为后项引用,无对应括号,就解释为八进制代码。
另外,在正则表达式中,如果要使用1位八进制代码,必须以0打头,如\01等。因为后项引用不可能存在类似\0的结构。
容易引起歧义时,要用括号来划分群组。
  1. /(.)(\1)1/ =~ "221" #=> 0
  2. /(.)\11/ = ~ "a\11" #=> 0,注意,这里右边字符串的'\11'是一个(八进制)字符
复制代码
•字符的数量指定(Quantifier)
用于指定子表达式出现次数的数量指定符,通常为* + ? {m} {m,n}等,它们的作用就是指定紧跟在它们前面的字符(或者字符群组)重复出现的次数。刚才我们说过,一个正则表达式的字符可能会匹配目标串的多个字符。在这里我们略去这些Quantifier的说明,F1里面已经说得很详细了。唯一要注意的问题就是大家要深入理解“尽量匹配短的”和“尽量匹配长的”这两句话的含义,如果不清楚就多试试。
下面这几个符号都十分常用,别的可以不记,这些最好记住吧:
?等同于{0,1};*等同于{0,};+等同于{1,};??等同于{0,1}?

还记得我们刚才跳过的那部分元字符吗?我们现在可以跳回去看看了。

•正则表达式在字符串中的重要应用
self[regexp]:返回与regexp首次匹配的子字符串。
例:
  1. a = "中华人民共和国成立于1949年"
  2. p a[/[0-9]+/] #=> "1949"
复制代码
slice(regexp):等同于self[regexp]。
上面两个方法完全相同,使用的时候只是返回匹配的子串,而不对原字符串做出修改。
self[regexp] = val:找到和regexp首次匹配的部分,并且用val替换之。
  1. a = "RMVX是我的最爱"
  2. a[/RMVX|RMVA/] = "RMXP"
  3. p a #=>"RMXP是我的最爱"
复制代码
scan(regexp)
scan(regexp){|matched| ...}:用regexp对字符串反复进行匹配操作,调用时可以带一个块。不带块调用时返回所有匹配字符串的数组,带块调用时返回self。另外,如果正则表达式里面有括号,那么传递给块的参数matched则变为各个括号中字符串的数组,如果不带括号,matched直接就是匹配部分的字符串。
例:
  1. s = "中华人民共和国成立于1949年10月1日"
  2. a = []
  3. s.scan(/[0-9]+/){|s| a << s.to_i}
  4. p a #=> [1949, 10, 1]
复制代码
注:scan成功进行一次匹配时,下一次匹配将从上一次匹配成功的地方进行,也就是说"aaaaa".scan(/aa/)会得到["aa","aa"],而不是["aa","aa","aa","aa"]。

sub(regex){|matched| ...}
sub!(regex){|matched| ...}
gsub(regexp){|matched| ...}
gsub!(regexp){|matched| ...}
gsub(regexp, str)
gsub!(regexp, str):根据正则表达式对一个字符串进行替换。sub系列的表示只替换一次(首位),而gsub系列的表示替换所有匹配的部分。带有叹号的为重磅方法,表示对原始数据具有破坏性,而不带叹号的则会返回一个新的替换后的字符串。
例(这是RMXP中F1的例子):
  1. p 'abcabc'.gsub(/b/) {|s| s.upcase }    # => "aBcaBc"
  2. p 'abcabc'.gsub(/b/) { .upcase }      # => "aBcaBc"
  3. p 'abbbcd'.gsub(/a(b+)/) { $1 }         # => "bbbcd"
复制代码
这里值得一提的是,块内部可以出现$&,$1这样的东西,这就为我们替换提供了极大的方便。

再说一个例子,这个例子想必大家都熟悉,我们知道在“事件——显示文章”里面输入文字,有些可以利用控制码,比方说\n[1],\v[1]等等,具体这些控制码是如何转换成我们需要的文字呢?就是利用正则表达式和gsub!方法。例如,我们要把\n[id]变成ID为id的角色名字,就应该这样:
  1. str = '你好,我的名字是\n[1],请多指教。'
  2. str.gsub!(/\\[nN]\[([0-9])+\]/){ $game_actors[$1.to_i].name}
  3. p str # => "你好,我的名字是艾里克,请多指教。"
复制代码
split(regexp):将字符串分割,分割由正则表达式指定,返回一个分割之后的各个子串构成的数组,当然,正则表达式指定的分隔符就不会出现了。这个方法很常用,通常是将信息隐含在名称或者是说明当中。不过坏处就是,如果你也用split,我也用,那么不加整合的话就会发生冲突。
例(用“特技名,num”的形式来指定某某特技的冷却回合数,那么可以用split来获取冷却回合数目。这个脚本是RMXP的,不过不影响你学习RGSS3):
  1. module RPG
  2.   class Skill
  3.     def name
  4.       return @name.split(/,/)[0]
  5.     end
  6.     def cooldown
  7.       return @name.split(/,/)[1].to_i
  8.     end
  9.   end
  10. end
复制代码
有了这些基础,再加上做一些测试,我想正则表达式应该可以入门了吧。

[/fold]

点评

↓我不是故意的(委屈)  发表于 2014-7-11 16:40
配合文本处理代码处理你这贴我一共用了8分钟, 中间除错用了3分钟  发表于 2014-7-11 11:49
大神又做到你的贴了, 统计结果是8613+1637=10250个字符, 你自己看着办吧  发表于 2014-7-11 11:44

评分

参与人数 1星屑 +200 梦石 +1 收起 理由
taroxd + 200 + 1 认可答案 extra

查看全部评分

回复

使用道具 举报

梦石
0
星屑
122
在线时间
552 小时
注册时间
2012-8-18
回帖
1392
发表于 2014-7-6 12:08:22 | 显示全部楼层
本帖最后由 无脑之人 于 2014-7-15 00:35 编辑

操作符(Operator)

可能会有一些人觉得ruby的操作符是很简单并且也很方便的东西,其实呢,这里面是有很多坑点的哦!
【当然其实不用作死的写法基本上不会被坑】

[fold=第一章 基本的操作符与操作符优先级]
  Ruby里面主要有以下几个操作符:【按照优先级由高到低的顺序】
  【注:unary代表一元操作符,binary代表二元操作符,这里面没写的都默认binary,除了?:是唯一的三元操作符(ternary operator)】
  【一元操作符代表结合一个操作数,举例来说就像是-a中的-只结合了a一个操作数,而a-b中的-结合了a,b两个操作数,他就是二元操作符,我们用unary-和binary-来区分这两个操作符——他们是截然不同的】

  1. ::(作用域操作符)
  2. [] []=(下标操作符)
  3. unary+  !(否定)  ~(按位取反操作符)
  4. **(幂操作符)
  5. unary-
  6. *  /  %(求模操作符,取余数)
  7. +  -
  8. << >>(移位操作符)
  9. &(按位与操作符)
  10. |(按位或操作符)  ^(按位异或操作符)
  11. > >=  < <=(比较操作符)
  12. <=> ==  === !=  =~  !~
  13. &&(逻辑与操作符)
  14. ||(逻辑或操作符)
  15. ..  ...(范围操作符)
  16. ?:(三目操作符)
  17. =(+=, -= ... )
  18. not
  19. and or
  20.   
复制代码
【说真的unary*和unary&的优先级我一直没找着,貌似很低】
  运算符优先级的意思是,对于一个对象,它结合运算符的方式有两种,比如:
  1. 1+a-b
复制代码
那么按照运算符优先级的顺序来结合,如果是同优先级,要看他们是左结合优先还是右结合优先,这一点不同运算符都是不同的,比如+ - * /是左结合,而**则是右结合
  如果你想知道操作符真正的顺序,就请用实践来探寻他

  然后我们说一下这里面不是很好理解的几个运算符:
  1. ::(作用域操作符)
    这里的作用域操作符一般是指用来从命名空间(namespace)里面取出常量(constant),命名空间通俗一点讲就是用Class和Module来实现的,下面的代码就创建了一个命名空间:

  1. class Namespace1

  2. end

  3. module Namespace2

  4. end
  5.    
复制代码
那么常量是什么呢,常量就是大写字母开头的那些看起来像变量的东西,其中也包括Class和Module哟!

  1. class Namespace1
  2.   Constant1 = 10
  3.   class Constant2

  4.   end
  5.   module Constant3
  6.     class Constant233
  7.       Constant9 = 9
  8.     end
  9.   end
  10. end
  11. p Namespace1::Constant1 #=>10
  12. Namespace1::Constant2.new
  13. p Namespace1::Constant3::Constant233::Constant9 #=> 9
  14.    
复制代码
我相信读者看到这里应该已经明白了吧=w=【实际上是不知道怎么说下去了】
    2.位运算的操作符
      包括~ & | ^ << >>,本来打算讲一下,结果觉得工程太大,所以还是留给讲位运算的人吧XD
    3.逻辑与,逻辑或,三目操作符
      首先来说三目操作符,?:相当于一个if构成的表达式:

  1. a ? b : c
  2. #等同于
  3. if a
  4.   b
  5. else
  6.   c
  7. end
  8.       
复制代码
是不是很好理解呢?三目操作符用好了可以减少代码量,但是用得不好也许会让整个代码难以理解
      三目操作符是短路运算,a一定会计算,如果返回b就不会计算c,就这样
      https://rpg.blue/thread-335582-1-1.html 像这个帖子的LZ就是个2B青年
      【C/C++党注意】ruby中的三目操作符仅能用做求值,不可以放在等号左边
      然后是逻辑与和逻辑或,其实说他们是短路运算怎么怎么样什么的都很麻烦,一句代码概括就是了:

  1.       a && b #=> a ? b : a
  2.       a || b #=> a ? a : b
  3.       
复制代码
这样一来,它短路运算和返回值的规则就可以鲜明的表现出来了,不是么?我相信读者都看懂了吧=w=
      【这次是每个人都注意】对于&&和||来说,虽然有优先级的顺序,但是优先级顺序(甚至是括号)代表结合顺序不代表求值顺序:

  1. a,b,c = 0,0,0
  2. 1 || (a+=1) #a+=1根本不会计算
  3. (a+=1) || (b+=1) && (c+=1) #b和c毫无影响
  4.       
复制代码
这一点不仅对于ruby,对于C/C++等大多数语言都是适用的
    4.下标操作符
      参见上面的数组
    5.<=>操作符
      这个操作符的目的呢,大概是用来用一个函数表示所有的比较的,在重载部分咱会详细讲到,请大家不要着急XD
    6.===操作符
      它一般代表“包括”的意思,可以用来判断在不在Range里面,用来判断是不是这个类的对象什么的,如果没有这些特殊定义,那么等同于==
      参见Range的相关内容
      case语句使用===进行判断
  1. (1..5) === 3 #=>true
复制代码
7.=~/!~操作符
      参见上面的正则与字符串
    8. .. ...操作符
      参见Range的相关内容
    9.=(+=, -= ...) 赋值操作符和复合赋值操作符
      这是一个重头戏233
      首先,赋值操作符都有着这样的规定,他的返回值是等号的右边【注意:与C/C++以及其他乱七八糟的可以操作符重载的基本上都不一样】
      即使是复合赋值操作符以及xxx=这样的writer也是一样——不要妄图给writer方法提供返回值,他什么作用也没有

  1.   a = b = c = 1 #=>1
  2.   a += 99 #=> 100 【怎么回事呢?FlagA】
  3.   class W
  4.     def www=(x)
  5.       return 1
  6.     end
  7.     def www
  8.       return 999
  9.     end
  10.   end
  11.   c = W.new #=> W.new这个对象
  12.   c.www = 10 #=>10 而不是 1
  13.   c.www += 100 #=>1099 【诶?FlagB】
复制代码
上面的代码生动形象的说明了这些问题,但是为什么这两个Flag是不对的呢?
      首先我们从复合赋值操作符的规则说起,所有的a @= b【@代表操作符】都等同于 a = a @ b
      如 a+=1 等同于 a = a + 1
      但是有两个例外:
  1. a &&= 1 #=> a && (a=1)
  2. a ||= 9 #=> a || (a=9)
复制代码
所以我们可以用||=来给变量赋初值
      那么,说好的返回值是等号右边呢?Bingo!复合赋值操作符的返回值是展开形式的等号右边:
  1. a += 99 #=> 100
  2. a = a + 99 #=> 199
  3. c.www += 100 #=>1099
  4. c.www= c.www + 100 #=>1099
复制代码
这就是Ruby中赋值操作符的坑点所在啊!
    然后咱举出一些操作符容易忽视的问题:
1.幂操作符是右结合
2.算数取正和取负的优先级是不同的
  1. +a**2 #=> (+a)**2
  2. -a**2 #=> -(a**2)
复制代码
3.逻辑运算符具有短路运算的性质,但按位运算符是没有的!
4.不要妄图使用a==b==c,他不仅没有意义,还是一个可以被ruby检查出来的错误【CompileError】
5.一般来讲,!开头的操作符都是其原来的操作符否定后的结果,如!=是==的否定,!~是=~的否定
6.三目操作符也是右结合的【卧槽我之前都没发现他还能出现别的结合情况】:
  1. a ? b : c ? d : e #等同于 a ? b : (c ? d : e)
复制代码
7.rescue的优先级在三目操作符和赋值操作符之间
8.and or not是&& || !的另一种写法,不过他们的优先级很低
9.if/unless/while/until修饰符在and not or优先级的后面
[/fold]

[fold=第二章 操作符重载(Operator Overload)]
【不管怎么看这一章的名字都好厉害的样子【泥垢
其实这个高端的标题想说的就是,我们可以让我们的类,也具有使用操作符的能力哦
首先,让我们回忆一下,之前某位大触讲的数组里面的使用下标操作符:

  1. class WArray
  2.   def initialize
  3.     @data = []
  4.   end
  5.   def [](index)
  6.     @data[index]
  7.   end
  8.   def []=(index, result)
  9.     @data[index] = result
  10.   end
  11. end
  12. a = WArray.new
  13. a[10] = 9
  14. p a[10] #=> 9
复制代码
嘛,实际上对于大多数操作符来说,重载的方法都是一样的,那就是

  1. #@代表操作符,args代表参数
  2. def @(args)
  3.   #...
  4. end
复制代码
然后我们或许需要讨论一下参数的问题——我们应该需要几个参数呢?
那么,实际上有这样的一个规则:
对于一元操作符,他作为方法被重载不需要参数,对于二元操作符,他的重载需要一个参数,对于三元操作符——2333,三目操作符重载不了
那么哪些可以重载,哪些不可以捏~?
对于下列这些,是可以重载的:

  1. [] []= unary+ !(这个操作符的重载,需要Ruby1.9,VA是可以的啦w) ~ ** unary- * / % + - << >> & | ^
  2. < <= > >= == =~ != !~(这两个操作符的重载同样需要Ruby1.9不过他们不推荐进行重载,!=与==的语义不保持一致的话往往会出现混乱) <=> ===
  3. unary* unary& (这两个是什么东西捏?我们下一章就谈)
复制代码
然后是几个需要注意的点:
1.对于unary+和unary-难道我们要
  1. def unary+
  2. end
复制代码
?当然不是!Ruby对一元+一元-的重载进行了特殊规定,使用+@和-@:
  1. def +@
  2. end
复制代码
2.对于下标操作符来说,可能我们会认为他只能接受一个下标【在C/C++里面就是这样】,但是Ruby中,他们的下标个数是不定的哦~

  1. class WArray
  2. def [](a,b,c,d,e,f,g,h)
  3.   p a,b,c,d,e,f,g,h
  4. end
  5. def []=(a,b,c,d,e,f,g)
  6.   p a,b,c,d,e,f,g
  7. end
  8. end
  9. a = WArray.new
  10. a[1,2,3,4,5,6,7,8] #=> 1,2,3,4,5,6,7,8
  11. a[1,2,3,4,5,6] = 7 #=> 1,2,3,4,5,6,7 对于下标输入,等号后面的值一定作为最后一个参数
  12. class MArray
  13. def [](*m)
  14. p m
  15. end
  16. def []=(*m, s)
  17. p m,s
  18. end
  19. end
  20. a = MArray.new
  21. a[1,2,3,4,5] #=> [1,2,3,4,5]
  22. a[1,5,6] #=> [1,5,6]
  23. a[9,9,9,9] = 100 #=> [9,9,9,9], 100
  24. 对于Ruby1.9以前的比如说XP党,由于不支持*m,s这种语法,我们可以妥协一下:
  25. class XPArray
  26. def []=(*m)
  27. s = m.pop
  28. p m,s
  29. end
  30. end
  31. a = XPArray.new
  32. a[1,2,3,4,5,6] = 7 #=>[1,2,3,4,5,6], 7
复制代码
3.对于unary*和unary&
  Yohoho~这是下一章的内容啦,所以敬请期待咯~☆
[/fold]

[fold=第三章 神奇的unary*与unary&]
  Hi~大家好~☆很可能这是我最后一篇教程啦,暑假里面出了很多事情,所以还希望读者大人不要丢鸡蛋……啊呀
  这次讲的是两个神奇的一元操作符——*和&
  现讲&好了,工程比较小:
  unary&的用途是与块紧密相关的,比如说在传递参数的时候,我们可以用&block来接受参数,但这与这个操作符有什么关系呢?
  首先我们来看下面的代码:

  1.   def mmm(&block)
  2.     block.call(100)
  3.   end
  4.   mmm {|val| p val} #=> 100
  5.   
复制代码
从上面的代码可以看出,在这里&是将递交给方法的块进行了捕获。
  紧接着我们再看这样的代码:

  1.   def mmm(&block)
  2.     block.call(1,2)
  3.   end
  4.   def plus(a,b)
  5.     a + b
  6.   end
  7.   pro = proc {|m,n| m + n}
  8.   mmm &:plus #=> 3
  9.   mmm &pro #=> 3
  10.   
复制代码
从这段代码可以看出,我们似乎能用&将一个方法(用Symbol表示)或者一个过程(Proc)转化为块
  我相信我这么说肯定不是很好理解,下面才是重头戏:
  【声明:以下均为层主自己脑补的,如果有失误还请指正】
  在Ruby中,对于这种无论是叫函数,还是叫过程,还是叫块,他们都是这样的两种形式——块和对象
  块,是在方法中挂上的,{-}或者do-end那种东西,他们不是对象,不能拿正常的ruby操作去操作他们
  而我们可以将块转化为对象,这样他就符合Ruby中对象的各种要求,也就可以拿来进行操作了
  因此,我们需要一个媒介,将块和对象之间转化——也就是&
  我们对一个对象调用&,将会得到一个块,我们在方法的参数列表中用&,就可以把块捕获成对象
  当然Ruby为我们内置了proc和lambda方法,可以方便的将块转化为对象
  Ruby的中的方法对象,同样也是这种对象的一员
  那么,我们为什么可以&:plus呢?难道Symbol也是这种对象么?不
  Symbol,他重载了unary&,在这个重载操作符方法内,他将自己转化为了相应的方法对象,这样&就可以将它转化
  我们也可以用同样的方法,重载unary&操作符(他的重载方法是to_proc):

  1.   class A
  2.     def to_proc
  3.       proc {|i,j| i + j}
  4.     end
  5.   end
  6.   a = A.new
  7.   def mmm
  8.     yield 1,2
  9.   end
  10.   mmm &a
  11.   
复制代码
好了,unary&到此结束【我是不是一不小心领了block参数那一节 @taroxd
  
  紧接着是unary*,他的用途更加广泛而灵活
  *是伴随着数组而出现的,我们同样可以在参数列表中看见他
  1. def a(*b)
  2. p b
  3. end
复制代码
也可以在并行赋值【好像还没讲,我如果有机会会开了这个坑】中看见他
  1. a,b,*c = 1,2,3,4,5,6
  2. p c #=> [3,4,5,6]
复制代码
那么,她是怎样的呢?【高能脑补注意!】
  实际上,他和unary&一样,也具有两种形式——展开式和数组
  展开式就是像a,b,c,d这样用逗号分隔的表达式

  1.   a = [1,2,3,4]
  2.   p(*a) #=> 1 2 3 4
  3.   p(1,2,3,4) #=> 1 2 3 4
  4.   #别忘了p是一个方法调用
  5.   *m = 1,2,3,4
  6.   a,b,c,d = 1,2,3,4
  7.   p(*m) #=> 1 2 3 4
  8.   p m #=> [1,2,3,4]
  9.   p a,b,c,d #=> 1 2 3 4
  10.   n = []
  11.   n[0],n[1],n[2],n[3] = 1,2,3,4
  12.   p n #=> [1,2,3,4]
  13.   def aaa(*m)
  14.     p m
  15.   end
  16.   aaa(1,2,3,4) #=> [1,2,3,4]
  17.   def ccc
  18.     yield 1,2,3,4
  19.   end
  20.   ccc {|*c| p c } #=> [1,2,3,4]
  21.   
复制代码
*同样也是展开式与数组之间的媒介,相信读者大人看懂了吧?【是因为快要去学校了懒得解释了
  对于不是数组的对象,默认是返回本身
  1. *1 #=> 1
复制代码
我们可以重载它,用to_a:

  1. class M
  2.   def to_a
  3.     [1,2,3,4]
  4.   end
  5. end
  6. m = M.new
  7. p(*m) #=> 1 2 3 4
  8.   
复制代码
不过,对于Ruby的某一些版本【记不起来是哪些了】,禁止了数组展开与其他展开式连接:

  1.   m = 1,2,3,4
  2.   p(*m) #=> 1 2 3 4
  3.   p(5,6,7,8) #=> 5 6 7 8
  4.   p(*m,5,6,7,8) #=>1 2 3 4 5 6 7 8 #某些版本不允许
  5.   
复制代码
好了就到这里了,还剩一章,关于操作符的小实践
[/fold]

以下内容不看也罢
[fold=最终章 操作符的应用]
以上讲了操作符的各种使用方法,现在我们就来将理论付诸于实际
1.用于将自制的数字类模仿原Numeric的使用
在这里作为示范,我们写一个虚数类【不知道虚数是啥的可以查查wiki,不过更建议先好好学习,嗯我又开地图炮了】
[pre lang="ruby" line="1"]module NOB
  class Complex
    def initialize(a=0,b=0) #此处不理解见咱的参数教程
      @real = a
      @virtual = b
    end
    attr_accessor :real, :virtual #此处不理解详见taroxd触的属性教程
    def conjugate #共轭复数
      Complex.new(@real, -@virtual)
    end
    def size #模
      Math.hypot(@real, @virtual)
    end
    def square
      @real ** 2 + @virtual ** 2
    end
    def to_s
      ((@real != 0) ? @real.to_s : "") + ((@real != 0 && @virtual != 0) ? "+" : "") +
      ((@virtual != 0) ? @virtual.to_s + "i" : "")
    end
    alias inspect to_s #这句和上一个无视就好
  end
end[/pre]
最基本的骨架就是这样了喵【我会在注释中说明为什么不继承Numeric类】
这个时候,他作为一个像Numeric的类,应该具有基本的操作符支持——最起码复数也要可以运算呐OAO
我们先来想一想都要怎么运算
圈1:我们要有加减法!既然我们要兼容各种各样的数值类型【整数,浮点数,以及刚做的复数】,那么我们需要对传来的参数的类型进行判断
[pre lang="ruby" line="1"]module NOB
  class Complex
    def initialize(a=0,b=0)
      @real = a
      @virtual = b
    end
    attr_accessor :real, :virtual
    def conjugate
      Complex.new(@real, -@virtual)
    end
    def size #模
      Math.hypot(@real, @virtual)
    end
    def square
      @real ** 2 + @virtual ** 2
    end
    def to_s
      ((@real != 0) ? @real.to_s : "") + ((@real != 0 && @virtual != 0) ? "+" : "") +
      ((@virtual != 0) ? @virtual.to_s + "i" : "")
    end
    alias inspect to_s
    def +(other)
      case other
      when Numeric
        Complex.new(@real + other, @virtual)
      when Complex
        Complex.new(@real + other.real, @virtual + other.virtual)
      else
        raise TypeError,"Invalid argument (#{} to Numeric,Complex)" #这句无视就好
      end
    end
    def -(other)
      self + (-other) #总是满足这样的效果
    end
  end
end[/pre]
圈2:你看上面的代码能运行吗?不能!因为什么?我们需要unary+和unary-啊!自己取负当然是需要支持的咯
[pre lang="ruby" line="1"]module NOB
  class Complex
    def initialize(a=0,b=0) #此处不理解见咱的参数教程
      @real = a
      @virtual = b
    end
    attr_accessor :real, :virtual #此处不理解详见taroxd触的属性教程
    def conjugate #共轭复数
      Complex.new(@real, -@virtual)
    end
    def size #模
      Math.hypot(@real, @virtual)
    end
    def square
      @real ** 2 + @virtual ** 2
    end
    def to_s
      ((@real != 0) ? @real.to_s : "") + ((@real != 0 && @virtual != 0) ? "+" : "") +
      ((@virtual != 0) ? @virtual.to_s + "i" : "")
    end
    alias inspect to_s
    def +(other)
      case other
      when Numeric
        Complex.new(@real + other, @virtual)
      when Complex
        Complex.new(@real + other.real, @virtual + other.virtual)
      else
        raise TypeError,"Invalid argument (#{} to Numeric,Complex)"
      end
    end
    def -(other)
      self + (-other) #总是满足这样的效果
    end
    def +@
      self
      #这里也可以选择 Complex.new(@real, @virtual),这样更加符合语义
      #不过我懒得这样做
    end
    def -@
      Complex.new(-@real, -@virtual)
    end
  end
end[/pre]
圈3:我们该增加乘除法了!为了避免整数除法为我们带来的坑点,我们统一进行浮点除法
[pre lang="ruby" line="1"]module NOB
  class Complex
    def initialize(a=0,b=0) #此处不理解见咱的参数教程
      @real = a
      @virtual = b
    end
    attr_accessor :real, :virtual #此处不理解详见taroxd触的属性教程
    def conjugate #共轭复数
      Complex.new(@real, -@virtual)
    end
    def size #模
      Math.hypot(@real, @virtual)
    end
    def square
      @real ** 2 + @virtual ** 2
    end
    def to_s
      ((@real != 0) ? @real.to_s : "") + ((@real != 0 && @virtual != 0) ? "+" : "") +
      ((@virtual != 0) ? @virtual.to_s + "i" : "")
    end
    alias inspect to_s
    def +(other)
      case other
      when Numeric
        Complex.new(@real + other, @virtual)
      when Complex
        Complex.new(@real + other.real, @virtual + other.virtual)
      else
        raise TypeError,"Invalid argument (#{} to Numeric,Complex)"
      end
    end
    def -(other)
      self + (-other) #总是满足这样的效果
    end
    def +@
      self
      #这里也可以选择 Complex.new(@real, @virtual),这样更加符合语义
      #不过我懒得这样做
    end
    def -@
      Complex.new(-@real, -@virtual)
    end
    def *(other)
      case other
      when Numeric
        Complex.new(@real * other, @virtual * other)
      when Complex
        Complex.new(@real * other.real - @virtual * other.virtual,
        @real * other.virtual + @virtual * other.real)
      else
        raise TypeError,"Invalid argument (#{} to Numeric,Complex)"
      end
    end
    def /(other)
      self * other.conjugate / other.square
      #分母实数化,我也懒得用什么高端算法了……【其实是不会用吧
    end
  end
end[/pre]
圈4:这个概括所有需要填的了……卧槽累死我了……不管了就当有这些操作符
圈5:我们需要影响整数类和浮点类的+-*/以便于支持Complex【以Float的+为例,真是累残了不想打了……
[pre lang="ruby" line="1"]class Float
  alias :plus :+
  def +(other)
    case other
    when NOB::Complex
      other + self
    else
      plus(other)
    end
  end
end[/pre]
总之呢,完成这样一个数学上的类,对操作符要熟练掌握哦
2.对于容器和(伪)输入输出流
其实是模仿C++,小朋友们不要学我:
假设我们写了一个红黑树【真是丧心病狂
[pre lang="ruby" line="1"]class RBT
  def initialize
    #红黑树你去死吧我艹你大爷%¥%&%@#¥%¥#%*&%……
  end
  def xxx
    #各种实现
  end
  def push(item)
    #添加一个元素
  end
end[/pre]
然后这个时候我们可以模仿Array类的<<方法:
[pre lang="ruby" line="1"]class RBT
  def initialize
    #红黑树你去死吧我艹你大爷%¥%&%@#¥%¥#%*&%……
  end
  def xxx
    #各种实现
  end
  def push(item)
    #添加一个元素
  end
  alias :<< :push
end[/pre]
这样我们就可以[pre lang="ruby" line="1"]a = RBT.new
a << 1
a << 999[/pre]
然后是伪输入输出流
[pre lang="ruby" line="1"]class RubyOut
  class HelperProc
    def initialize(&block)
      @BLock = block
    end
    def call(rubyout)
      @block.call(rubyout)
    end
  end
  HEX = HelperProc.new {|out| %w{我懒得做了...} }
  def initialize
    #我们需要做什么吗?好像不需要
  end
  def <<(item)
    print(item)
  end
end[/pre]
我们同样可以模拟一下这个cout嗯……卧槽谁打我
3.新操作符的hack
听说C++有++运算符,Ruby没有
但是呢,今天我们就来看看,Ruby的++运算符!
【当然不要抱太大希望,这个伪++运算符真的是太水了
我们只能hack前置++运算符,使用的是unary+哦~
不过很抱歉不可能应用于Numeric了——他们修改不了自己
我们做一个Numeric的wrapper好了:
[pre lang="ruby" line="1"]class NumWrapper
  def initialize(num = 0)
    @num = num
    @Flag = 0
  end
  def +@()
    if @flag == 1
      @num += 1
      @flag = 0
    else
      @flag = 1      
    end
    self
  end
  def -@()
    if @flag == 2
      @num -= 1
      @flag = 0
    else
      @flag = 2
    end
    self
  end
  def method_missing(sym, *args)
    if @flag == 2
      @flag = 0
      (-@num).send(sym,*args)
    else
      @flag = 0
      @num.send(sym,*args)
    end
  end
  def to_i
    a = @flag == 2 ? -@num : @num
    @flag = 0
    a
  end
  def to_s
    to_i.to_s
  end
  alias :inspect :to_s
  #还有很多需要做的……哎呀懒得做了啦
end[/pre]
即便是这样一个小小的hack,还是非常麻烦,并且还有很多应该地方因为没有拆包无法代替Numeric
[/fold]

结语:操作符是一个有趣的东西,善于利用会让你的代码更加可读更加有效,使用不当则会令你永生难忘【笑
希望读者合理利用操作符,让自己的代码发光出彩

点评

今日发现一个BUG,(1-i).to_s # => "1+-1i",看起来很诡异  发表于 2015-4-11 18:40
从未打算做过位运算  发表于 2014-7-16 11:15
大触位运算还是你来做吧,Ruby的整数符号而且存储方式略显奇怪,我脑子转不过来了【【【  发表于 2014-7-16 10:07
ruby内置大数,所以C里面那些hack就没有用了,另外位运算什么的,真心是迈入编程的一道门槛【【【就算我要讲他,也先等我把那些好讲的都讲了先....  发表于 2014-7-11 10:22
位运算什么的,百度百科就好了。除了判断通行度之外几乎用不到  发表于 2014-7-10 19:53

评分

参与人数 2星屑 +66 梦石 +1 收起 理由
RyanBern + 66 精品文章
taroxd + 1 短消息

查看全部评分

我要填坑!我要背单词!我要学日语!我要每天锻炼!
好吧呵呵= =
回复

使用道具 举报

…あたしは天

梦石
0
星屑
2308
在线时间
4033 小时
注册时间
2010-10-4
回帖
10548

开拓者贵宾

 楼主| 发表于 2014-7-7 15:47:05 | 显示全部楼层
本帖最后由 taroxd 于 2014-7-7 19:21 编辑

[fold=区块]
今天咱就来讲一讲这Ruby的重要特色——区块(block)。
我们已经学过了最基本的循环结构:while、until、for。
但我们全局搜索默认脚本,发现其中一次都没有用到 for。用while、until的也并不多见。
难道偌大一个脚本只需要这么点循环吗?

是的。真的只需要这么点循环。因为我们有区块。

我们先看一段代码:
[pre lang="ruby" line="1"]
# %w() 表示单词构成的数组,这和 ['艾里克', '娜塔丽', '泰伦斯', '阿奈思特'] 等价
# 小小的语法糖而已,不掌握无妨,但最好看得懂
names = %w(艾里克 娜塔丽 泰伦斯 阿奈思特)
# 循环
for i in 0...names.size
  puts names
end
[/pre]

如果你学过其他什么语言,要迭代一个数组,你会觉得这是再自然不过的循环方式了,对吗?
不,我们还有更自然的方式。
[pre lang="ruby" line="1"]
%w(艾里克 娜塔丽 泰伦斯 阿奈思特).each {|name| puts name }
[/pre]

根据注释,我们知道:%w(艾里克 娜塔丽 泰伦斯 阿奈思特) 是一个数组。
根据之前的学习,我们不难想象:each 是一个方法。
那 {|name| puts name } 这是什么东西呢?
没错,这就是今天的主题:区块

我相信你一定猜出来了,name 表示数组里的每一个元素,然后 puts name 就把每个元素都输出了一遍。
没错就是这样,这节课上完了(你妹!)

咳咳,我们还是来认真的看一看吧。
{|name| puts name }
我们把这个区块传递给了方法 each。
被两条竖线框起来的这个name,我们叫做区块的参数
数组的 each 方法,会将数组的每一个元素都作为区块的参数传给这个区块,执行一次这个区块的内容。
这里区块的参数,就和方法的参数十分相似。而区块的内容,也就像一个小型的方法一样。

区块的开始和结尾可以用 {} 表示,也可以用 do...end 表示。上面的例子也可以写成这样:
[pre lang="ruby" line="1"]
%w(艾里克 娜塔丽 泰伦斯 阿奈思特).each do |name|
  puts name
end
[/pre]
一般来说,当区块只有一行时,我们更喜欢使用 {},而区块有多行时,我们则偏爱 do...end
这样做的原因,只是因为美观而已。

在方法中,我们可以用 yield 关键字来执行当前方法的区块。yield 的参数会被传递给区块。当没有区块时会报错。
使用 block_given? 可以判断方法有没有区块。
[pre lang="ruby" line="1"]
def test_block
  return unless block_given? # 没有区块时,方法直接跳出,不执行下面的内容
  yield
  yield 1
  yield 1, 2
end

test_block {|n| p n }
[/pre]
输出结果:

  1. nil
  2. 1
  3. 1
复制代码
我们可以看到,当区块没有接收到 yield 的参数时,对应的参数会被设为 nil。当 yield 传入了多余的参数时,多余的部分会被舍弃。
这是区块的参数和方法参数的一个不同之处。

接下来,我们来一个实际一些的例子。我们来定义一个方法,来对每一个已经初始化的角色进行迭代。作为预习,请先打开脚本编辑器,看一下默认的 Game_Actors 类。

...
...

就两个方法,看完了吧……什么,看不懂?那就请你去复习一下前面对 $game_variables 的讲解吧。
这里只是简单的解释。
[pre lang="ruby" line="1"]
class Game_Actors
  def initialize
    @data = []  # 将 @data 初始化为一个数组
  end

  def [](actor_id)  # 索引
    return nil unless $data_actors[actor_id] # 如果超过了数据库上限,返回 nil
    # 如果 @data[actor] 存在,那么直接返回它
    # 否则,将 @data[actor] 赋值为 Game_Actor.new(actor.id) ,并且返回它。
    # a ||= b 可以近似地等价为 a = a || b,这里不做深入的研究。
    @data[actor_id] ||= Game_Actor.new(actor_id)
  end
end
[/pre]

然后,我们要迭代每位角色,自然要从 data 下手。
但是,注意到 @data 中,并不是每一个元素都已经被初始化。
因此,我们可以这么做。
[pre lang="ruby" line="1"]
class Game_Actors
  # 还记得模块和 include 吗?
  # Enumerable 模块定义了很多好玩的方法,你可以去参考Ruby文档。
  include Enumerable
  # 迭代每位角色
  def each
    # 下面这一行并不重要,可以无视。我们暂且不考虑没有区块的情况。
    # return to_enum(__method__) unless block_given?
    @data.each {|actor| yield actor if actor } # 如果角色没有初始化,则跳过
    self        # 迭代器不需要返回值时,往往返回self。请遵守这一惯例。
  end
end
[/pre]

还记得吗?ruby 方法的返回值是最后一条表达式的返回值。
不记得就算了,用多了自然就记住了。

然后我们又可以召唤我们的事件脚本了!
[pre lang="ruby" line="1"]
$game_actors.each {|actor| actor.hp += 1 }
[/pre]
怎么样,看懂了吗?
当前每一位角色(无论是否在队伍里)的 HP 都增加 1。是不是非常简单?

最后,Ruby 不只是数组有 each,范围(区间、range)也有 each、哈希也有 each,还有各种各样的迭代器等待你的玩耍。
a.upto(b) {|i| ... }
从整数 a 到整数 b 迭代,相当于 (a..b).each {|i| ... }
a.downto(b) {|i| ... }
字面意思,不用我解释了吧?只要 a 是个不比 b 小的整数就可以了。
n.times {|i| ... }
执行区块 n 次。其中传入区块的参数分别为 0, 1, 2, ..., n - 1
from.step(to, step) {|i| ... }
步进。例子:
[pre lang="ruby" line="1"]
1.step(10, 2) {|i| p i }
[/pre]
输出:

  1. 1
  2. 3
  3. 5
  4. 7
  5. 9
复制代码
这里 from,to,step 并不一定要是整数。
更多方法,详见数组、hash的介绍,以及 ruby 文档中的方法,特别是 Enumerable 模块。
[/fold]

评分

参与人数 1星屑 +100 梦石 +1 收起 理由
VIPArcher + 100 + 1 好认真....

查看全部评分

回复

使用道具 举报

…あたしは天

梦石
0
星屑
2308
在线时间
4033 小时
注册时间
2010-10-4
回帖
10548

开拓者贵宾

 楼主| 发表于 2014-7-7 18:04:34 | 显示全部楼层
本帖最后由 taroxd 于 2014-7-7 20:19 编辑

[fold=区块中变量的作用域]

这是一个简单的不能再简单的问题:求 1..100 之间所有偶数的和。
让我们来看下面几种做法。

[pre lang="ruby" line="1"]
sum = 0
i   = 0
while i < 100
  i   += 2
  sum += i
end

p sum #=> 2550
[/pre]

[pre lang="ruby" line="1"]
sum = 0
for i in 1..100 / 2
  sum += i * 2
end

p sum #=> 2550
[/pre]

[pre lang="ruby" line="1"]
sum = 0
2.step(100, 2) {|i| sum += i }

p sum #=> 2550
[/pre]

那么,问题来了。当计算出 sum 之后,i 的值是多少呢?

第一段代码,嗯,根据咱缜密的推理,应该是 100 没错。
第二段代码,嗯,根据咱缜密的推理,应该是 50  没错。
第三段代码,嗯,根据咱缜密的推理,应该是 100 没错。不对,按照层主这尿性应该不可能和上面的一样。

.
..
...

Bingo! 在第三段代码中,变量 i 已经不存在了!
但是,奇迹般地,变量 sum 竟然还在!而且就是我们要求的那个值!我们没有多想里面的原因,Ruby 就自动帮我们做到了我们需要的结果。

总之,我们可以得出区块里局部变量的两个规则:
1. 本来就在的,带区块的方法执行完了依旧还在。
2. 本来没有的,带区块的方法执行完了也依旧没有。


再来一段:
[pre lang="ruby" line="1"]
sum = i = 0
2.step(100, 2) {|i| sum += i }

p sum #=> 2550
[/pre]

你猜 i 最后变成了几?

答案是 0 !于是我们得出了规则3:区块的参数不影响外面的变量。

这样的话,在区块里的新变量(包括参数)就很安全,不用担心与外面的变量名冲突。这是推荐使用 each 而不是用 for 的重要原因。
有了规则3,我们就可以大胆的用 i 这种简单的变量名作为区块的参数,而根本不用担心潜在的命名冲突,比如覆盖了之前用到的局部变量 i 之类的。当然,像 actor 这样有意义的名字是最好的。

最后做一个简(wu)单(liao)的实验来收尾吧:
[pre lang="ruby" line="1"]
sum = j = 0
1.upto(50) do |i|
  j = 2 * i
  sum += j
end

p sum #=> 2550
[/pre]

最后 j 是几?(答案:100)

课外拓展:
1.
[pre lang="ruby" line="1"]
sum = j = 0
1.upto(50) do |i; j|
  j = 2 * i
  sum += j
end

p sum #=> 2550
[/pre]
请自行感受 j 的真谛。

2.
[pre lang="ruby" line="1"]
p (1..50).inject(0) {|a, e| a + e * 2 } #=> 2550
[/pre]
借助 Ruby 的文档来理解这句代码,你会感到世界如此美妙。
[/fold]

点评

才不是我觉得讲inject太累呢!  发表于 2014-7-8 06:22
不然怎么叫课外拓展呢233  发表于 2014-7-8 06:21
你也学会让读者自己实践了吗23333333333333333333333333333333333333333  发表于 2014-7-7 22:53
反正目录上打着星号的无所谓啦~(逃  发表于 2014-7-7 19:02
还有define_method啥的  发表于 2014-7-7 19:02

评分

参与人数 1星屑 +100 梦石 +1 收起 理由
VIPArcher + 100 + 1 认可答案

查看全部评分

回复

使用道具 举报

梦石
0
星屑
76
在线时间
1379 小时
注册时间
2012-7-5
回帖
1643

开拓者

发表于 2014-7-7 18:54:06 | 显示全部楼层
本帖最后由 kuerlulu 于 2014-7-7 18:56 编辑

{...}和do...end有什么区别?
[fold]如果你已经阅读过帖子上面的内容, 肯定知道 {...} do...end 都表示块,
那么什么是迭代器在下也不用多讲了【这货偷懒
简单地说一个带块的方法, 比如each, 就是迭代器, 而我们使用它时经常这么写↓
  1. array.each{|item| do something }
复制代码
也可以这么写:
  1. array.each do |item|
  2.   do something
  3. end
复制代码
一般情况下, 当do something只有一行时, 使用 {...} 看起来会更简洁, 多行时用 do...end 会更美观
但这并不标明do...end与{...}完全等效
{...}的结合力大于do...end
怎么理解呢, 为了不废话我还是直接用脚本说明↓
  1. def a(x,y)
  2.   msgbox "向a传递了#{yield}" if block_given?
  3. end
  4. def c
  5.   msgbox "向c传递了#{yield}" if block_given?
  6. end
  7. def b
  8.   return "hhh"
  9. end

  10. a b,c do
  11.   "do_end块"
  12. end

  13. a b,c { "{_}块" }
复制代码
得到的结果是:
  1. 向a传递了do_end块
  2. 向c传递了{_}块
复制代码
{...}的结合力大于do...end 是不是好理解了呢【这货完全不知道怎么说了[/fold]

如果这时候连如何将块传递给方法都不知道的话, 建议翻到上面看 taroxd 的[区块]部分

点评

我只有各种eval,参数好多行,括号好多层,define_method、attr、p、puts、print、include、return、yield、next、break、defined?、没参数之类的时候才会不打括号...  发表于 2014-7-7 19:08
你们一群无括号党还好意思提这件事  发表于 2014-7-7 19:04
对了,我们是不是没有讲过参数的括号是可以省略的……  发表于 2014-7-7 19:03

评分

参与人数 1梦石 +1 收起 理由
taroxd + 1 那啥,我区块算是讲清楚了么…….

查看全部评分


  -fk: -azogi:
回复

使用道具 举报

…あたしは天

梦石
0
星屑
2308
在线时间
4033 小时
注册时间
2010-10-4
回帖
10548

开拓者贵宾

 楼主| 发表于 2014-7-13 10:58:04 | 显示全部楼层
本帖最后由 taroxd 于 2014-7-13 11:43 编辑

[fold=范围(range)]
range是一个表示范围、区间的很方便的东西。可以简单的用操作符..和...来生成。
..表示包括区间的结尾,而...表示不包括。也就是说 'A'..'D' 表示 'A', 'B', 'C', 'D',而 1...5 表示 1、2、3、4

我们可以用 each 来迭代一个范围。同时,Range 类混入了模块 Enumerable。也就是说,前面数组类的方法有许多(不是全部)在范围中也可以使用。
范围可以用小数,只是这样的话就不能迭代,只能判定大小了。
下面一段代码介绍了范围的常见使用方式。不需要文字说明应该就能理解。

[pre lang="ruby" line="1"]
(1...4).to_a                    #=> [1, 2, 3]
(1..10).select(&:even?)         #=> [2, 4, 6, 8, 10]
(Math::E..Math::PI).include?(3) #=> true (e ≤ 3 ≤ π)
[/pre]

在前面数组和字符串中,我们已经介绍了用范围来索引。
[pre lang="ruby" line="1"]
a = [12, 34, 56, 78, 90]
a[1..3]   #=> [34, 56, 78]
a[1..-2]  #=> [34, 56, 78]

s = "This is a string."
s[-7..-2] #=> "string"
[/pre]

Range 定义了 === 方法,和 include? 方法一样。因此我们可以方便地把 range 用在 case 语句中。
[pre lang="ruby" line="1"]
score = 50 + rand(51) # 50 到 100 的随机数,在较新版本的 ruby 中可以通过 rand(50..100) 来实现
result =              # case 语句是表达式,因此可以利用表达式的返回值
case score
when  0...60 then "failed"
when 60...80 then "not bad"
when 80...90 then "good"
else "excellent"
end
puts result
[/pre]

事实上,范围不只可以用于整数和字符串。对于任意的对象,只要定义了 <=> 就可以生成 range。
如果 range 要当做数列这种东西来使用的话,你还需要定义 succ 方法。
[pre lang="ruby" line="1"]
class Xs                # 表示很多的x构成的字符串
  include Comparable
  attr_reader :length
  def initialize(n)
    @length = n
  end
  def succ
    Xs.new(@length + 1)
  end
  def <=>(other)
    @length <=> other.length
  end
  def to_s                 # 转化为字符串
    'x' * @length
  end
  # 别名。
  alias inspect to_s
  alias to_str  to_s
end

r = Xs.new(3)..Xs.new(6)   #=> xxx..xxxxxx
r.to_a                     #=> [xxx, xxxx, xxxxx, xxxxxx]
r.include?(Xs.new(5))      #=> true
[/pre]

[/fold]

点评

范围能有多少……  发表于 2014-7-13 14:13
好少啊囧  发表于 2014-7-13 13:57
……不说了吧…… 那个我一次都没用过的说-。- 准确的说是用过然后觉得不是很好用  发表于 2014-7-13 12:35
OAO 你不说范围条件表达式么,虽然那个好坑来着  发表于 2014-7-13 12:25

评分

参与人数 1梦石 +1 收起 理由
VIPArcher + 1 认可答案

查看全部评分

回复

使用道具 举报

您需要登录后才可以回帖 登录 | 注册会员

本版积分规则

Powered by Discuz! X5.0 © 2001-2026 Discuz! Team.

在本版发帖返回顶部