查看: 3781|回复: 8

[已经解决] RMXP读取txt中的中文

[复制链接]
梦石
0
星屑
170
在线时间
25 小时
注册时间
2016-6-18
回帖
47
发表于 2017-7-19 16:21:09 | 显示全部楼层 |阅读模式

加入我们,或者,欢迎回来。

您需要 登录 才可以下载或查看,没有账号?注册会员

×
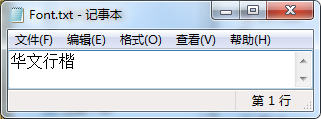
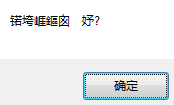
举个例子,在游戏根目录下有个Font.txt,玩家可以在里面写下一个字体名称(中文),然后用a=load_data(Font.txt)就会发生TypeError
所以请问如何用RMXP读取txt中的中文?
梦石
0
星屑
170
在线时间
25 小时
注册时间
2016-6-18
回帖
47
 楼主| 发表于 2017-7-19 16:23:51 | 显示全部楼层
补充一句,读取RMXP存储的包含中文的txt文件就不会出错,但如果在原来基础上保留txt前面那段乱码,后面写上其它中文,再读取还是会出错
回复

使用道具 举报

梦石
0
星屑
19426
在线时间
3082 小时
注册时间
2013-1-11
回帖
1207
发表于 2017-7-19 17:08:18 | 显示全部楼层
插入到main之前

[pre lang="ruby"]class String
  CP_ACP = 0
  CP_UTF8 = 65001
  def gb2312_to_utf8
    m2w = Win32API.new('kernel32', 'MultiByteToWideChar', 'ilpipi', 'i')
    w2m = Win32API.new('kernel32', 'WideCharToMultiByte', 'ilpipipp', 'i')
    n = self.size
    i = m2w.call(CP_ACP, 0, self, n+1, nil, 0)
    buffer = "\0" * (i*2)
    m2w.call(CP_ACP, 0, self, n+1, buffer, i)
    i = w2m.call(CP_UTF8, 0, buffer, -1, nil, 0, nil, nil)
    result = "\0" * i
    w2m.call(CP_UTF8, 0, buffer, -1, result, i, nil, nil)
    result.chop!
    return result
  end
end[/pre]

在事件里写上
[pre lang="ruby"]File.open("a.txt","r") do |f|

s = ""
while line = f.gets
s += line
end

print s.gb2312_to_utf8

end[/pre]

评分

参与人数 1星屑 +200 收起 理由
RyanBern + 200 塞糖

查看全部评分

回复

使用道具 举报

梦石
0
星屑
170
在线时间
25 小时
注册时间
2016-6-18
回帖
47
 楼主| 发表于 2017-7-19 19:44:44 | 显示全部楼层
张咚咚 发表于 2017-7-19 17:08
插入到main之前

class String

读取出来编码还是不对?
QQ截图20170719194138.png
QQ截图20170719194203.png

点评

把第一段编码转换的脚本放进main前面去了吗,gb2312_to_utf8  发表于 2017-7-19 20:21
回复

使用道具 举报

梦石
0
星屑
19426
在线时间
3082 小时
注册时间
2013-1-11
回帖
1207
发表于 2017-7-19 20:23:10 | 显示全部楼层
Project1.7z (182.46 KB, 下载次数: 109)


我测试好像没问题。。。

点评

之前不知道是怎么回事,现在可以了,感谢  发表于 2017-7-19 20:29
回复

使用道具 举报

梦石
1
星屑
24088
在线时间
3339 小时
注册时间
2011-7-8
回帖
3862

开拓者

发表于 2017-7-20 00:55:48 | 显示全部楼层
是不是你用记事本打开之后,默认以ANSI格式存储了?另存为的时候换成无BOM头的UTF-8试试看,或者用别的软件打开txt。

评分

参与人数 1星屑 +150 收起 理由
RyanBern + 150 我很赞同

查看全部评分

熟悉rgss和ruby,xp区版主~
正在填坑:《膜拜组传奇》讲述膜拜组和学霸们的故事。
已上steam:与TXBD合作的Reformers《变革者》
* 战斗调用公共事件 *
* RGSOS 网络脚本 *
回复

使用道具 举报

路人党员

梦石
0
星屑
52
在线时间
2276 小时
注册时间
2010-12-30
回帖
3011
发表于 2017-7-20 14:19:35 | 显示全部楼层
本帖最后由 英顺的马甲 于 2017-7-20 14:22 编辑

事实上只要保存为UTF8然后手动移除BOM就行了,要不然就把第一行放空然后从第二行开始读取(多功能字幕滚动用的方法)
  1. # 移除BOM的脚本
  2. wchars= File.read("BOM测试.txt").unpack("U*")
  3. wchars.shift if wchars[0] == 0xFEFF
  4. p wchars.pack("U*")
复制代码

下面这是3楼转码的改版,供参考
  1. class String
  2.   CP_ACP = 936 # GB2312
  3.   M2W = Win32API.new('kernel32', 'MultiByteToWideChar', 'ilpipi', 'i')
  4.   def gb2312_to_utf8
  5.     n = self.unpack("C*").size # 为了避免任何出错的可能性
  6.     i = M2W.call(CP_ACP, 0, self, n+1, nil, 0)
  7.     buffer = ([0]*(i)).pack("S*")
  8.     M2W.call(CP_ACP, 0, self, n+1, buffer, i)
  9.     # 直接用ruby自带的pack和unpack
  10.     buffer = buffer.unpack("S*")
  11.     buffer.pop
  12.     return buffer.pack("U*")
  13.   end
  14. end
复制代码

评分

参与人数 1赞 +1 收起 理由
574656549 + 1 认可答案

查看全部评分

本人擅长XP,如果有脚本或者Ruby方面的问题欢迎发电邮到engshun@1ppl.me咨询,本人很少检查电邮所以不一定会及时回复,本人不会直接出手解决问题只会提供一个方向,所以谢绝伸手党
回复 1 0

使用道具 举报

您需要登录后才可以回帖 登录 | 注册会员

本版积分规则

Powered by Discuz! X5.0 © 2001-2026 Discuz! Team.

在本版发帖返回顶部