| 赞 | 0 |
| VIP | |
| 好人卡 | |
| 积分 | 4 |
| 经验 | |
| 最后登录 | 2020-7-11 |
| 在线时间 | 1245 小时 |
狂気の月兔
- 梦石
- 0
- 星屑
- 421
- 在线时间
- 1245 小时
- 注册时间
- 2009-4-7
- 回帖
- 866

|
 发表于 2013-9-4 21:07:30
|
显示全部楼层
暂时命名2
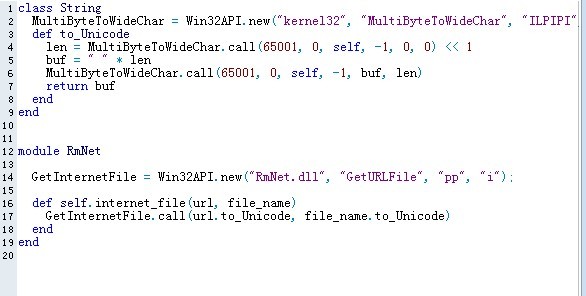
一个 dll , 放进 VX 里, 然后丢进去下面的脚本:
[pre lang="ruby" line="1"]
class String
MultiByteToWideChar = Win32API.new("kernel32", "MultiByteToWideChar", "ILPIPI", "I")
def to_Unicode
len = MultiByteToWideChar.call(65001, 0, self, -1, 0, 0) << 1
buf = " " * len
MultiByteToWideChar.call(65001, 0, self, -1, buf, len)
return buf
end
end
#//////////////////////////////////////////
module RmNet
GetInternetFile = Win32API.new("RmNet.dll", "GetURLFile", "pp", "i");
def self.internet_file(url, file_name)
GetInternetFile.call(url.to_Unicode, file_name.to_Unicode)
end
end[/pre]
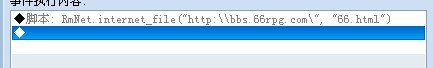
然后在任意地方调用. 方法如下:
RmNet.internet_file(要打开的网址, 要保存下来文件名)
比如:
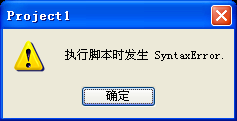
RmNet.internet_file("http:\\rpg.blue\", "66.html")
可能在读取编码上会出现乱码, 主要的问题是如果网页是 UTF-8 编码的话, 就会出现这些问题. 不过只要不涉及中文就好. 有空再改改. |
评分
-
查看全部评分
|


 写轮眼

 再次提问一下,怎么获取网页上的第一行内容呢?

 提升卡
 沉默号角
 喧嚣号角
 变色卡
 升龙剑