| 赞 | 402 |
| VIP | |
| 好人卡 | |
| 积分 | 251 |
| 经验 | |
| 最后登录 | 2024-7-2 |
| 在线时间 | 3339 小时 |
- 梦石
- 1
- 星屑
- 24088
- 在线时间
- 3339 小时
- 注册时间
- 2011-7-8
- 回帖
- 3862

|
楼主 |
发表于 2018-10-20 23:58:31
|
显示全部楼层
本帖最后由 guoxiaomi 于 2018-10-30 15:52 编辑
先放一个利用强化学习生成卡牌游戏《Card of Spirits》的例子:https://gitlab.com/gxm/rl-cos
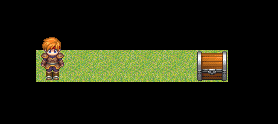
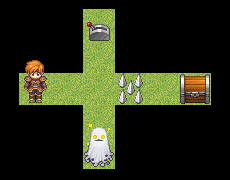
使用遗传算法来完成阿尔西斯找宝藏的游戏,因为numpy库对科学计算的良好支持,所以这里用python来写。首先,需要构造一个环境:env.py,里面构造了4个地图,难度依次提升。
具体代码见这里:https://gitee.com/rmxp/codes/x35j704ycudg9va62bmzw30
图中,S=起点,T=陷阱,C=宝箱,M=怪兽,L=开关,+=墙壁,.=通道
[pre lang="python"]
class FindChest:
MAP01 = [
'+++++++++',
'++++L++++',
'++++.++++',
'+S...T.C+',
'++++.++++',
'++++M++++',
'+++++++++'
]
MAP02 = [
'+++++++++',
'+++L..+M+',
'++++.++.+',
'+S...T..+',
'++++.++.+',
'++++M++C+',
'+++++++++'
]
MAP03 = [
'+++++++++',
'++L....M+',
'++++.++.+',
'+S...T..+',
'++++.++.+',
'++++M++C+',
'+++++++++'
]
MAP04 = [
'+++++++++',
'++L....M+',
'++++.++.+',
'+S....T.+',
'+.++.++.+',
'+....M+C+',
'+++++++++'
]
[/pre]
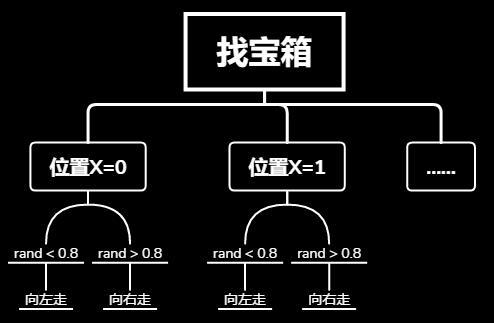
设定的策略参数为在 (x, y) 处,当开关的状态 s={0, 1} 时,切换横、竖行走方向的概率(1-p0)和向左(如果沿x轴)、下(如果沿y轴)方行走的概率p1。这样就把原先离散的选择X方向行动改成了连续的概率取值。这个参数可以用 9x6x2x2 的实数矩阵表示。
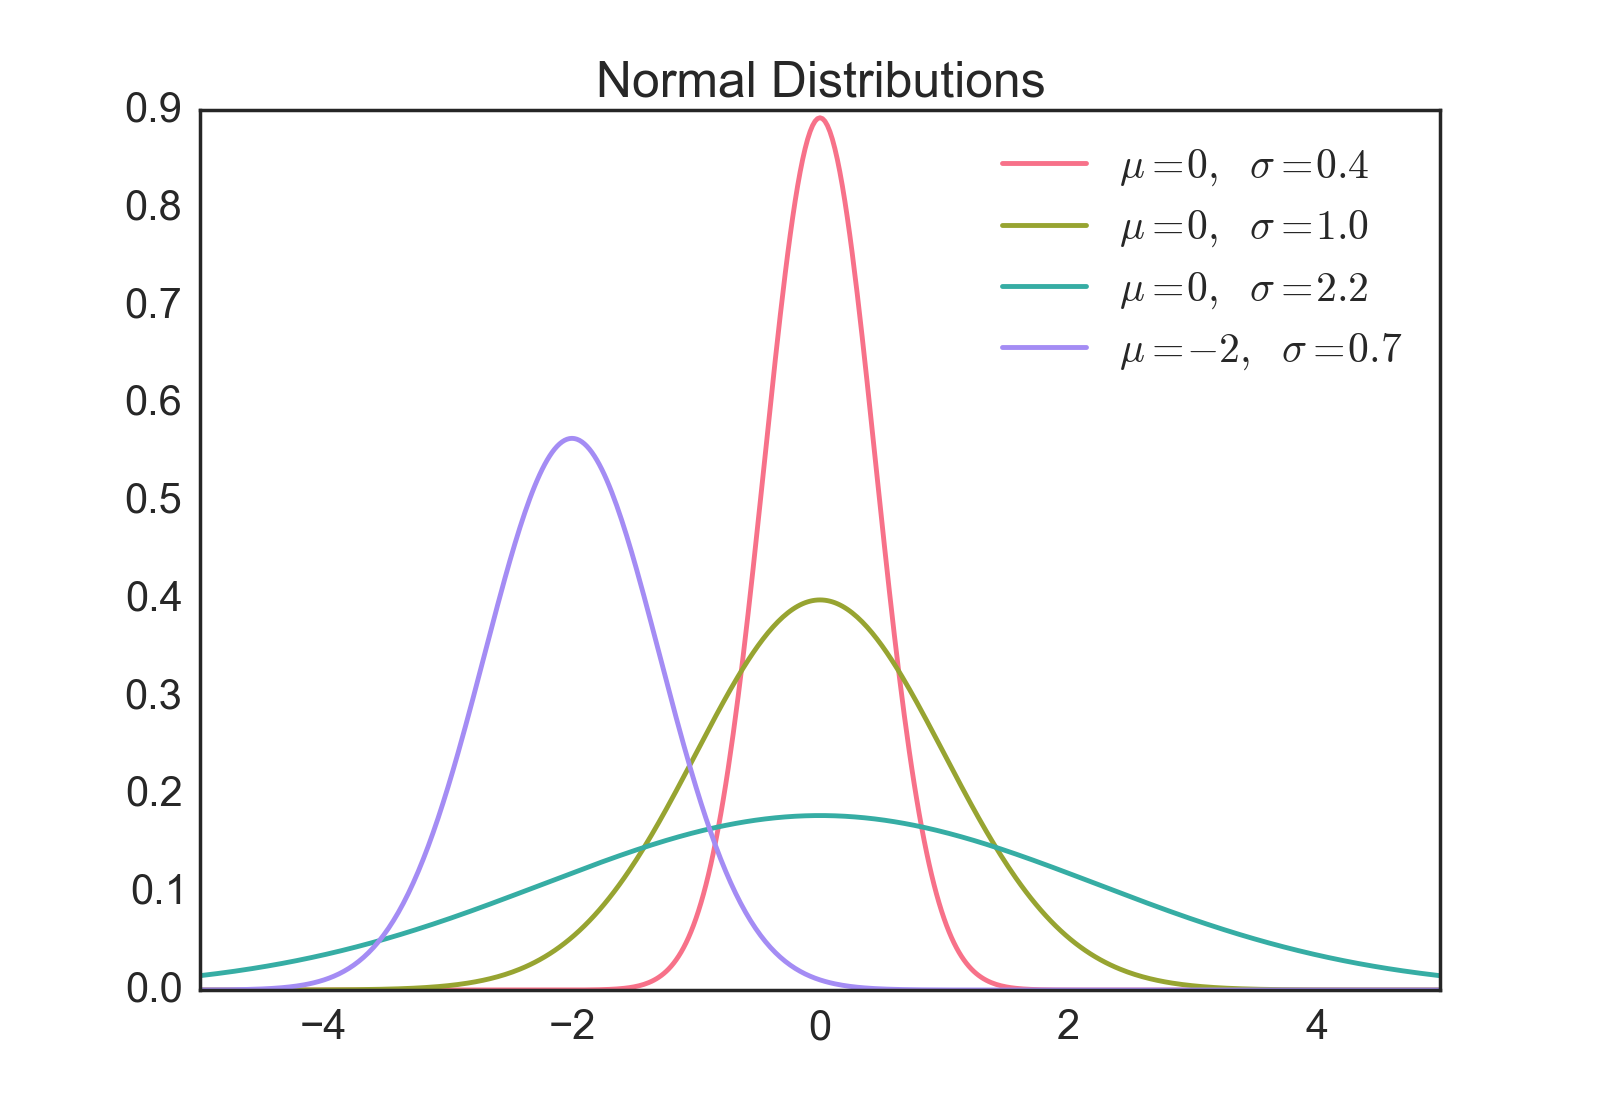
无理由假定最优策略以及次优策略的参数满足某个高斯分布,接下来用遗传算法来优化参数。
找宝箱策略
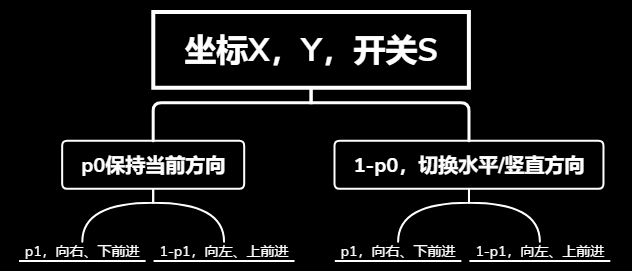
进行如下操作:
1. 随机初始化参数矩阵里的每一个值,取平均值=0.5,标准差=0.5
2. 用这样的平均值和标准差制作100个agent,每个agent尝试1000次,统计成功的次数作为得分
3. 取出分数最高的10个agent,计算这10个agent的参数矩阵的平均值和标准差
4. 回到2继续迭代,直到策略收敛(这里是成功率超过0.99,或者迭代次数超过100)
对于最复杂的地图4,可以看到:
1. 8 次迭代后,遗传算法出现了第一批能成功得分的agent
2. 13 次迭代后,遗传算法得到了得分超过0.5的agent,并且优化的速度非常快
3. 25 次迭代后,得到了超过0.99分的agent
[pre lang="matlab"][0. 0. 0. 0. 0. 0. 0. 0. 0. 0.]
[0. 0. 0. 0. 0. 0. 0. 0. 0. 0.]
[0.003 0. 0. 0. 0. 0. 0. 0. 0. 0. ]
[0. 0. 0. 0. 0. 0. 0. 0. 0. 0.]
[0.001 0. 0. 0. 0. 0. 0. 0. 0. 0. ]
[0.001 0. 0. 0. 0. 0. 0. 0. 0. 0. ]
[0.007 0.007 0. 0. 0. 0. 0. 0. 0. 0. ]
[0.005 0.002 0.002 0.001 0.001 0.001 0. 0. 0. 0. ]
[0.09 0.041 0.036 0.024 0.021 0.017 0.015 0.009 0.009 0.008]
[0.175 0.11 0.102 0.1 0.09 0.078 0.076 0.074 0.072 0.071]
[0.285 0.278 0.254 0.252 0.216 0.213 0.197 0.186 0.173 0.169]
[0.416 0.374 0.356 0.35 0.344 0.323 0.315 0.313 0.293 0.292]
[0.542 0.531 0.514 0.503 0.49 0.474 0.471 0.47 0.464 0.454]
[0.622 0.618 0.616 0.603 0.597 0.594 0.591 0.586 0.584 0.578]
[0.783 0.766 0.739 0.728 0.722 0.717 0.713 0.709 0.699 0.697]
[0.864 0.833 0.826 0.818 0.816 0.803 0.799 0.797 0.796 0.791]
[0.897 0.883 0.882 0.878 0.873 0.871 0.865 0.863 0.858 0.852]
[0.927 0.926 0.926 0.926 0.925 0.911 0.91 0.909 0.907 0.907]
[0.947 0.946 0.945 0.939 0.936 0.936 0.935 0.934 0.929 0.926]
[0.974 0.969 0.965 0.964 0.961 0.961 0.959 0.957 0.956 0.956]
[0.984 0.979 0.977 0.977 0.975 0.975 0.974 0.974 0.973 0.973]
[0.984 0.983 0.982 0.982 0.981 0.981 0.981 0.981 0.978 0.977]
[0.985 0.985 0.984 0.983 0.982 0.982 0.982 0.982 0.982 0.981]
[0.99 0.988 0.987 0.986 0.985 0.985 0.985 0.985 0.984 0.984]
[0.991 0.99 0.989 0.988 0.987 0.986 0.986 0.985 0.985 0.985][/pre]
遗传算法并不稳定,可能陷入局部极小值。
为了训练出>0.99分的agent,总共进行了25*100*1000 ~ 10^6 局游戏。这一数据可以与其他的机器学习方法比较。
对于找宝藏的游戏,利用“专家知识”可以选择出合适的特征和决策方案,进而使用遗传算法筛选出得分高的agent。
对于传统的RPG游戏,自然也可以利用专家知识预设好概率性的决策方案,并留下大量的(连续)参数供调整,比如:
1. 在生命低于x的时候有y的概率攻击
2. 有x的概率选择生命值最多的目标
3. 队友生命值低于x的时候有y的概率治疗
等等……
然后构造不同的测试条件,使用上面的方法测试agent的能力,淘汰得分低的agent,不断迭代获得最优的待定参数。
其优点为:训练思路简单粗暴,充分利用专家知识
|
评分
-
查看全部评分
|



 写轮眼

 发表于 2018-10-20 22:03:19


 提升卡
 沉默号角
 喧嚣号角
 变色卡
 升龙剑


 发表于 2018-10-21 11:48:54


 发表于 2018-10-31 10:01:02
 专业性比较强了,但还是希望可以帮到一些需要的朋友
 RGDirect -